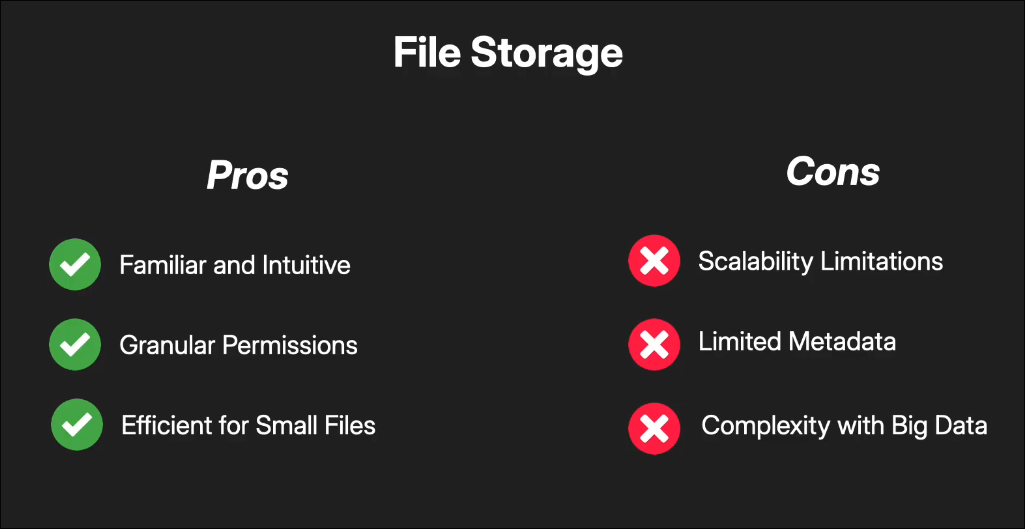
对象存储(Object Storage)
定义:将文件与其描述信息(元数据)打包成一个独立的“对象”,分配唯一标识符(Key),通过网络协议(如 HTTP/HTTPS API)进行存取的扁平化分布式存储方法。常见服务有 AWS S3、阿里云 OSS、MinIO 等。
特点(Pros):
- 高度可扩展(Highly scalable):采用扁平化结构,摆脱了单机硬盘的物理容量限制,可以轻松无缝地扩展到 PB 甚至 EB 级别的海量存储。
- 丰富的元数据(Rich metadata):每个文件都自带详细的“自我介绍”标签(如作者、权限、自定义分类),极大地方便了数据的检索、分类和自动化管理。
- 海量数据极具性价比(Cost-Effective for Big Data):存储成本极低,天然支持大文件分片上传与多副本容灾,是大数据、视频、冷备份的理想存储媒介。
缺点(Cons):
- 不适合高频读写的小文件(Less Suitable for Small Files):由于每次读写都要走网络请求(HTTP),如果用来高频读写大量几 KB 的小文件,网络开销会非常大,效率低下。
- 没有文件层级结构(No File Hierarchy):没有传统的“文件夹/目录树”概念,所有文件都在一个扁平的池子里,必须通过唯一标识符(URL/Key)或元数据直接定位。
- 部分操作延迟较高(Higher Latency for Some Ops):网络传输导致其响应速度无法与本地硬盘相比。且对象是“不可变”的,无法像传统文件那样进行局部修改(改一个字节也需要重新上传或合并覆盖),导致部分写操作延迟较高。
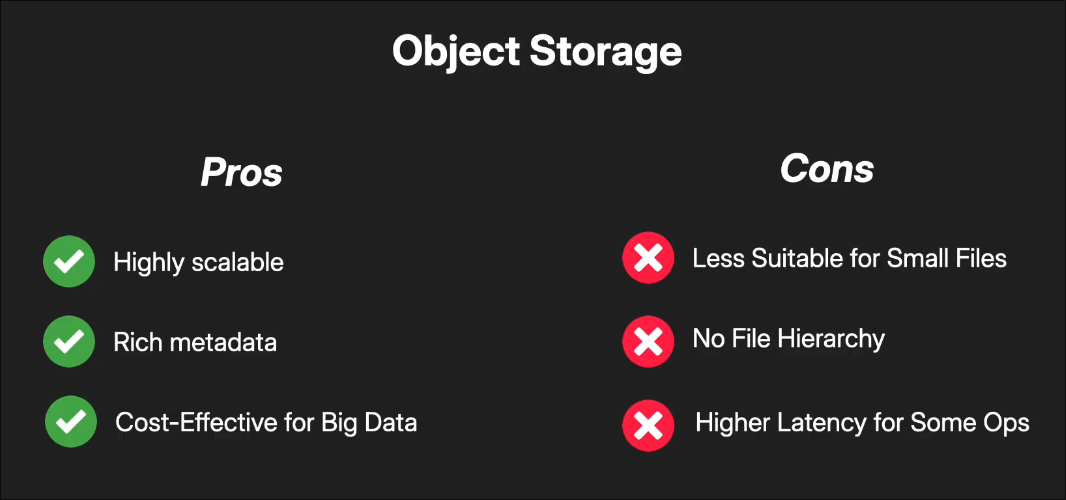
文件存储(File Storage)
定义:基于树状目录结构(文件夹套文件夹)来组织和管理数据的传统存储方法。既包括本地文件系统(如 Windows 的 NTFS、Linux 的 ext4),也包括网络共享文件系统(如 NFS、SMB/Samba)。
特点(Pros):
- 直观的路径查找:数据按“目录树”层级结构组织,可沿路径轻松定位,非常符合人类的日常整理和使用习惯。
- 支持高频随机读写:允许对文件进行局部修改(例如只修改 10GB 文件中的某一个字节),非常适合需要频繁读写、修改的系统文件和应用数据。
- 权限划分精细:拥有成熟、细粒度的系统级权限控制(如读、写、执行权限),保障数据安全。
缺点(Cons):
- 物理扩展性有限:存储容量受限于单台服务器或硬件阵列的物理上限,无法像对象存储那样无限制扩容。
- 文件数量受限:受限于底层的索引机制(如 Linux 的 Inode)。当文件数量达到千万或亿级时,查找速度会急剧下降,甚至导致系统卡死。
- 超大文件管理困难:对于 TB 级以上的超大文件(如视频源文件、大型备份包),存在存储装不下、网络传输易中断、备份成本极高的问题。