在开始之前可以先看看这个,梳理一下计算机网络大概的知识框架:计算机网络知识大纲
基本概念
计算机网络非常重要,是 408 当中最容易感知和体验的一门学科,甚至在直观性上超过操作系统。
在一般的软件开发中,计算机网络相关知识是必备基础,尤其是应用层、运输层和网络层的常见协议,经常在面试中被考察。
在 408 中,计算机网络整体难度相对较低,其知识体系不像数据结构那样依赖严格的数学推导,也不像计算机组成原理那样涉及复杂的硬件细节。其核心内容是各种网络协议,这些协议来源于长期工程实践和不断优化,在具备一定理论基础的同时,更强调机制设计与实际应用。
在计算机网路的基础上,后来诞生了分布式,计算机网络要做的事是:让多台不同的计算机可以相互通信。 而要做到这一点就要求所有的计算机通行必须遵守相同的规范,因此而诞生了协议,并且大家都会遵守一些标准的协议。有了通信以后,才有了互相协作,分布式就是不仅想让计算机之间互相通信,还想让计算机之间互相协作完成一个任务,这涉及到更多的知识,但是并不是计算机网络这门课研究的内容。
基本概念里面,主要会了解一些计算机网路里面最容易、最核心、最基本的知识,还会了解一下常见的网络设备,顺带发散一下,将计算机网络的知识铺开。
网络参考模型
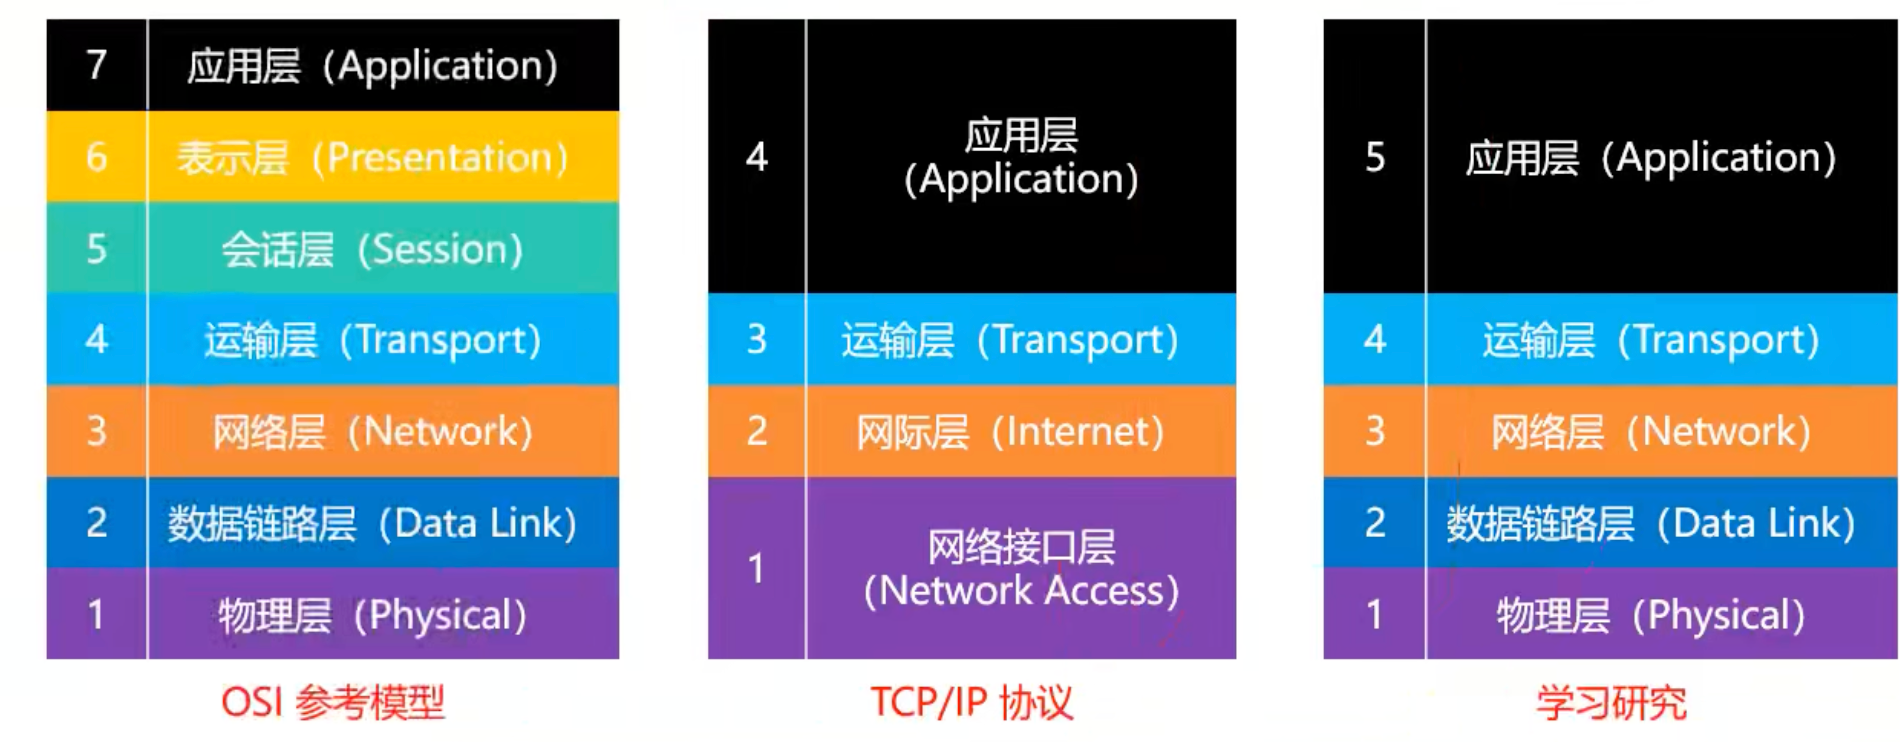
主流的网络参考模型有两种,一种是由国际标准组织 ISO 于 1985 年提出的 OSI 网络互联模型,一种是业界广泛认可和接受的实际上的网络参考模型——TCP/IP 参考模型。
但是 408 为了更好的研究计算机网络,结合了 OSI 和 TCP/IP 重新划分了五层模型,这确实是更加合理的为了学习研究的划分方式,将数据链路层和物理层单独拿出来分析,这也体现了 408 依旧对硬件和低层次的抽象非常看重的特点。
笔记内容本身就是 408 中的计算机网络,所以笔记将按照五层模型进行组织。
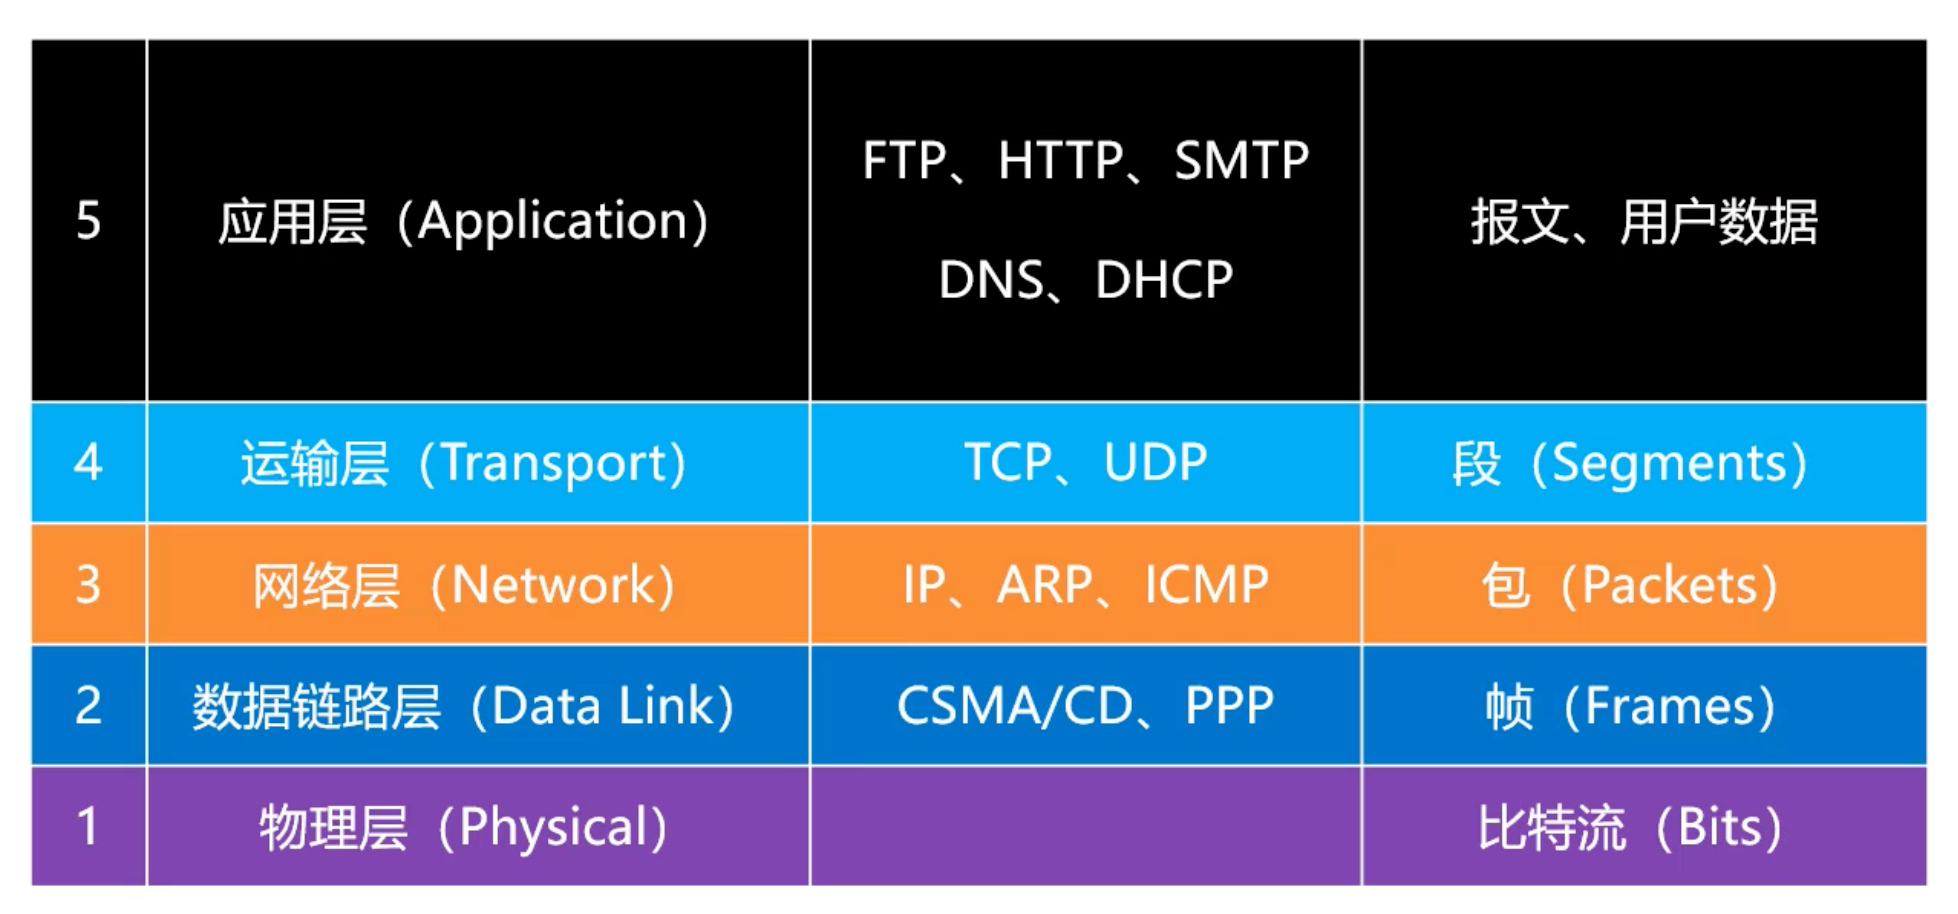
通过这样一张图我们可以大致了解每一层有什么主要的网络协议:
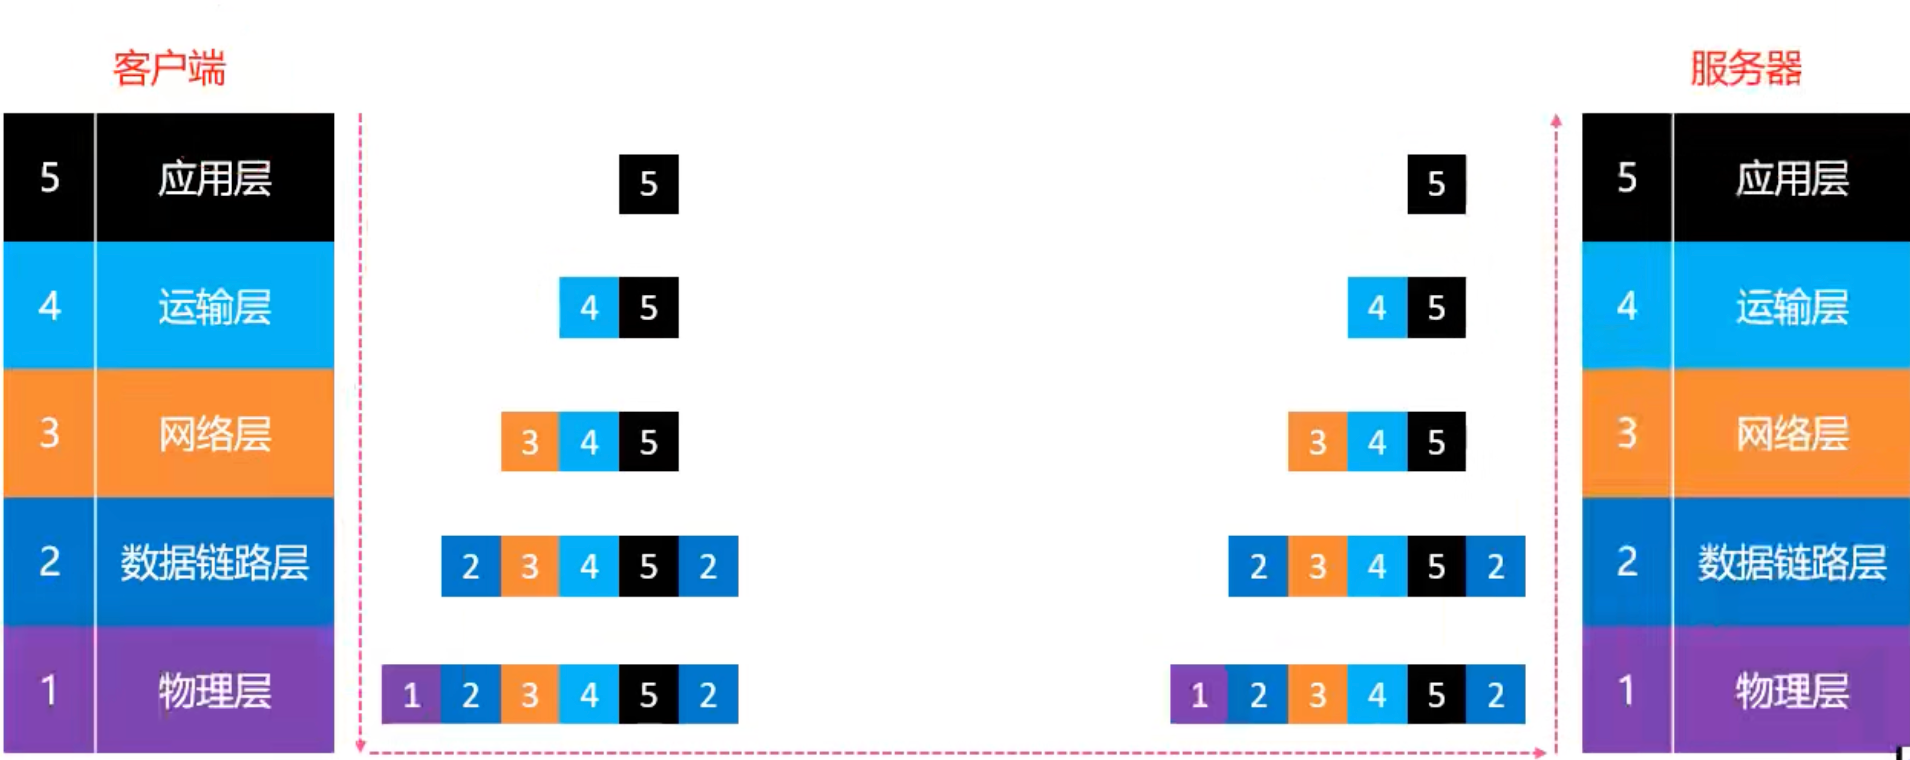
请求过程
有了网络常考模型,我们就能更好地研究计算机通信,下面这张图非常好地解释了这一过程:
客户端与服务器
在计算机网络的基础之上,我们可以让服务器给客户端提供服务,中间使用计算机网络进行通信,而客户端与服务器的交互过程大概是这样的:
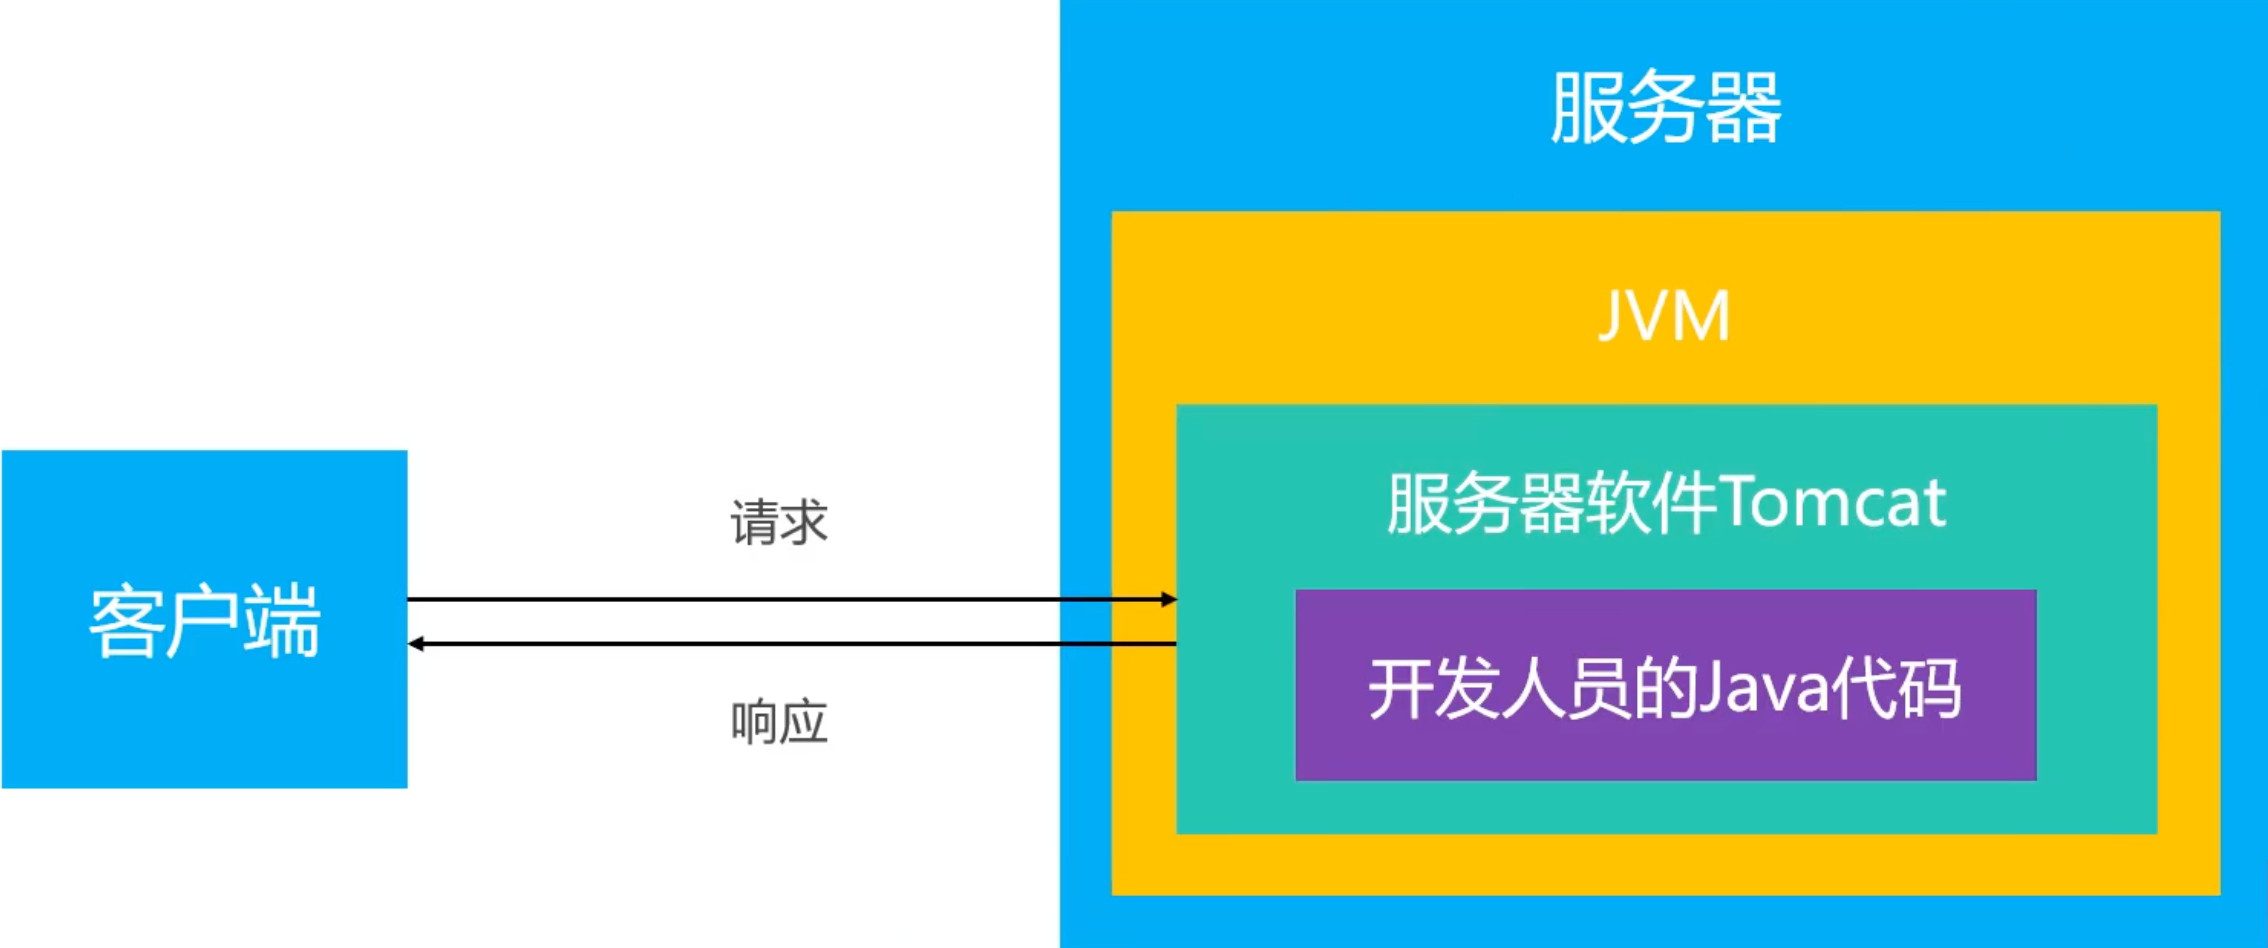
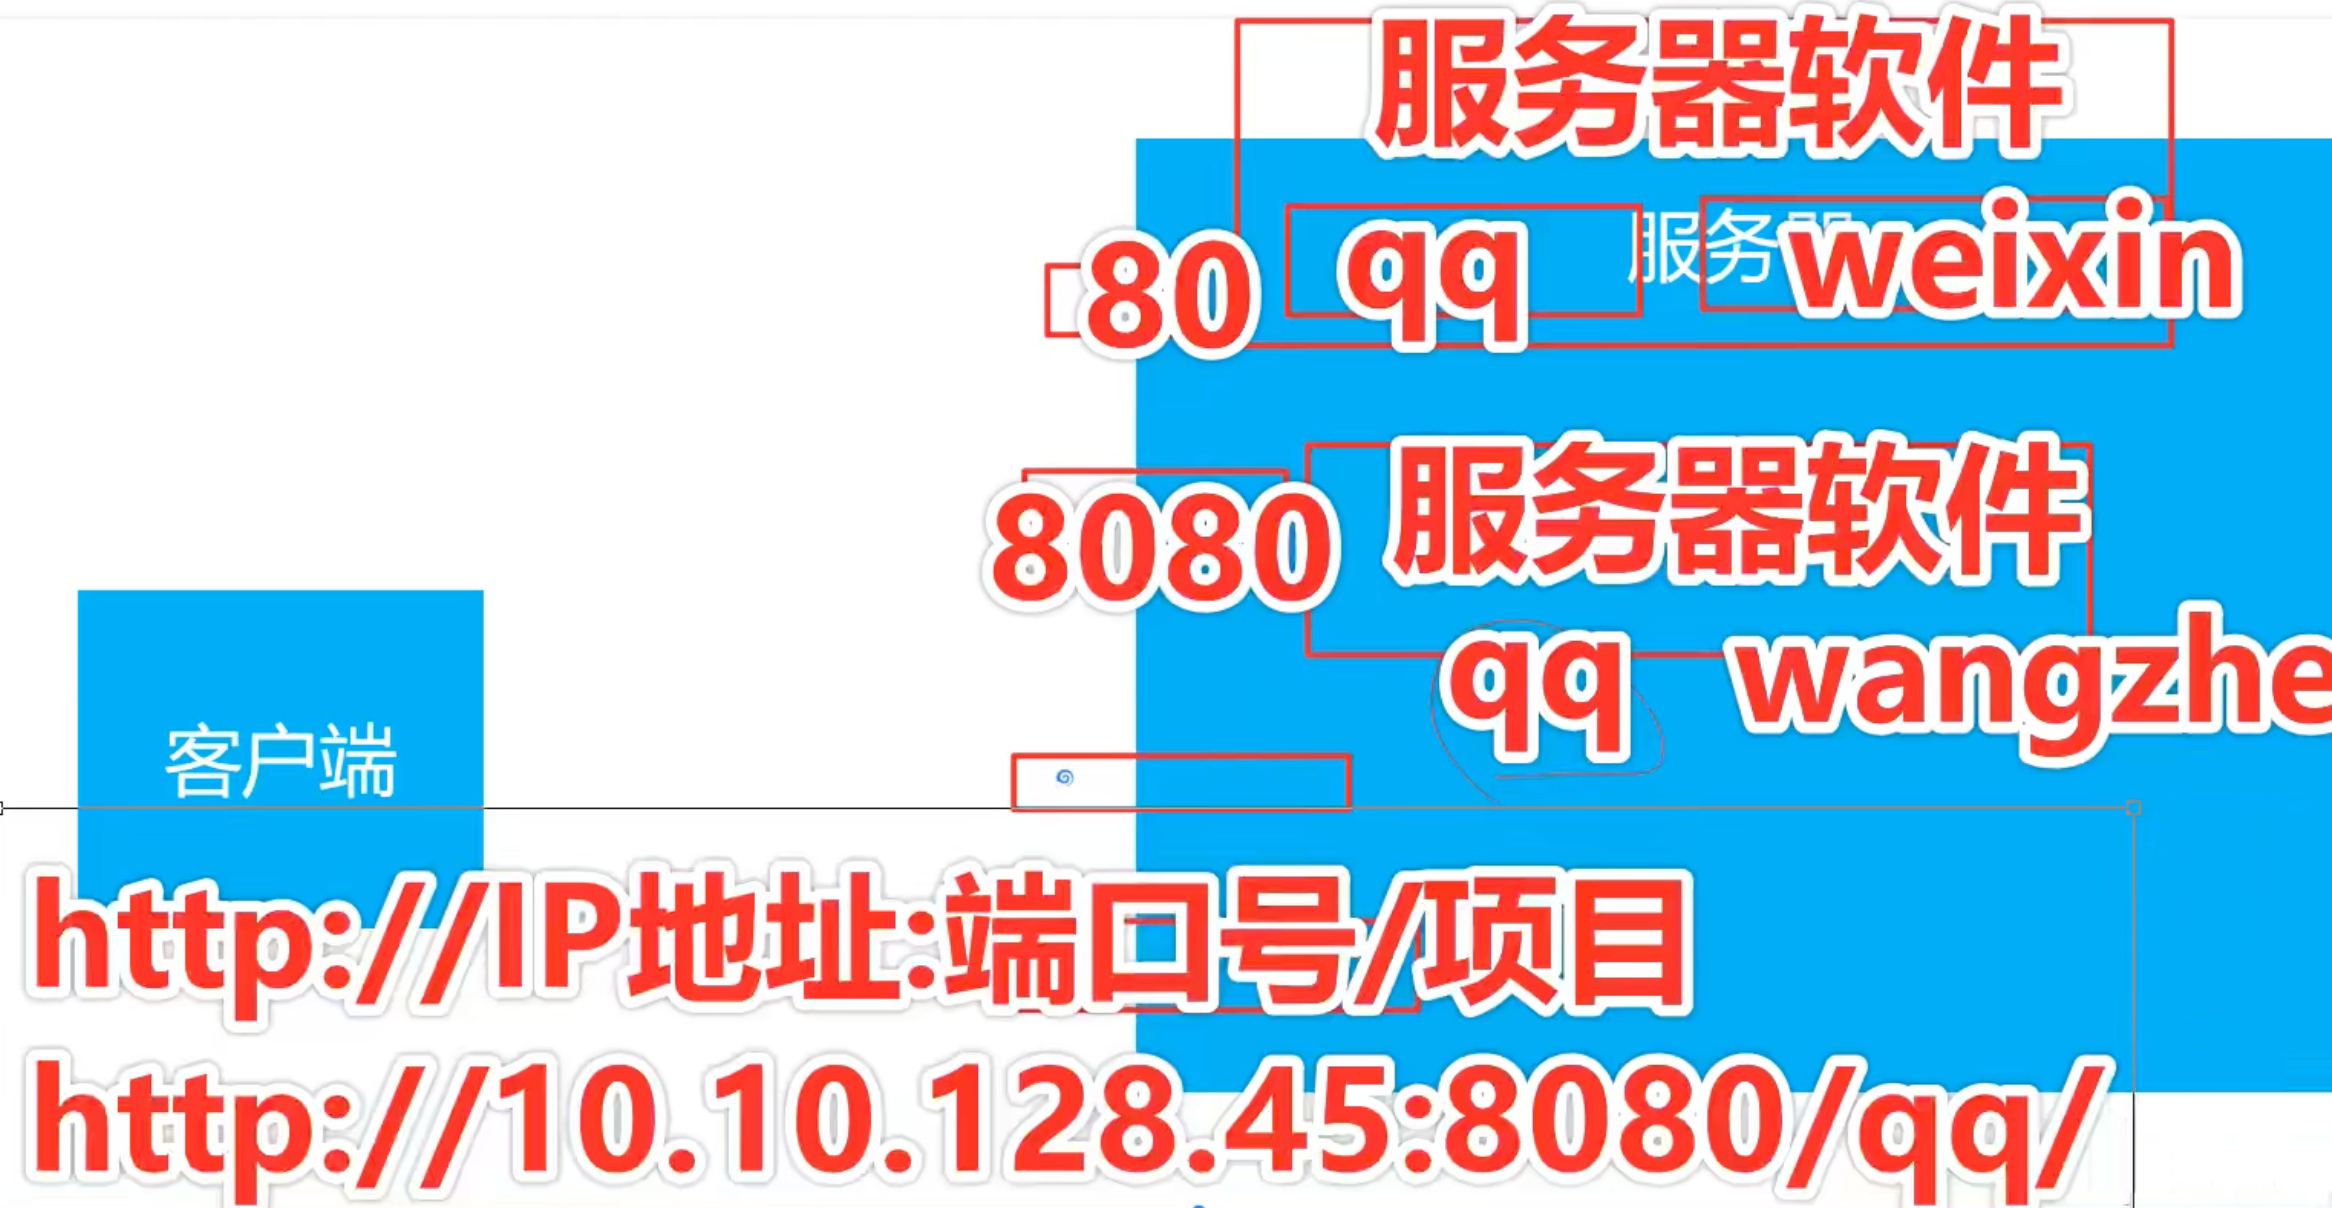
可划算想要访问服务器资源可以简单理解成这样:
计算机之间的通信基础
计算机之间是如何进行通信的呢?
简单来说就是:首先应该先知道目标计算机的 IP 地址,最终要根据 MAC 地址(网卡地址)将数据输送到目标计算机网卡上,网卡在拿到数据以后首先会判断数据的目标 MAC 地址是不是自己,如果是自己,网卡会把接收到的数据传递给上一层进行处理,如果数据的目标 MAC 地址不是自己,网卡就会直接将数据丢弃,不会传递给上一层。
这一切都是发生在计算机连接起来以后,计算机有多种连接方式,有了连接,才可以有通信。
通信模式
通信分为三种模式:单工、半双工和全双工,它们很好理解:
- 单工通信就是:单向传输,不可逆。 数据只能从一端(发送端)向另一端(接收端)单向传输,接收端无法向发送端反馈数据,传输方向完全固定不可逆。单工通信仅需1条单向通信信道,无需切换传输方向;实现简单、硬件/软件成本低;通信效率有限,仅能满足“单向数据推送”需求。
- 半双工通信就是:双向传输,但不同时。 数据可在两端之间双向传输(A→B 或 B→A),但 同一时间只能进行一个方向的传输,需通过切换传输方向实现双向通信,类似“轮流说话”。仅需1条共享通信信道,通过“信道方向切换”实现双向传输;存在传输延迟(切换方向耗时),通信效率中等;需约定传输规则(如“谁先发送、发送完毕后释放信道”),避免发送/接收冲突。
- 全双工通信:双向传输,可同时。 数据可在两端之间双向传输,且两个方向的传输可同时进行,类似“两个人同时说话并互相听见”,双向传输互不干扰。需2条独立的单向信道(一条A→B,一条B→A),无需切换传输方向;双向同时传输,通信效率最高,无传输冲突;实现成本高于单工、半双工,需支持双向并发传输的硬件/软件设计。
计算机之间的连接方式
1-网线直连
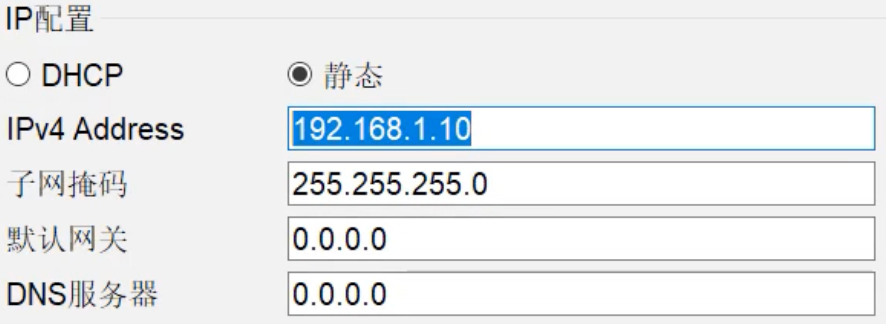
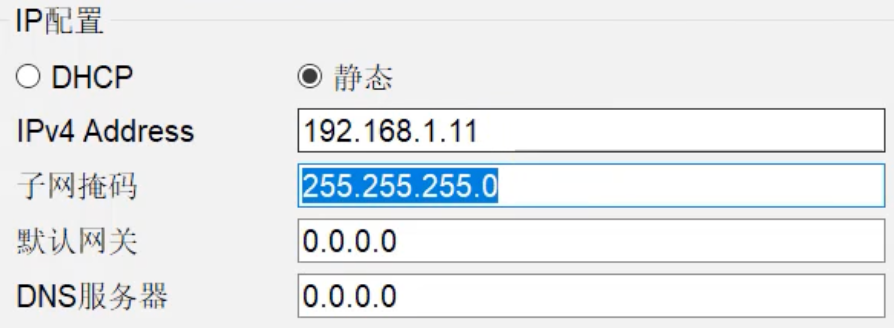
如果我和我的室友各有一台电脑,我的宿舍没有 WIFI,每台计算机都分配了 IP 地址。
这是我的配置:
这是我室友的配置:
我想和室友一起联机玩MC,有什么办法呢?我发现我的手里有一根铜交叉线(现在大多数设备(电脑网卡、5-路由器、4-交换机)都支持Auto MDI-X自动翻转,这意味着:设备可以自动识别并调整发送/接收,所以普通直通网线(Straight-through cable)也能直接连接两台电脑),我就可以使用这根铜交叉线,直接把两台计算机连接在一起:
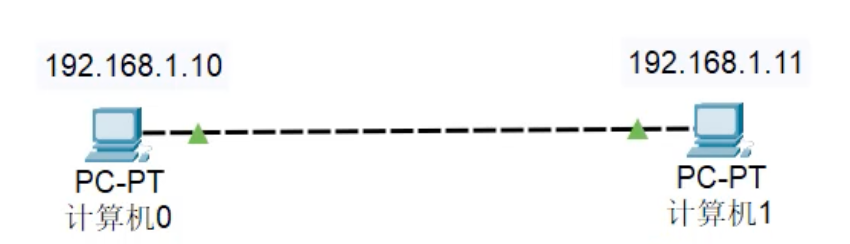
连好以后,我需要测试这两台电脑能否正常通信,很简单的办法就是,我让我室友的电脑 Ping 一下我的电脑,我发现结果是:
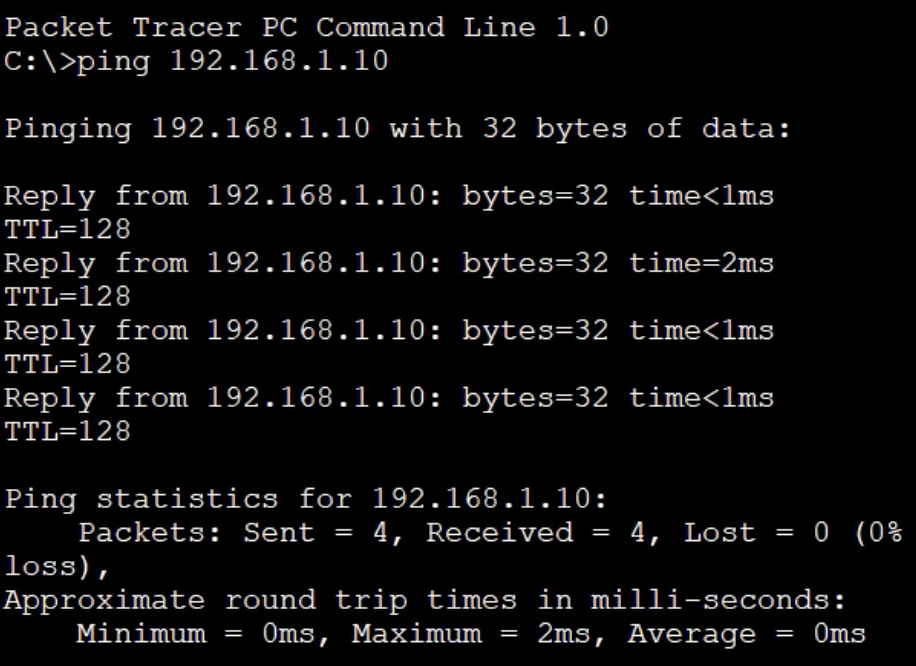
这说明两台电脑是可以互相通信的,可以开始玩游戏了。
同轴电缆
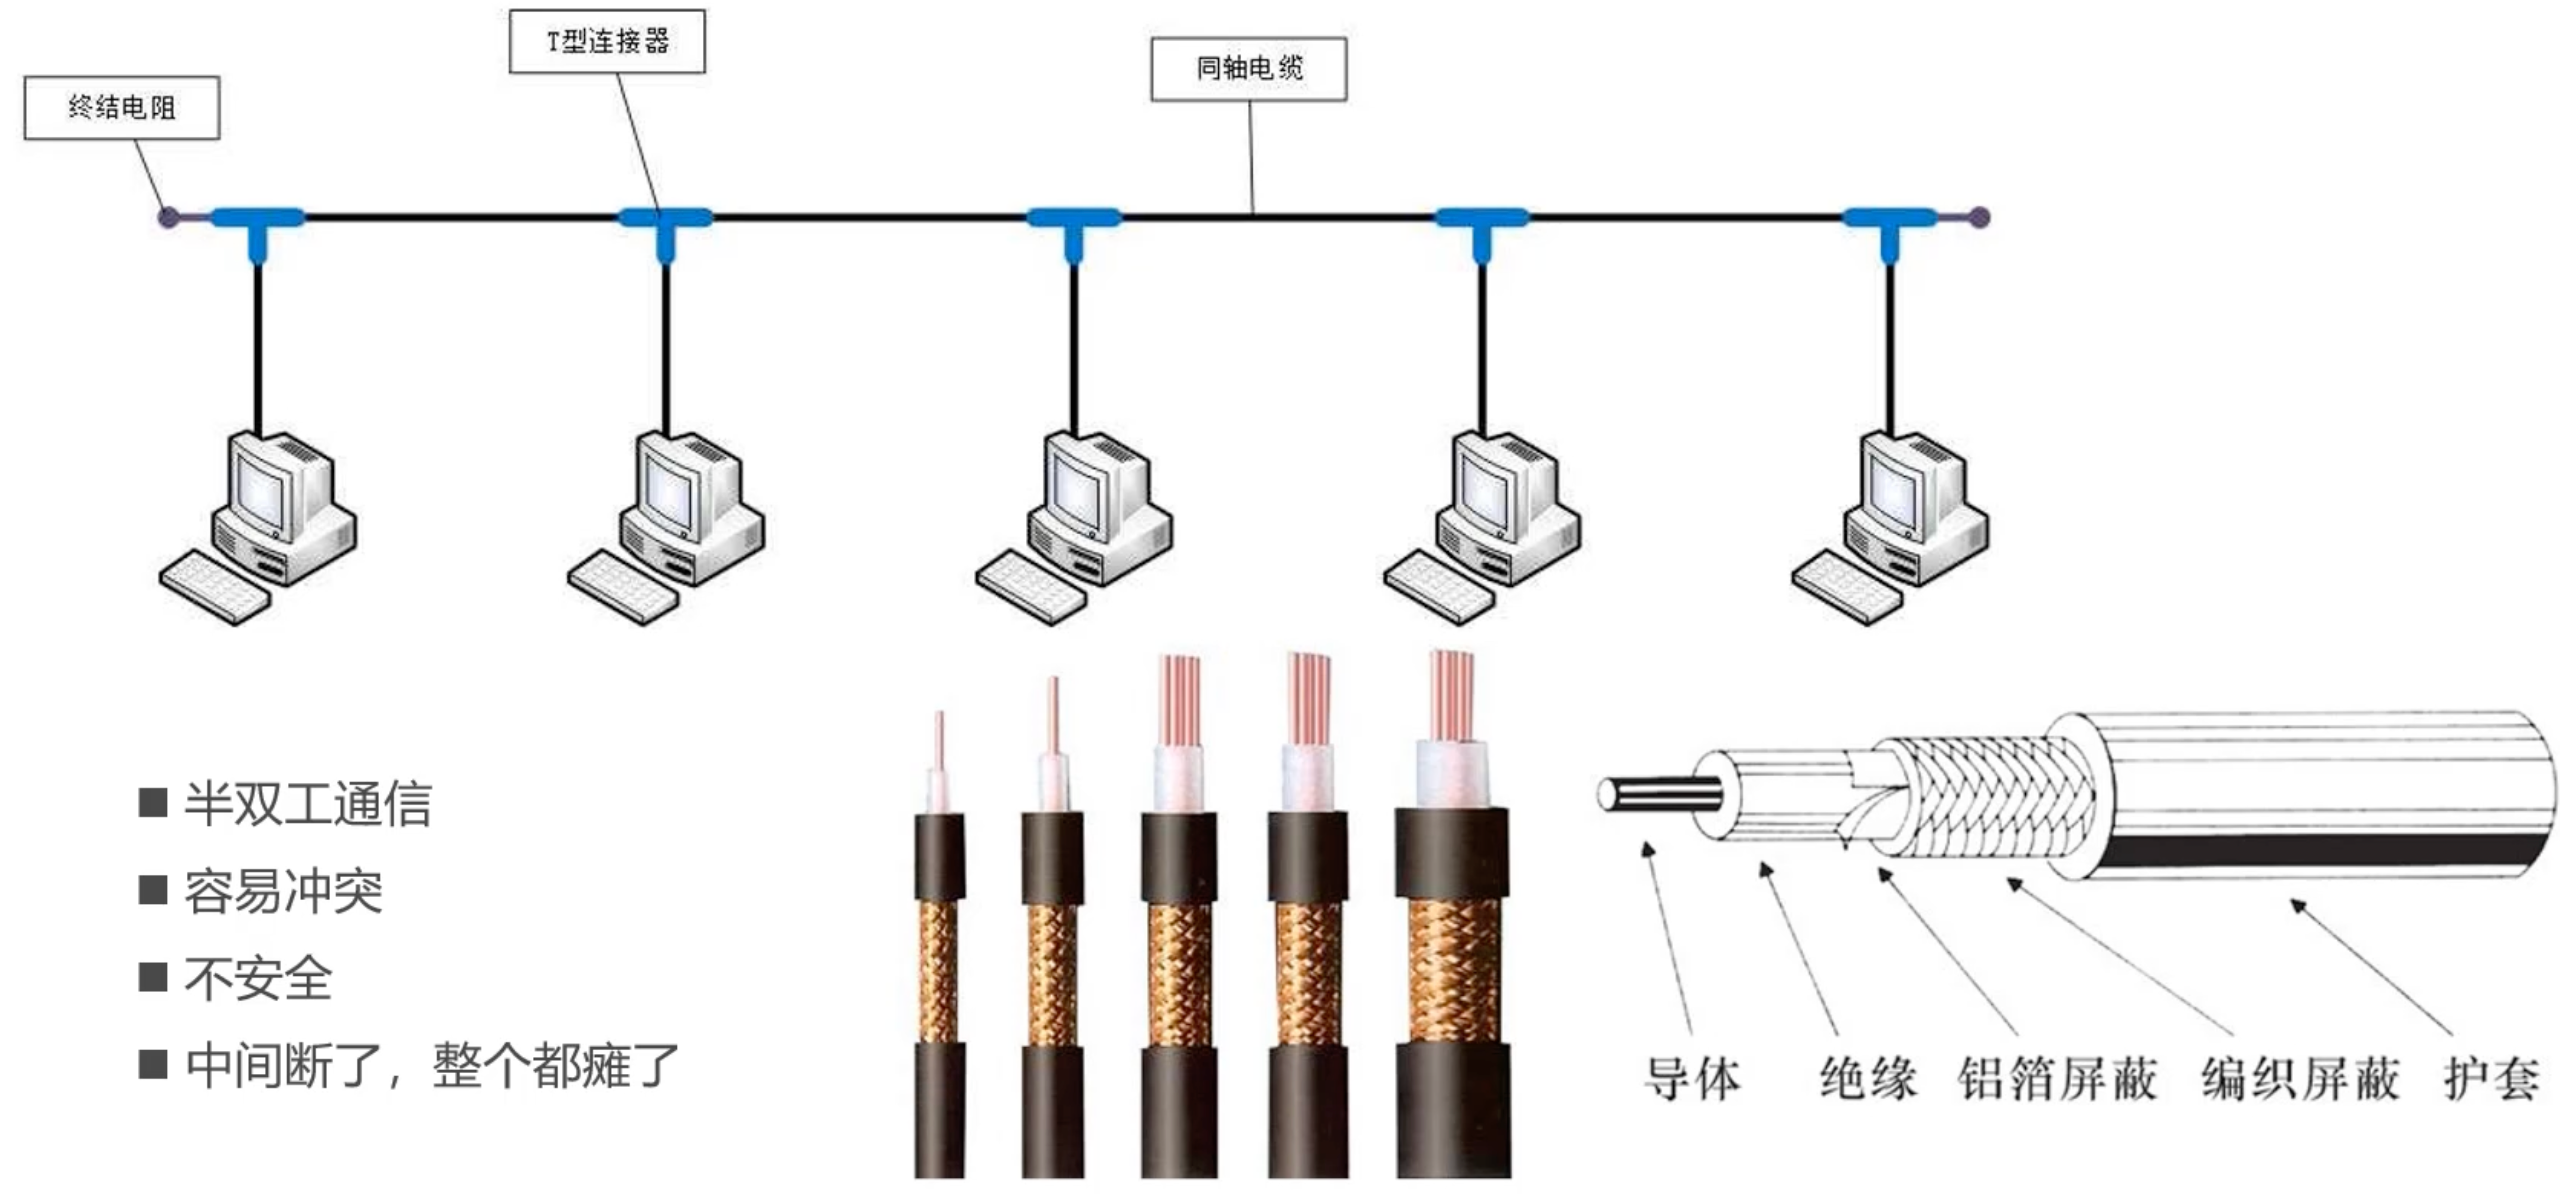
假如有更多室友也想加入我们的游戏那使用简单的1-网线直连就不太行了,我们每台电脑只有一个网口,没法插多根网线,这个时候可以考虑同轴电缆,但是同轴电缆是半双工通信,是一种效率非常低的通信方式,并且同轴电缆同一时刻只能允许一台设备发数据,否则就会出现冲突,这意味着如果使用同轴电缆就会 扩大冲突域,而且如果电缆上的一个设备出问题了,整个系统没法通信,这显然不是我们想要的,想玩游戏,这也太不合适了。
3-集线器(Hub)
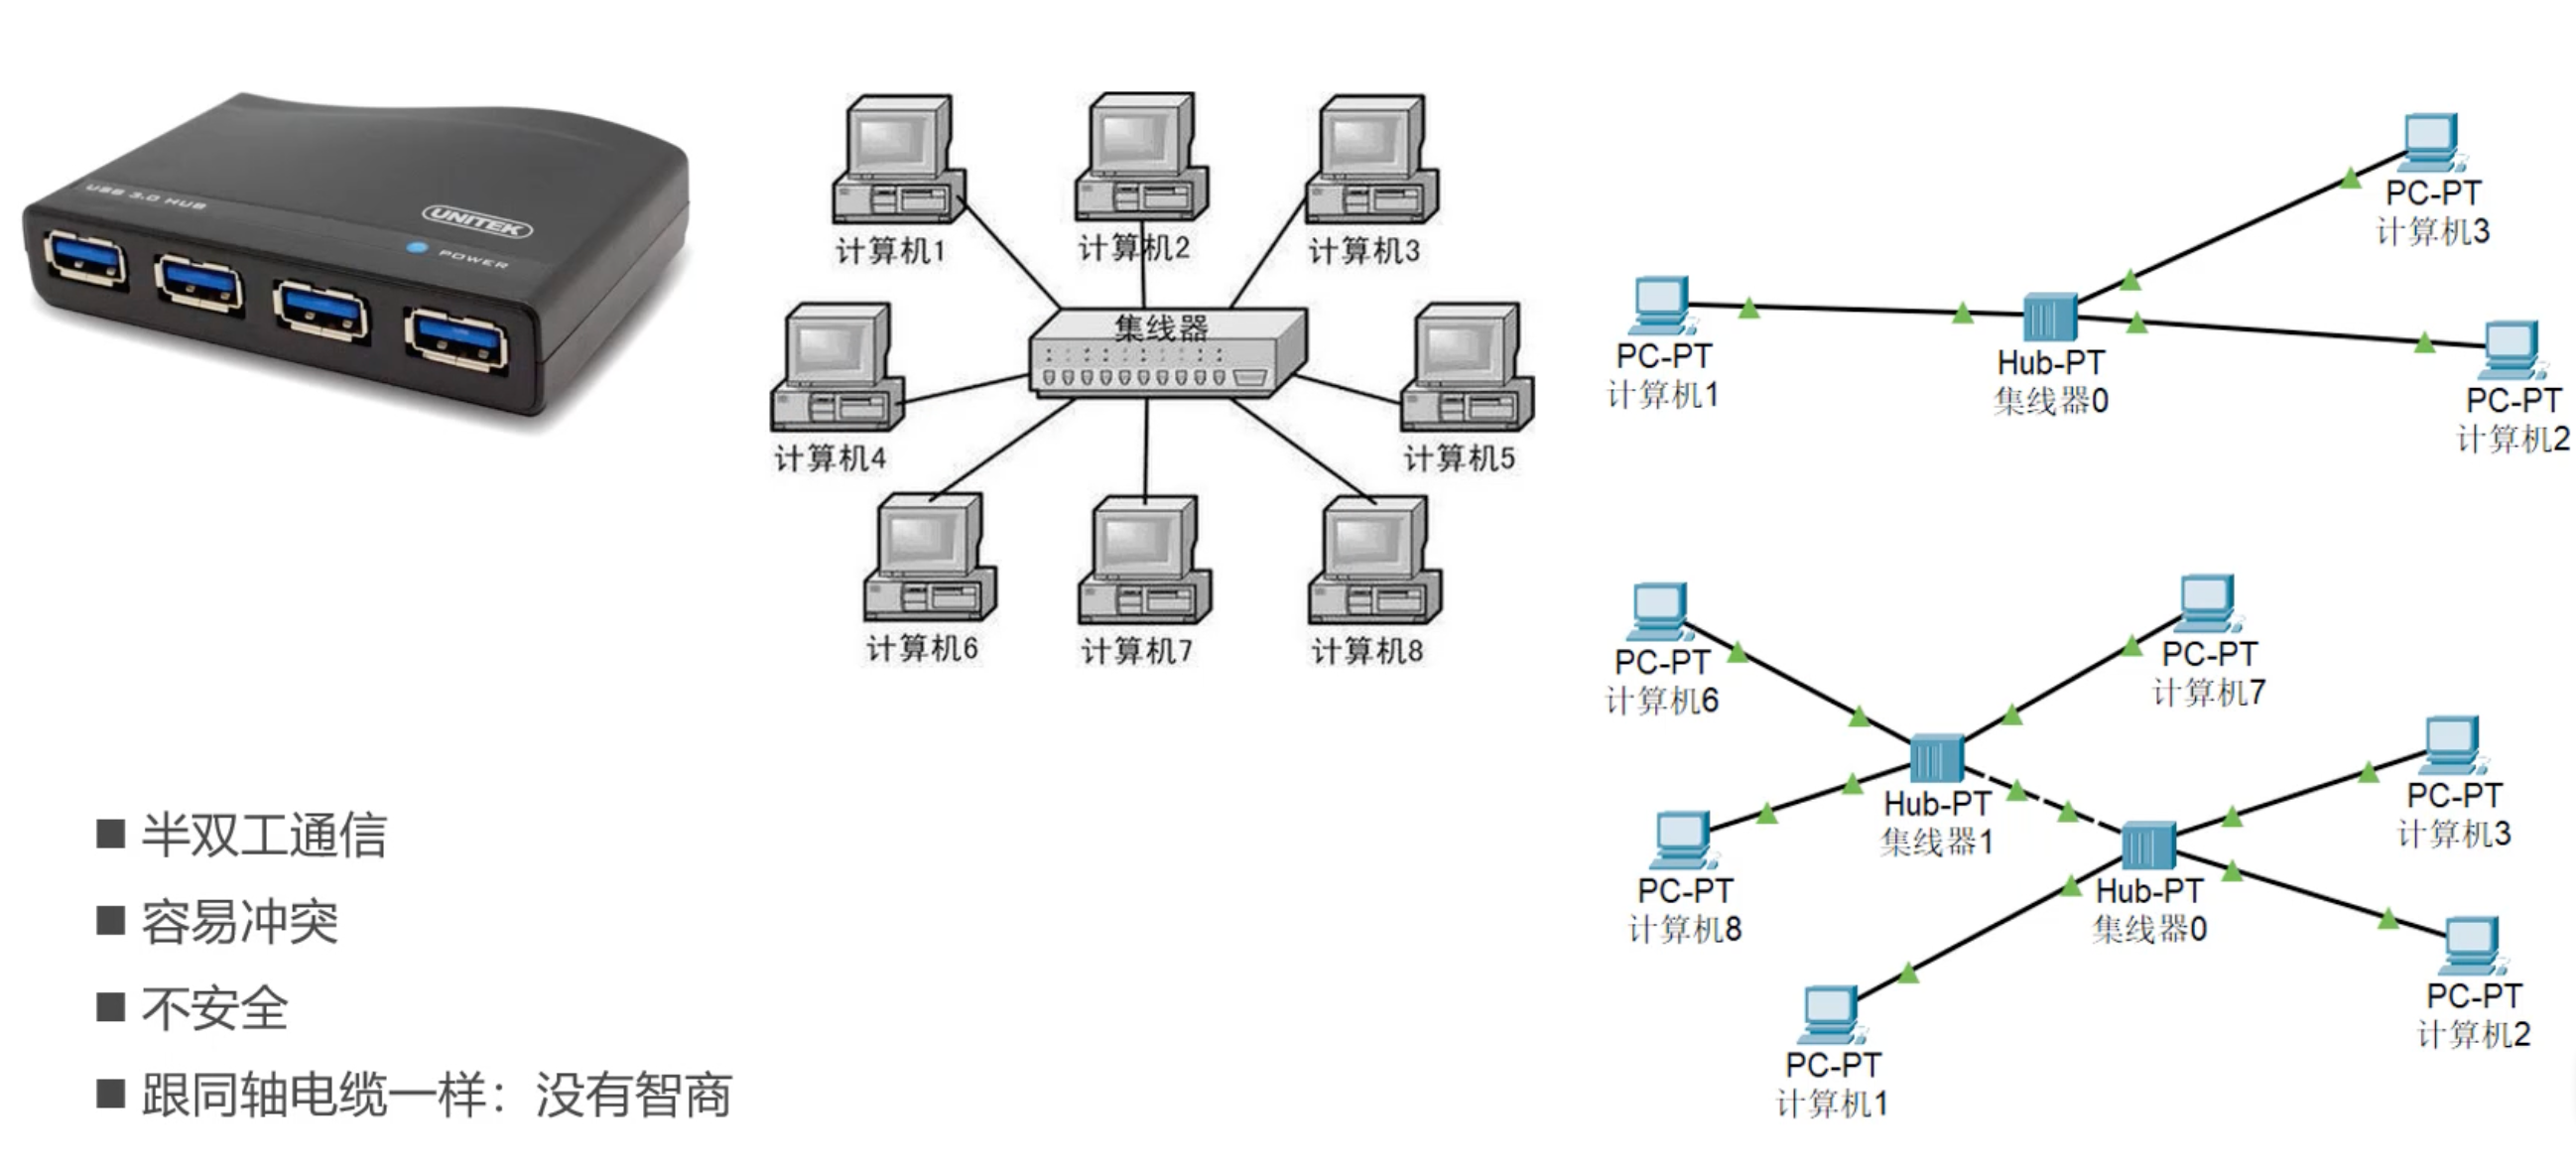
那还有没有更好的办法?3-集线器也许还行,3-集线器也是半双工通信,这意味着,他依旧会 扩大冲突域,并不安全,但是他对比同轴电缆是有进步的,他不会因为一个设备出问题了导致所有设备都没法通信。但是我还是觉得不够好,假如我用3-集线器连接起来成百上千个设备,那我想给一个设备发请求就会有大量广播,这些广播会占用宝贵的通信资源,这依旧不是好的办法。
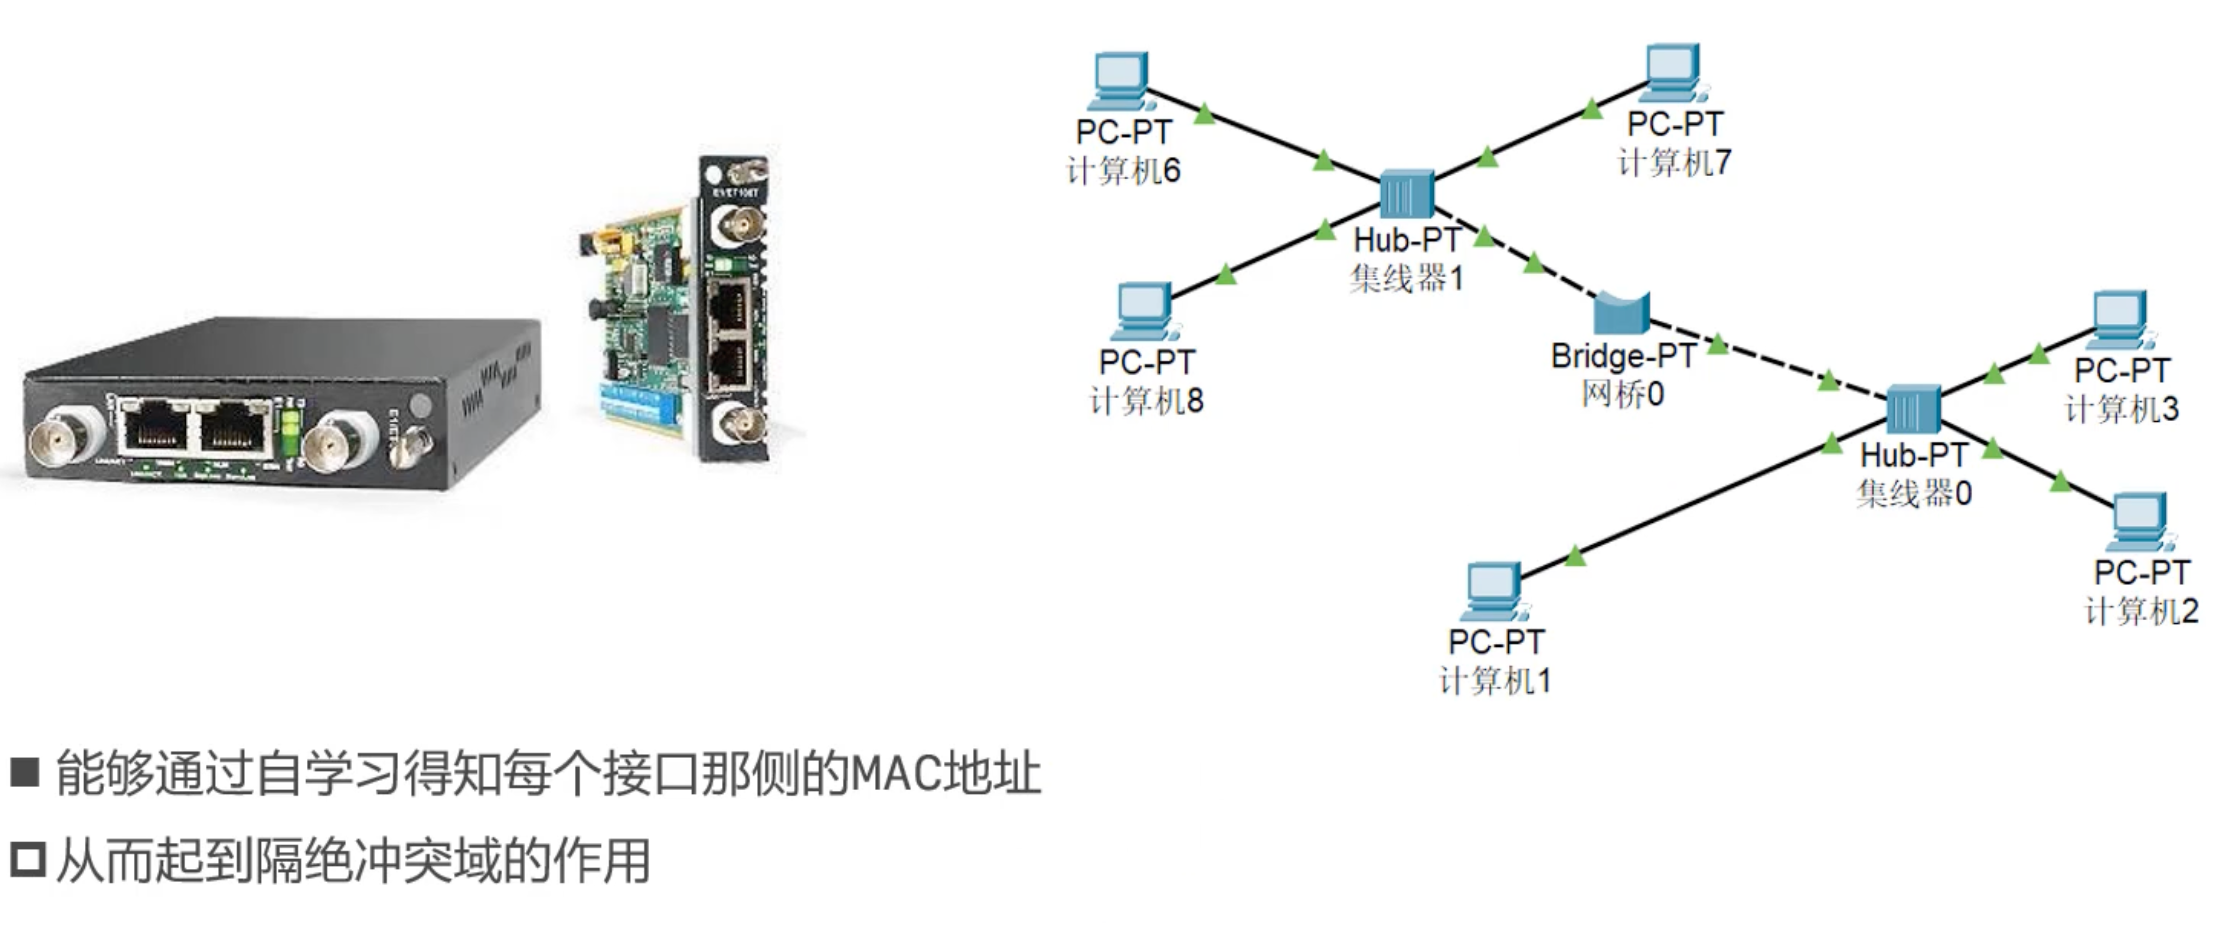
2-网桥(Bridge)
2-网桥对比3-集线器而言就更加智能了,它能够通过自学习记录下每个接口侧的设备 MAC 地址,记录以后就可以拒绝掉一些没有必要的包,例如当2-网桥知道计算机 6 和计算机 7 都在自己的左侧,6 给 7 发包的时候,就不会把包广播到右侧去,这样就起到了隔绝冲突域的作用。
很难简单地说2-网桥是全双工还是半双工,这取决于它所连接的链路类型。 如果2-网桥连接的是3-集线器(共享介质),由于存在冲突检测机制(CSMA/CD),通常只能工作在半双工模式。 如果2-网桥两端都是点对点连接(例如连接单台主机或4-交换机),则可以工作在全双工模式,不需要冲突检测。
2-网桥也有问题,他就只有两个接口,如果我们两个人玩游戏,2-网桥倒是能提供非常顺畅的网络连接体验,毕竟是全双工的,但是如果一个寝室一起玩,两个接口也太吝啬了,还是得用3-集线器。那2-网桥还得避免冲突,体验直线下降。
4-交换机(Switch)
最后我们找到了局域网的终极解决方案,4-交换机,4-交换机就是有更多接口的2-网桥,或者说,就是把3-集线器和2-网桥的功能合在一起。
4-交换机是完全支持全双工通信的,因为他接口多,可以直接做更多点对点连接,而且他也有自学习能力,每个接口都会记录 MAC 地址,极大的提高了效率。
4-交换机虽然是局域网的终极结局方案,但是全球互联网仅有4-交换机是不够的,我们还需要5-路由器,如果全球所有设备都用4-交换机连接,也就是说,全球所有设备都在同一网段,那很快 IP 地址就不够用了,另外,当我想给一台设备 ping 一下,因为不知道那台设备的 MAC,我的 ARP 将会广播到全球,严重浪费网络通信资源。
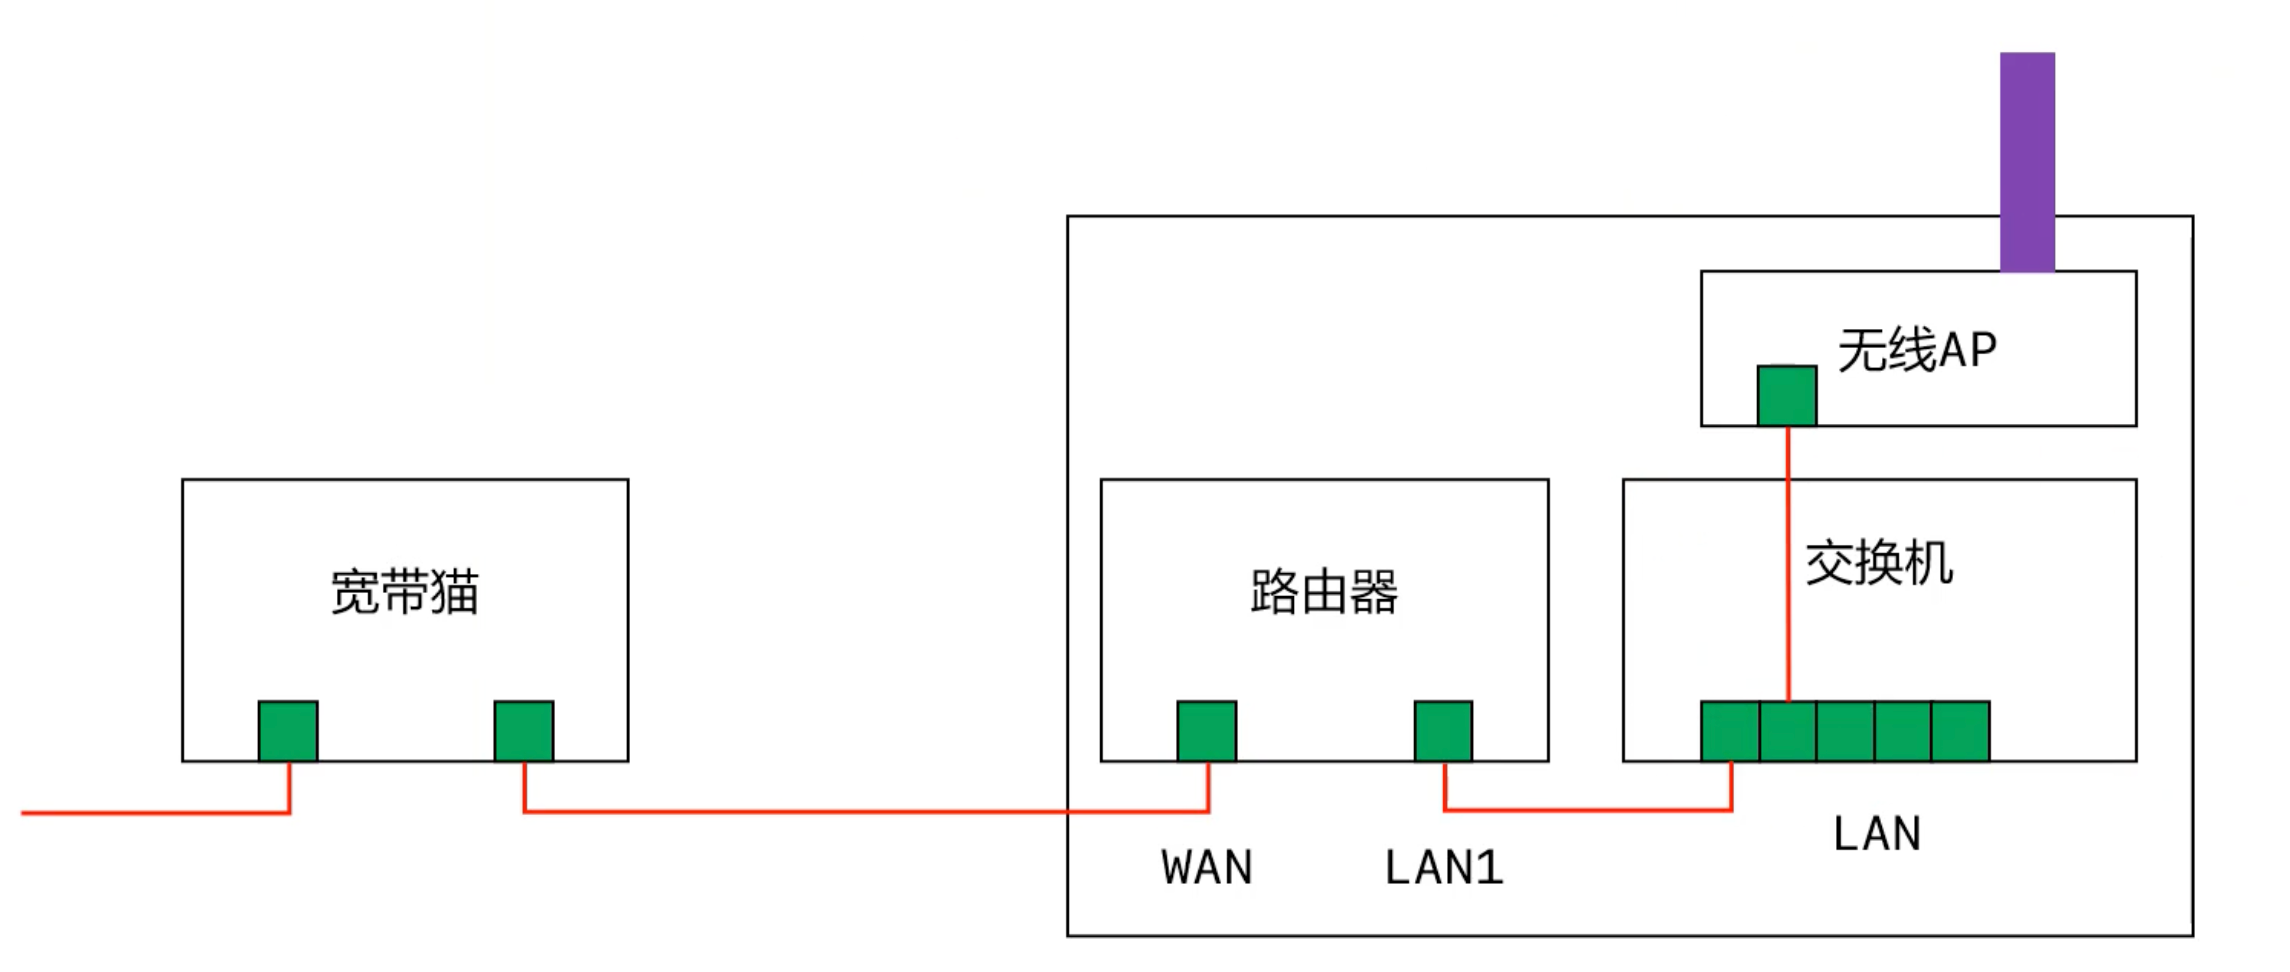
家里的 WIFI 为了让你既能够局域网连接,又能上网,又能无线连接,它就是一个复合的设备,家用 WiFi = 5-路由器 + 4-交换机 + 无线 AP。
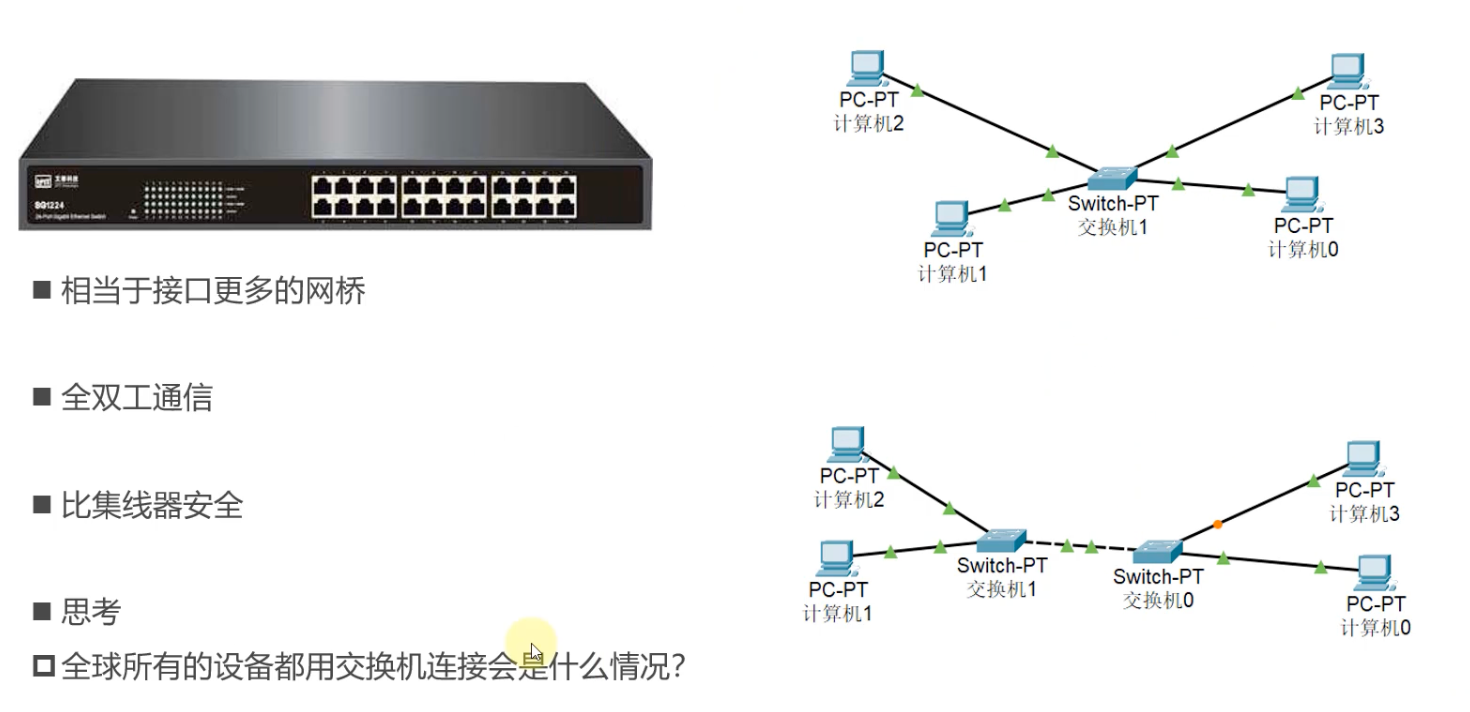
4-交换机一般也不需要 IP,我们常见的4-交换机是二层4-交换机(物理层和数据链路层),但是现在也有三层4-交换机,它就会有 IP,这个需要注意。
5-路由器(Router)
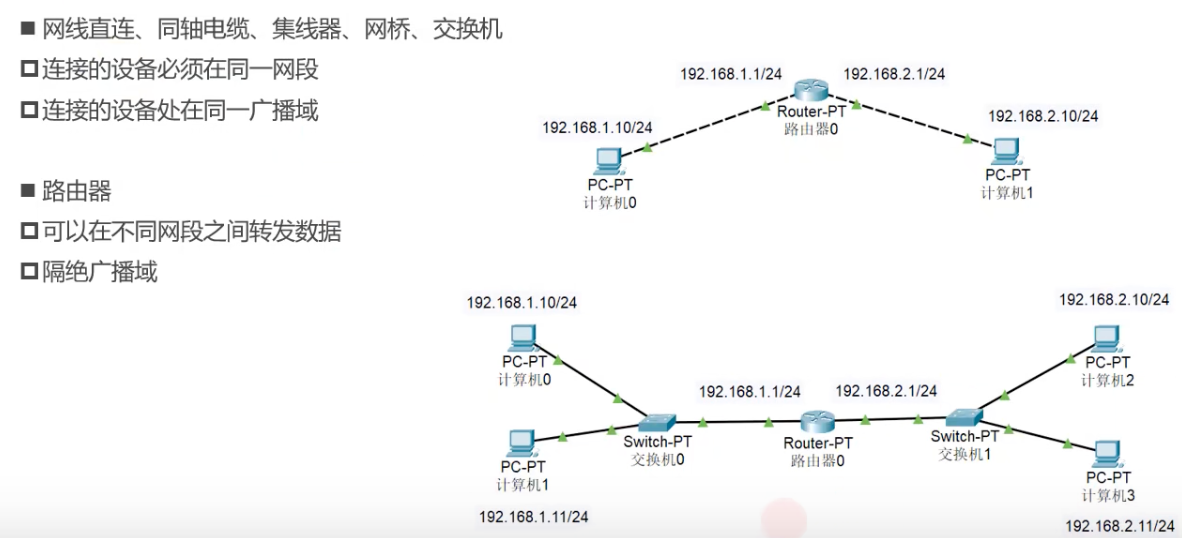
前面提到的几种连接方式虽然让我我们能够联机玩游戏,但是他们要求所有设备都处于同一网段,连好以后,他们处于同一个广播域,如果两台设备的网段不一致呢?
此时需要使用5-路由器,5-路由器可以用于跨网段数据传输,为了跨网段传输数据,5-路由器必须拥有一些4-交换机不能拥有的结构。二层4-交换机工作在数据链路层,根据 MAC 地址进行转发,不关心 IP 地址,因此不能实现跨网段通信。
5-路由器工作在网络层,根据 IP 地址进行转发,用于实现不同网段之间的通信。 在5-路由器或三层4-交换机中,每个接口都具有 IP 地址,可以看作一个三层接口,但它并不是传统意义上的网卡,而是设备内部实现的网络接口。
网络的概念
计算机网络中有多种“网”的概念,但是他们实际上是有很大区别的。
| English | Chinese |
|---|---|
| internet | 互联网 / 互连网 |
| Internet | 因特网 |
| Ethernet | 以太网 |
| LAN | 局域网 |
| MAN | 城域网 |
| WAN | 广域网 |
| World Wide Web | 万维网 |
| WLAN | 无线局域网 |
- Internet 特指全球最大的互联网,所谓的上网也指的是上互联网,它将全世界所有的计算机连接在一起。我们想要上网需要 ISP(Internet 服务提供商) 提供上网服务,平时的宽带都是 ISP 连接到 Internet 的,如果使用的是不同的 ISP 的服务也是可以进行通信的,例如使用电信网络的主机可以和使用移动网络的主机进行通信,ISP 之间也是会假设路由器的,只不过,使用电信网络的主机和另一台使用电信网络的主机通信速度会快一点,不同 ISP 则会慢一点。
- internet 在比较老派的教材里面叫做互连网,但是现在的新教材普遍翻译为互联网,但后来中文日常使用里,互联网同时具有了因特网和互连网两个意思,我们一般认为:互联网的范围最大,而因特网是范围最大的互联网,互连网则是表示互相连接的计算机组成的网络。
- LAN 是局域网,一般局域网是几百米到几十公里范围内的计算机构成的计算机网络。在电脑上和手机上更常见的 WLAN 是指无线局域网,属于局域网。
- MAN 是城域网,一般是几十公里到几百公里范围内的计算机构成的计算机网络,可以覆盖一个城市。
- WAN 广域网,一般是几百公里到几千公里范围内的计算机构成的计算机网络,可以覆盖一个国家,通常需要租用 ISP 线路。
- Ethernet 是以太网,以太网是局域网中使用最广泛的网络技术,它主要解决设备怎么连接、数据怎么发送、局域网内怎么通信这些问题,主要工作在数据链路层和物理层。
- 除此之外,还有一个概念:万维网「World Wide Web (WWW)」。万维网是建立在因特网上的超文本信息系统,而不是网络。
常见的网络接口
在使用 Cisco Packet Tracer 我们接触到了多种网络接口,比较常见的有:
- FastEthernet:快速以太网口(100M)
- GigabitEthernet:千兆以太网口
- Serial:串行接口,路由器与路由器相连就会用 Serial 口
上网方式
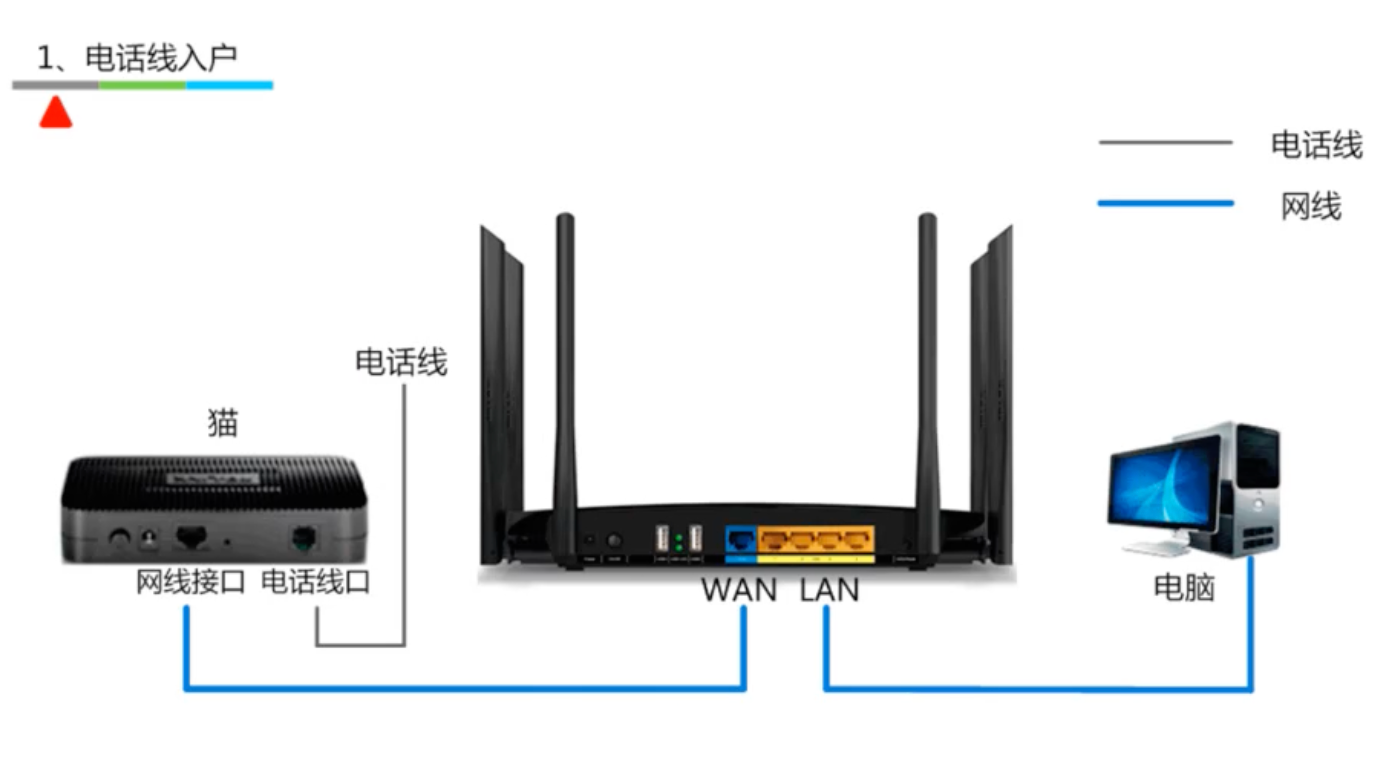
电话线上网
早期的上网方式,也就是 ADSL「ADSL(Asymmetric Digital Subscriber Line,非对称数字用户线路)是一种利用普通电话线接入互联网的宽带技术,它的特点是:下载速度高于上传速度(非对称),可以边打电话边上网,属于“最后一公里”接入技术。“数字”表示传输数字信号,“用户线路”指电话线,“非对称”指上下行速率不一致」,电话线会接到猫上(猫是调制解调器,将数字信号和模拟信号进行转换)
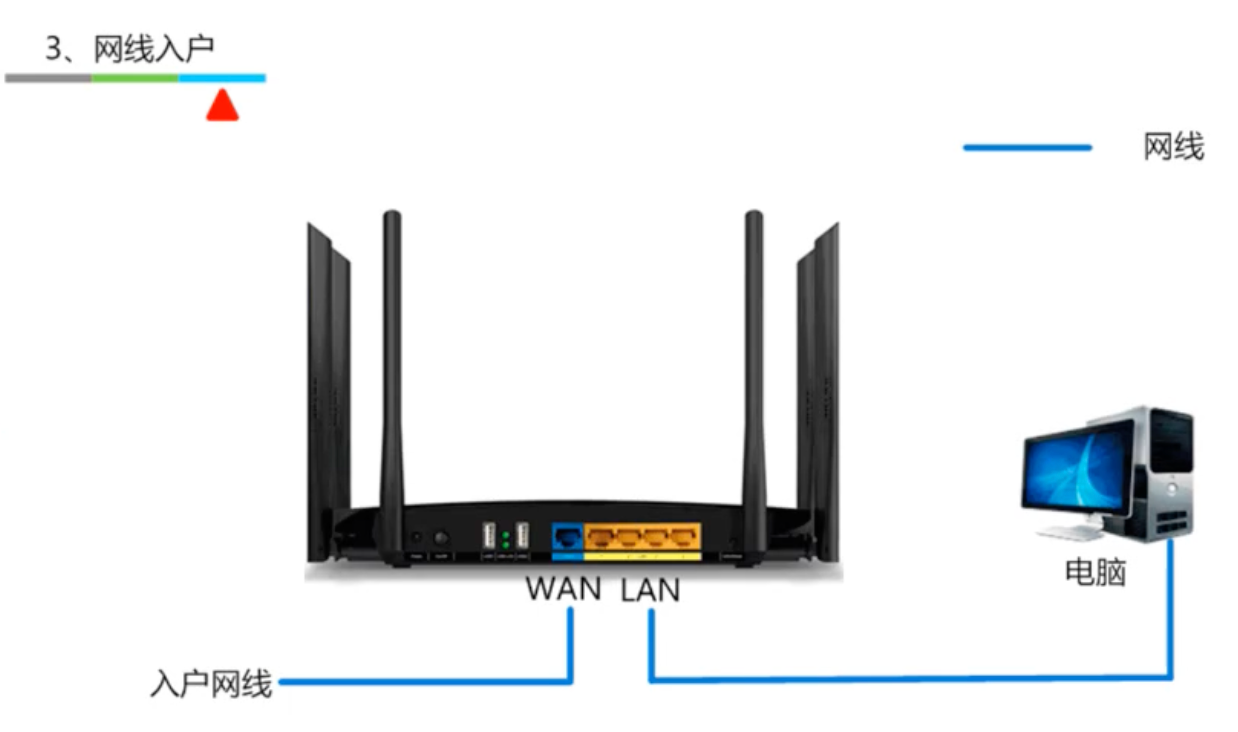
网线入户
把电话线换成光纤,猫换成光猫,就变成了网线入户。
FTTH(Fiber To The Home,光纤入户)是一种将光纤直接铺设到用户家庭的宽带接入技术。
它的特点是:
- 使用光信号传输数据
- 速度远高于 ADSL
- 延迟更低、稳定性更好
- 支持高速上下行传输(通常接近对称)
FTTH 属于现代宽带接入技术,用于让用户接入 Internet。
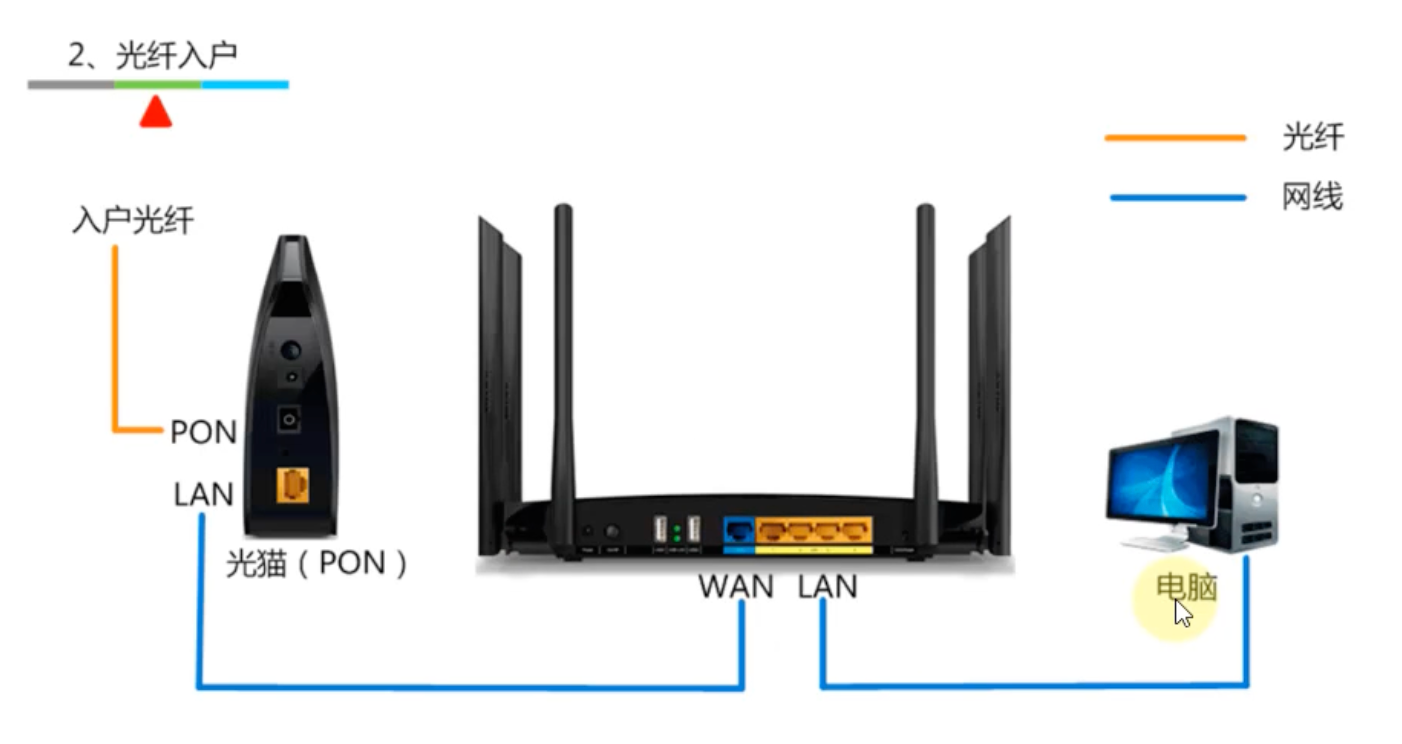
网线入户
网线入户就是运营商直接使用以太网网线(RJ45 网线)把网络接入用户家庭。
它的特点是:
- 使用以太网进行数据传输
- 速度较高
- 延迟较低
- 通常用于小区宽带、校园网、企业网络等
与 FTTH 不同的是:
- FTTH 入户介质是光纤
- 网线入户的最后一段介质是铜质以太网线
本质上它也属于:
- 宽带接入技术
- “最后一公里”网络接入方式
补充:家用无线路由器的逻辑结构
家用无线路由器需要承担三个功能:路由器的功能、交换机的功能、无线 AP 的功能,它的逻辑结构就是三者的组合,物理实现当然可能更复杂一些。
物理层
物理层的作用
物理层定义了接口标准、缆线标准、传输速率、传输方式等。
传输的数据的形式是 比特流。
信号
信号分为两种一种是模拟信号,一种是数字信号,它们各自有各自的特点。
模拟信号
模拟信号(Analog Signal)的特点是:它是连续的信号,远程传输会导致信号质量偏低。
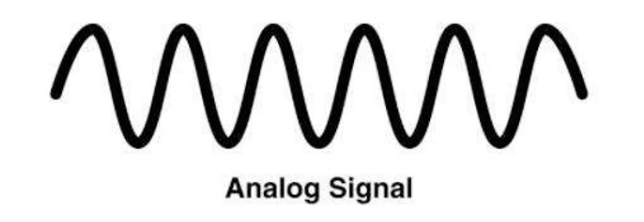
但是这种连续的信号抗干扰能力比较弱,收到干扰的时候波形会发生变形,并且很难纠正。
数字信号
数字信号(Digital Signal)的特点是:它是离散的信号,适合远程传输。
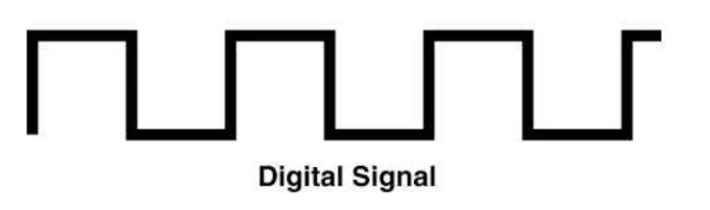
离散信号的抗干扰能力比较强,即使受到一定的干扰导致波形失真也可以修复。
数据通信模型
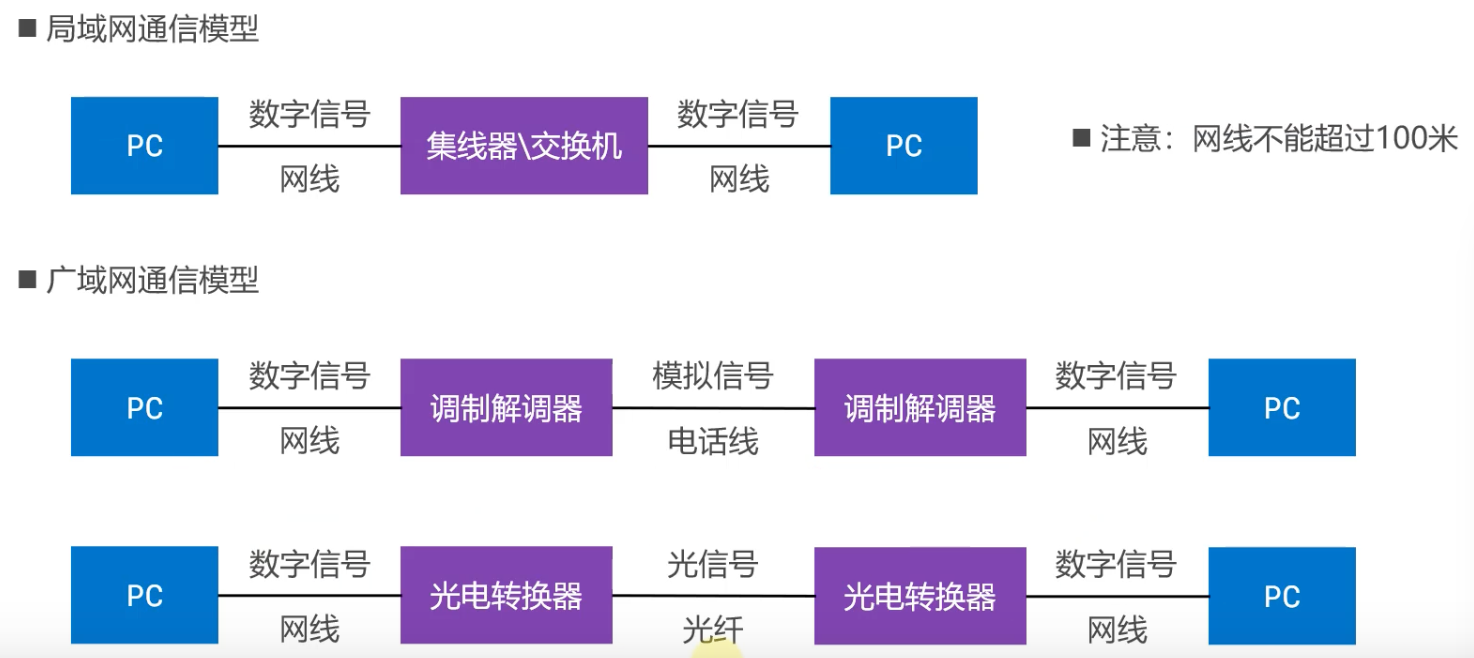
曾今的电话线使用模拟信号其实是收到当时技术水平的限制,电话线基础设施当时搭建的很完善,所以早期的广域网通信需要中途使用数字信号传输,随着技术的发展,大家意识到数字信号更适合远程传输,并且可以使用光信号承载数字信号,不仅速度快,抗干扰和衰减的效果也很好,现在大家在远程传输中越来越多地使用数字信号。
此外我们经常在局域网使用无线信号/电磁波信号,后面会详细介绍。
信道
信道是信息传输的的通道,一个传输介质上可以有多条信道。
在信道上通信也是有不同的种类,具体看 计算机网络笔记 > 基本概念#通信模式 的概念。
数据链路层
数据链路层传输的数据格式是 帧。
数据链路层要解决三个基本问题:
- 封装成帧
- 透明传输
- 差错检验
数据链路
链路指的是:从一个节点到相邻节点的一段物理链路(有线或无线),中间没有其他交换节点。
例如下面这个图中就有 5 条链路。
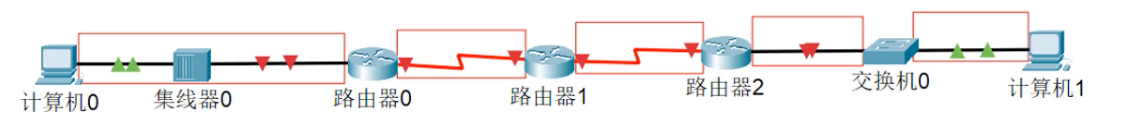
值得注意的是集线器被看做一根网线了,并不会作为一个节点划分数据链路。另外,路由器 2 与交换机 1 传输的数据和交换机 0 与计算机 1 传输的数据是完全相同的,交换机虽然被看作一个节点但是交换机也只是决定数据到底发给谁,他并不会在转发的过程中改变数据,但是路由器 0 和路由器 1 传输的数据与路由器 1 与路由器 2 之间传输的数据是不同的,因为他们的其实 MAC 地址和目标 MAC 地址是不同的。
不同类型的数据链路,所用的数据链路层协议可能也是不一样的。我们常见的协议有:
- 广播信道采用 CSMA/CD 协议,例如同轴电缆、集线器组成的网络。
- 点对点信道采用 PPP 协议,例如两个路由器之间的信道
封装成帧
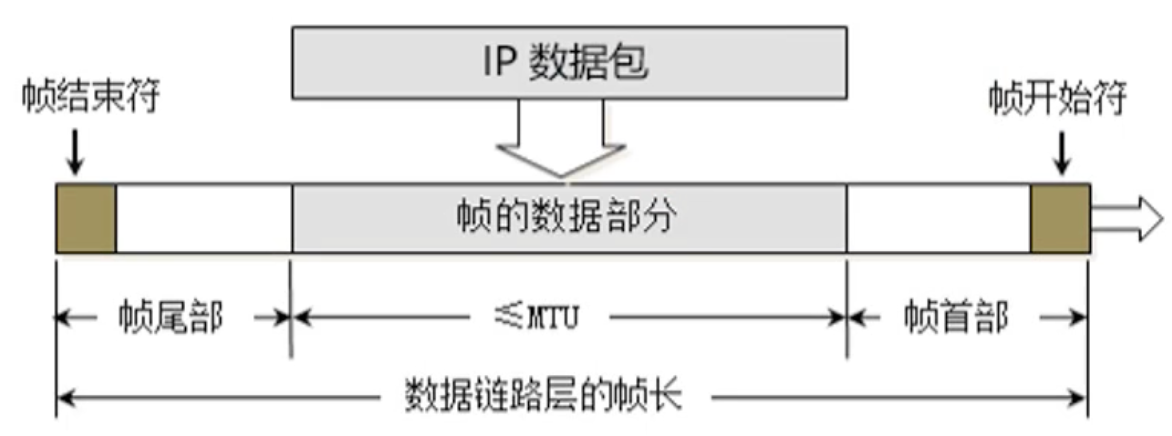
数据链路层要解决的第一个问题就是封装成帧,IP 数据包是网络层的数据单元,数据链路层是网络层的下一层,因此要对网络层的数据单元再进行封装,不论是哪一种数据链路层协议,帧的数据部分都是 IP 数据包。
帧要求帧的数据部分的长度小于 MTU(Maximum Transfer Unit),每一种数据链路层协议都规定了所能够传送的帧的数据长度上限,也就是 MTU,例如以太网帧的 MTU 就是 1500 字节。
数据链路层在拿到 IP 数据包以后,会给它加上一个帧首部和一个帧尾部,并且用帧开始符(SOH)和结束符(EOH)来标志一个帧的开始和结束。
透明传输
但是帧开始符(SOH)和帧结束符(EOT)本身也是一个字节的数据,如果帧的中间出现了与帧开始符或者结束符相同的字节,就会出错,为了避免这个问题,在封装的时候如果中间出现了帧开始符或者结束符,我们就给他加上一个转义字符(ESC),如果中间出现了转义字符,也再添加一个转义字符。接收方在拿到数据以后,就会将 ESC 给去除掉,得到原始的帧数据,这个过程是不被感知到的,也就是我们所说的透明传输,因为发送的数据和接收到的数据是一致的。
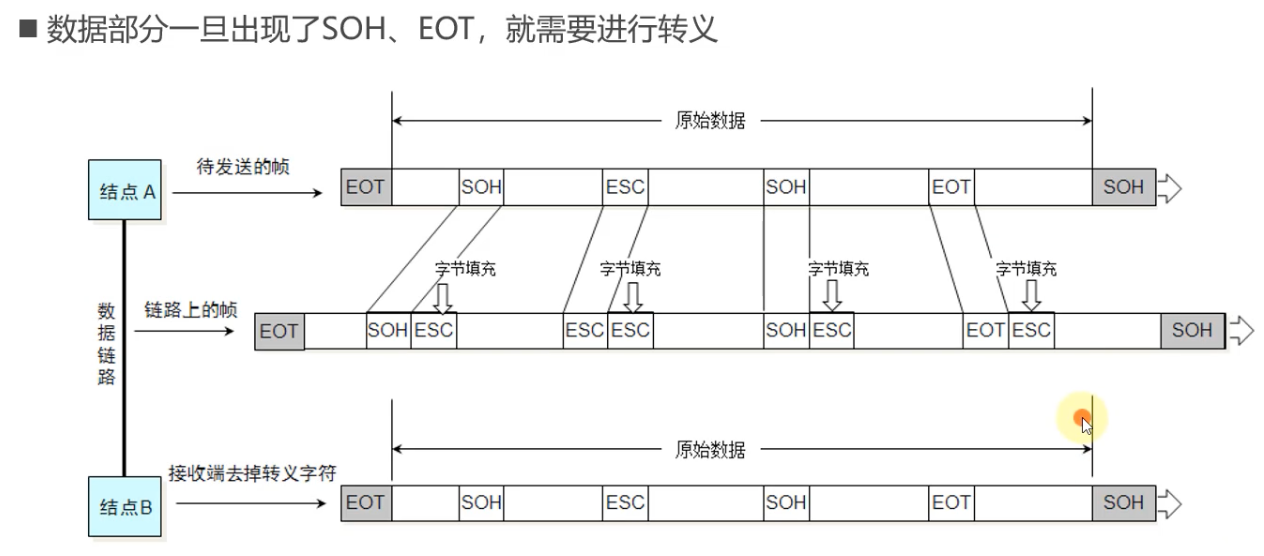
计算机中的“透明”一般指的是对使用者或者上层系统而言无法被察觉
差错检验
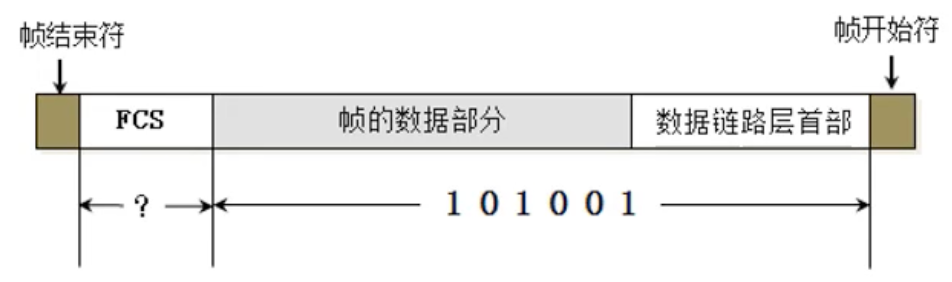
数据在传输过程中有可能出错,而数据链路层要解决的一个重要的问题就是差错检验,帧通过数据链路层首部和 FCS 来进行差错检验。
FCS 是根据帧的数据部分和数据链路层首部计算得到的,在传输出去之前,首先会计算一遍 FCS,并且放到数据报中,接收方接收到了数据报以后,也会计算一次 FCS,如果这一次得到的 FCS 和数据报中的 FCS 不一致的话,代表着数据传输过程中出现问题了,就会直接丢弃当前数据报。
以太网
以太网(Ethernet)是目前应用最广泛的局域网技术,同时涵盖了数据链路层和物理层。我们平时所说的”插网线”,底层使用的就是以太网。
以太网的两个标准
以太网有两个主要标准,容易混淆,需要区分:
| 标准 | 提出者 | 特点 |
|---|---|---|
| DIX Ethernet V2 | DEC、Intel、Xerox | 事实上的工业标准,使用最广泛 |
| IEEE 802.3 | IEEE 802 委员会 | 国际标准,帧格式略有差异 |
两者最主要的区别在于帧的第二个字段:Ethernet V2 中是类型(Type,标识上层协议),而 802.3 中是长度(Length,标识数据部分的字节数)。不过 802.3 后来也支持”类型/长度”混合表示,因此实际使用中两者基本兼容。通常把 802.3 局域网也简称为”以太网”。
从共享式到交换式
以太网的发展经历了从共享式到交换式的演变,这是理解以太网的关键:
共享式以太网(传统):使用同轴电缆或集线器(Hub)连接,所有设备共享一条物理信道。这种情况下,多个设备可能同时发送数据导致碰撞(冲突),因此必须使用 CSMA/CD 协议来协调谁可以发送。
交换式以太网(现代):使用交换机(Switch)连接,交换机为每对通信设备建立专用的点对点链路,支持全双工通信。此时信道不再被共享,不存在碰撞问题,因此不再需要 CSMA/CD 协议。
类比理解:共享式以太网就像一群人围在一起轮流发言,需要规则(CSMA/CD)避免抢话;交换式以太网就像每个人都有一对一的专线电话,互不影响。
但无论哪种方式,数据链路层传输的数据单元都叫做以太网帧,帧的基本结构保持不变。
CSMA/CD 协议
CSMA/CD(Carrier Sense Multiple Access with Collision Detection,载波侦听多路访问/碰撞检测)是传统共享式以太网使用的介质访问控制协议,用于协调多个设备对共享信道的访问。
注意:CSMA/CD 只适用于半双工的共享式以太网。现代交换式以太网工作在全双工模式,不存在碰撞,因此不再使用 CSMA/CD。但 CSMA/CD 作为 408 考点,仍需要掌握。
工作步骤
- 载波侦听(CS):
- 发送前先”监听”信道,如果信道忙(有其他设备在发送),则等待;如果信道空闲,再等待一个短暂的**帧间间隔(IFS)**后发送。
- 多路访问(MA):
- 所有设备对信道享有平等的访问权,通过”竞争”的方式获取发送机会,没有中心调度。
- 碰撞检测(CD):
- 设备在发送数据的同时继续监听信道。如果检测到信道上的信号电压异常(两个信号叠加导致电压翻倍),说明发生了碰撞。
- 碰撞处理:
- 检测到碰撞后,立即停止发送当前帧,并发送一个简短的阻塞信号(Jam Signal,32 位),确保所有设备都知道发生了碰撞。
- 然后进入**指数退避(Exponential Backoff)**阶段:等待一个随机时间后重新尝试发送。重传次数越多,等待的随机时间范围越大(0 到 个时隙,k = min(重传次数, 10)),以减少再次碰撞的概率。
如果重传 16 次仍然失败,则放弃发送并向上层报告错误。
争用期与最短帧长
CSMA/CD 有一个核心概念叫做争用期(Contention Period),也叫碰撞窗口。
争用期指的是:信号在最远两个站点之间往返传播所需的最大时间。在 10 Mbps 以太网中,争用期被定义为 51.2 μs。
为什么帧长至少要 64 字节?原因如下:
- 传播时延:电信号在电缆中的传播速度约为 m/s(接近光速但略低)。如果两个站点相距最远,一个站点发出的信号到达另一个站点需要时间 ,碰撞信号再返回又需要时间 ,总往返时间最大为 。
- 检测条件:发送方必须在帧发送完毕之前收到碰撞信号,才能知道自己发的帧发生了碰撞。如果帧太短,发送方已经发完了,碰撞信号才返回,那么发送方会认为发送成功,但实际上对端收到的已经是损坏的数据。
- 64 字节的由来:10 Mbps 以太网中,发送 64 字节(512 位)需要的时间为 μs,这恰好等于争用期。也就是说,在争用期内如果还没有检测到碰撞,就可以确认这个帧不会发生冲突了。
结论:以太网帧的最小长度是 64 字节(数据部分至少 46 字节,不足则填充),最大长度是 1518 字节。
Ethernet V2 帧格式
Ethernet V2 是目前使用最广泛的以太网帧格式。它的独特之处在于没有显式的帧开始符和帧结束符,而是通过物理层的编码方式来界定帧的边界。
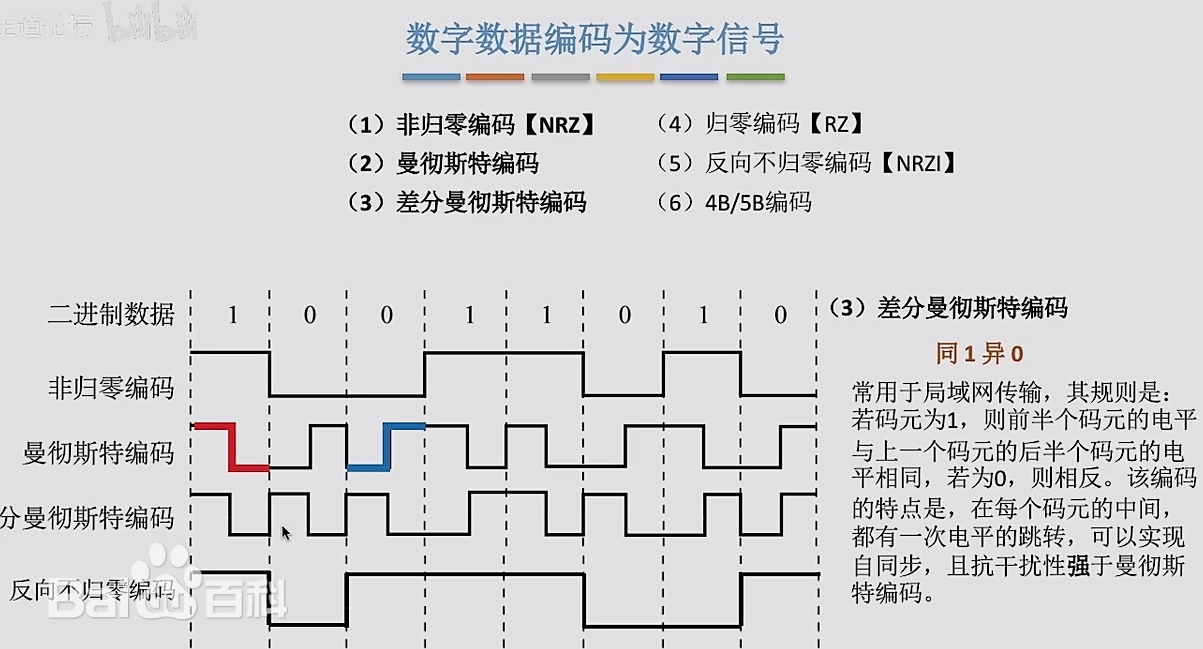
帧定界:曼彻斯特编码
以太网使用曼彻斯特编码传输数据。曼彻斯特编码的特点是:每个比特周期的中间必定有一次电平跳变,这个跳变既表示数据(1 或 0),又提供了时钟同步信号。
当线路空闲时,没有信号传输,也就没有电平跳变。因此:
- 检测到电平跳变 → 帧开始传输
- 持续没有跳变 → 线路空闲,帧结束
这种设计省去了额外的帧定界符,但代价是编码效率为 50%(波特率是比特率的 2 倍)。
曼彻斯特编码还有变体叫差分曼彻斯特编码,主要用于令牌环网(Token Ring),不是以太网的标准。
Ethernet V2 帧的结构
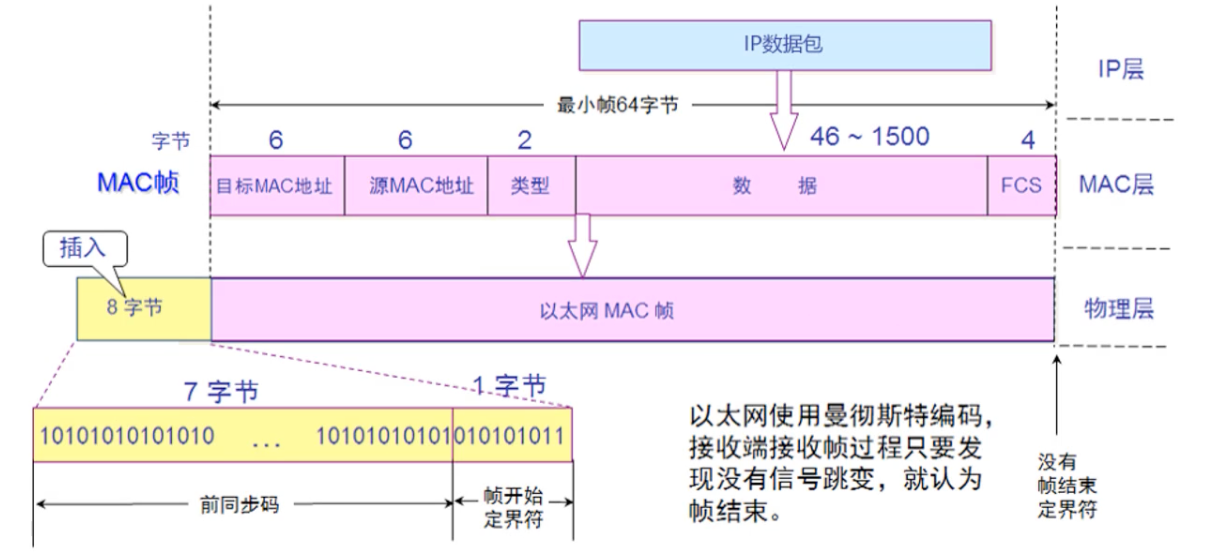
Ethernet V2 帧由以下几个部分组成:
| 字段 | 长度 | 说明 |
|---|---|---|
| 目标 MAC 地址 | 6 字节 | 接收方的物理地址 |
| 源 MAC 地址 | 6 字节 | 发送方的物理地址 |
| 类型(Type) | 2 字节 | 标识上层协议 |
| 数据 | 46~1500 字节 | 上层数据(IP 数据报等) |
| FCS | 4 字节 | CRC 循环冗余校验 |
- 首部共 14 字节(6 + 6 + 2)
- 类型字段的常见取值:
- 0x0800:IPv4
- 0x0806:ARP(地址解析协议)
- 0x86DD:IPv6
- 0x8100:VLAN 标记帧(IEEE 802.1Q)
- 0x8847 / 0x8848:MPLS 单播/多播
注意区分:Ethernet V2 的第二个字段是类型(表示上层协议),而 IEEE 802.3 的第二个字段是长度(表示数据部分的字节数)。由于数据部分最大为 1500,因此当该字段值 > 0x05DC(即 1500)时,表示的是类型;<= 1500 时,表示的是长度。
- 数据部分长度范围:
- 最小 46 字节 = 64(最小帧长)- 6(目的 MAC)- 6(源 MAC)- 2(类型)- 4(FCS)
- 最大 1500 字节(MTU)
- 不足 46 字节时,数据链路层会自动填充(Padding),接收方根据 IP 首部中的”总长度”字段去除填充
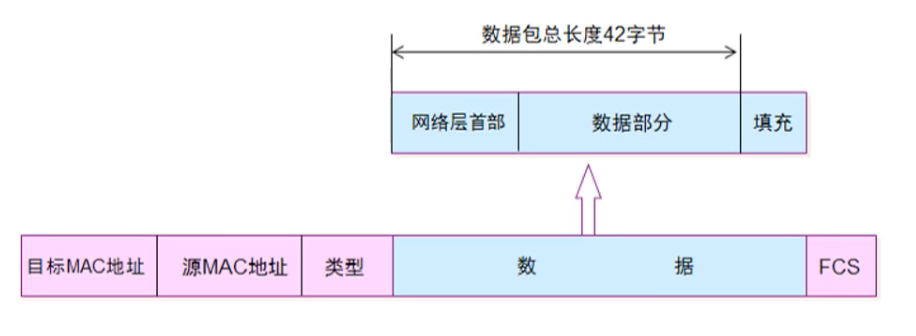
- Ethernet V2 帧的总长度范围:64 ~ 1518 字节
PPP协议
PPP(Point-to-Point Protocol,点对点协议)是数据链路层中用于点对点信道的协议。与以太网不同,PPP 不存在多个设备共享信道的问题,因为点对点通信只有两个节点,数据从一端发出,唯一的可能接收方就是另一端,因此PPP 不需要 CSMA/CD 这类介质访问控制机制。
PPP 的应用场景
PPP 主要用于以下几种情况:
- 两个路由器之间的串行链路:例如你的笔记中提到的 Serial 接口连接,这是 PPP 最典型的应用场景。在这种链路上只有两个设备,天然就是点对点通信。
- 拨号上网:早期的电话线拨号上网,调制解调器之间通过电话线通信,使用 PPP 协议来传输数据。PPP 支持认证功能(PAP、CHAP),这是拨号上网需要用户名密码登录的技术基础。
- ADSL 宽带(PPPoE):现代家庭宽带虽然入户的是网线(以太网),但运营商需要认证和会话管理,因此使用了 PPPoE(PPP over Ethernet),即将 PPP 帧封装在以太网帧中传输。这也是为什么你家里的宽带连接通常需要”拨号”。
- VPN 隧道:某些 VPN 技术也在底层使用 PPP 或其变体。
PPP 的特点
PPP 协议设计得非常简洁,它的主要特点包括:
- 简单:PPP 不提供可靠传输(没有确认和重传机制),将纠错任务交给上层协议(如 TCP)。数据链路层只需要检错,发现错误直接丢弃。
- 封装成帧:PPP 使用特殊的帧定界符,并且支持差错检测(FCS)。
- 支持多种网络层协议:PPP 的帧中有一个”协议”字段,用来标识数据部分是什么网络层协议(如 IP、IPX 等),这使得同一条 PPP 链路可以承载不同类型的网络层数据。
- 支持链路状态检测:PPP 可以检测链路工作状态,并在链路建立时进行配置和测试。
- 支持身份认证:通过 PAP 或 CHAP 协议验证通信双方的身份。
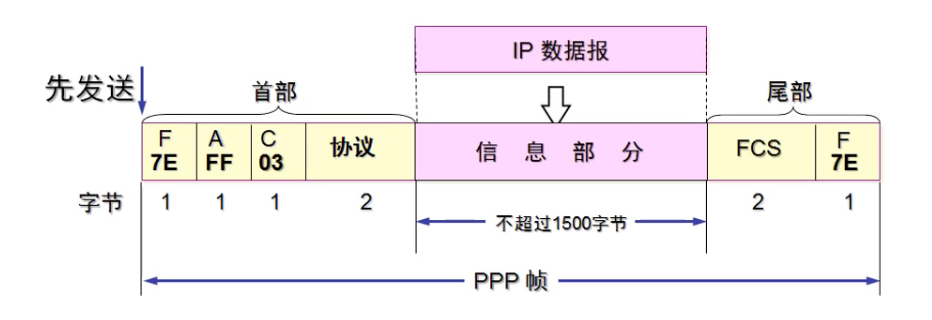
PPP 的帧格式
PPP 帧的结构比以太网帧简单:
| 字段 | 标志(F) | 地址(A) | 控制(C) | 协议 | 数据部分 | FCS | 标志(F) |
|---|---|---|---|---|---|---|---|
| 长度 | 1 字节 | 1 字节 | 1 字节 | 2 字节 | 可变 | 2/4 字节 | 1 字节 |
| 取值 | 0x7E | 0xFF | 0x03 | 0x7E |
各字段的含义:
- 标志字段(Flag):固定为
0x7E(二进制01111110),表示一个帧的开始和结束。也就是说,PPP 帧使用首尾定界符的方式标记帧边界。 - 地址字段(Address):固定为
0xFF(广播地址)。在点对点通信中,这个字段实际上没有实际意义,因为数据只能发给对端,但为了兼容性保留了这个字段。 - 控制字段(Control):固定为
0x03,表示这是一个无编号帧。 - 协议字段(Protocol):标识数据部分属于哪种网络层协议,例如
0x0021表示 IP 数据报,0xC021表示 LCP 数据,0x8021表示 NCP 数据。 - 数据部分:长度可变,但不超过 MTU(默认 1500 字节)。
- FCS:帧检验序列,使用 CRC 校验,可以是 2 字节或 4 字节。
对比以太网帧和 PPP 帧,有一个很有意思的区别:PPP 帧中没有 MAC 地址。这是因为点对点通信只有两个端点,不需要地址来标识”发给谁”。
透明传输
PPP 帧使用 0x7E 作为帧定界符,但如果数据部分中恰好出现了 0x7E,接收方就会误以为帧结束了。因此 PPP 也需要解决透明传输的问题。
PPP 采用两种不同的方法,取决于传输方式是同步还是异步:
1. 字节填充(异步传输)
当 PPP 使用异步传输(如通过调制解调器在电话线上传输)时,使用字节填充:
- 如果数据中出现
0x7E,将其替换为0x7D 0x5E - 如果数据中出现转义字符
0x7D,将其替换为0x7D 0x5D - 如果数据中出现 ASCII 控制字符(小于
0x20),也在前面插入0x7D
例如,数据中有 ... 0x7E ...,发送方发送 ... 0x7D 0x5E ...,接收方收到后还原为 0x7E。
2. 零比特填充(同步传输)
当 PPP 使用同步传输(如路由器之间的 Serial 链路)时,使用零比特填充:
- 发送方在数据部分中,如果发现有连续 5 个 1,就在后面插入一个 0
- 接收方在数据部分中,如果发现连续 5 个 1 后面跟着一个 0,就将这个 0 删除
为什么要这样做?因为标志字段 0x7E 的二进制是 01111110,其中有一段连续 6 个 1。零比特填充确保了数据部分不会出现连续 6 个 1,也就不会出现假的 0x7E。
408 考点:PPP 是面向字节的,使用字节填充;HDLC 是面向比特的,使用零比特填充。这个对比经常出现在选择题中。
PPPoE
虽然 PPP 本身是点对点协议,但现代家庭中很多场景下数据是在以太网中传输的。为了让 PPP 能在以太网上工作,就出现了 PPPoE(PPP over Ethernet)。
PPPoE 的工作流程大致是:
- 在你的电脑和运营商的接入服务器之间建立一个 PPP 会话
- PPP 帧被封装在以太网帧中传输
- 以太网帧的目的 MAC 地址是接入服务器的 MAC 地址
- 这样既能利用以太网的物理层和数据链路层,又能享受 PPP 的认证、计费等功能
家用路由器的”宽带拨号”功能,底层就是在运行 PPPoE 客户端。
以太网 vs PPP vs HDLC
| 对比项 | 以太网 (Ethernet) | PPP | HDLC |
|---|---|---|---|
| 信道类型 | 广播信道 | 点对点信道 | 点对点/多点 |
| 介质访问控制 | CSMA/CD(历史) | 不需要 | 不需要 |
| 地址 | 需要 MAC 地址 | 不需要地址 | 有地址字段 |
| 传输单位 | 面向字节 | 面向字节 | 面向比特 |
| 透明传输 | / | 字节填充 | 零比特填充 |
| 可靠传输 | 不可靠 | 不可靠 | 可靠/不可靠可选 |
| 认证 | 不支持原生认证 | 支持 PAP/CHAP | 不支持 |
| 典型场景 | 局域网 | 拨号、路由器互联 | 早期广域网 |
PPP 可以看作是对 HDLC 的简化和改进,去除了复杂的控制功能,增加了认证和多协议支持,成为目前点对点通信的主流协议。
补充:
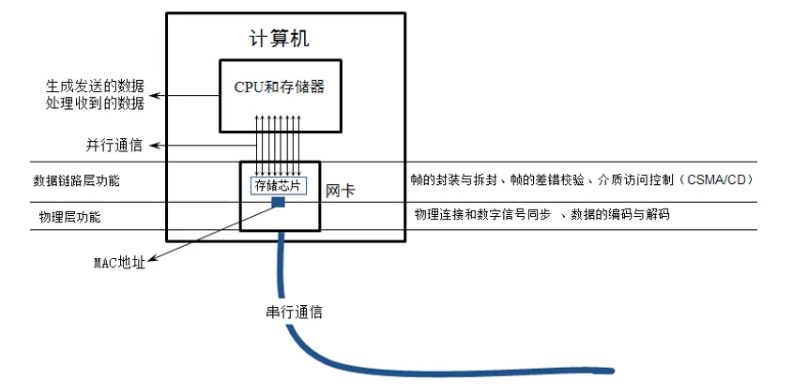
网卡工作与物理层与数据链路层,具体的工作方式如图:
网卡在数据链路层要负责差错校验,但是 wireshark 抓到的帧是没有 FCS 的,因为 wireshark 能抓到的帧都是通过了差错校验的,否则就直接丢弃了。
网络层
网络层传输的数据格式是 包。
网络层是计算机网络分层中的第三层,他需要将数据从一个主机发送的数据,跨过多个网络,送到另一个主机。
这里主要介绍网络数据包的首部,此外还有一些知识是写在 5-路由器
网络层数据包
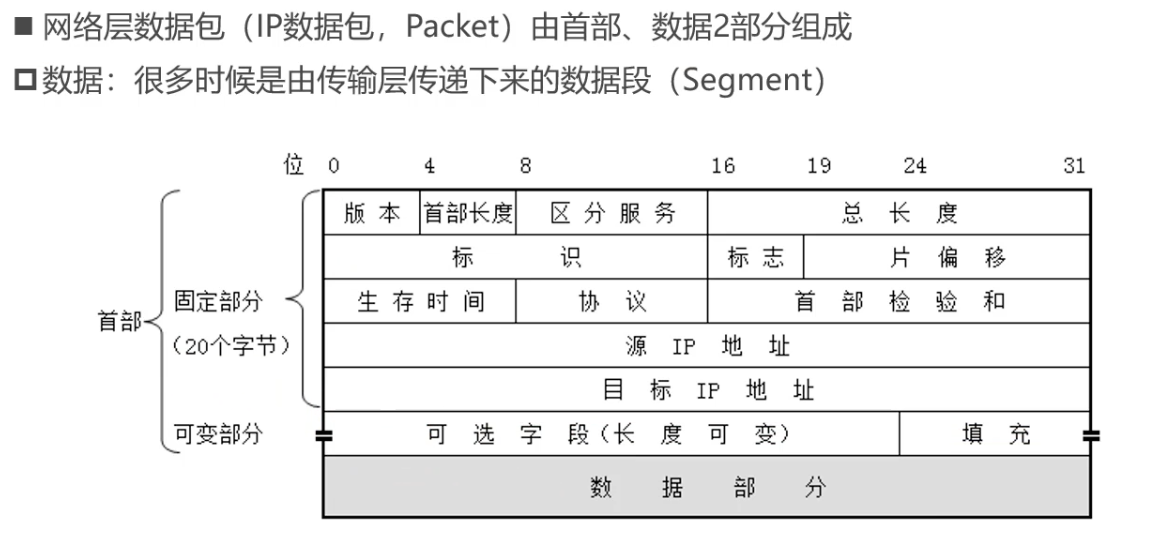
网络层传输的数据单位是数据包,一个网络层的数据包包含 首部 和 数据。
网络数据包首部
网络数据包首部包含 固定部分 和 可变部分,固定部分固定有20 个字节。
固定部分
- 版本:代表 IP 协议的版本,例如有的是 IPv4 有的是 IPv6,如果是 IPv4 这里是 0b0100,如果是 IPv6,这里是0b0110,例如:
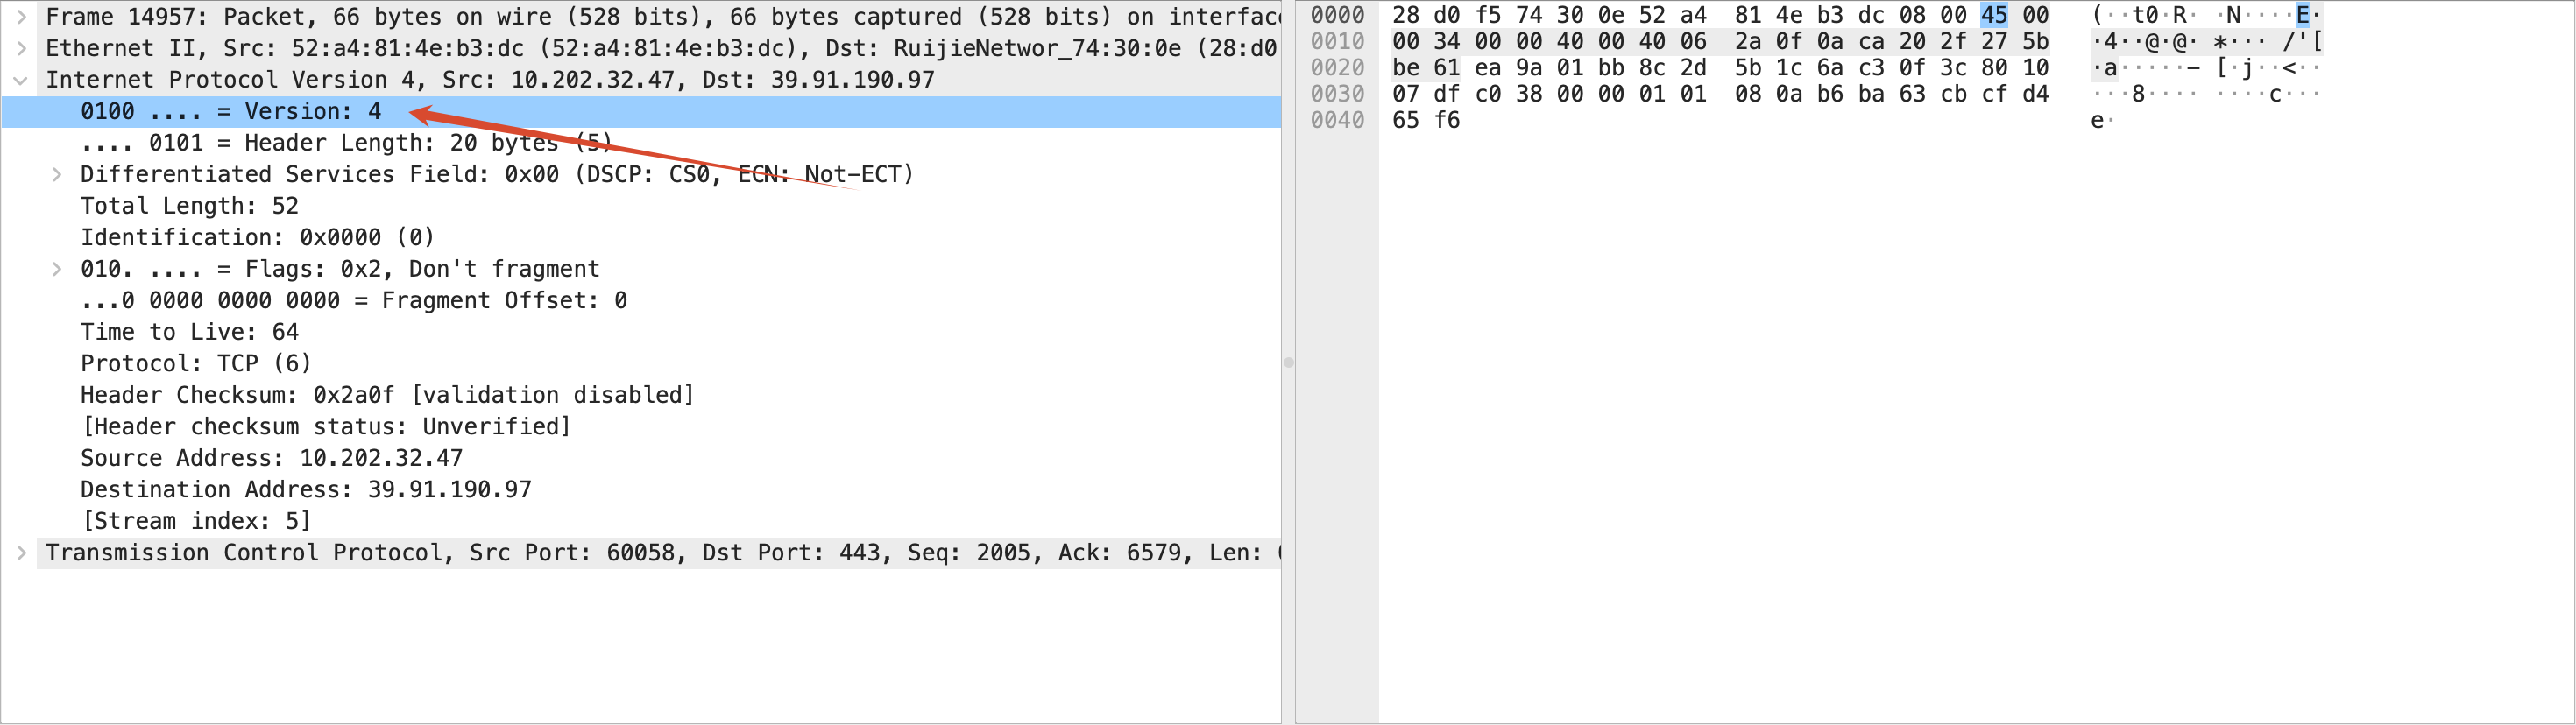
- 首部长度:表示的是网络数据包首部的长度,最短的时候是,网络数据包只有固定部分,长度为 20 字节,此时首部长度字段为:0b0101。而最长的是时候是网络数据包拥有最长可变部分的时候,而可变部分最长为 40 字节,所以网络数据包长度最长为 60 字节,此时首部长度字段为:0b1111。 首部长度乘以4 才是真正的字节数。 例如这个数据包的首部只有 20 字节,不包括可变长度
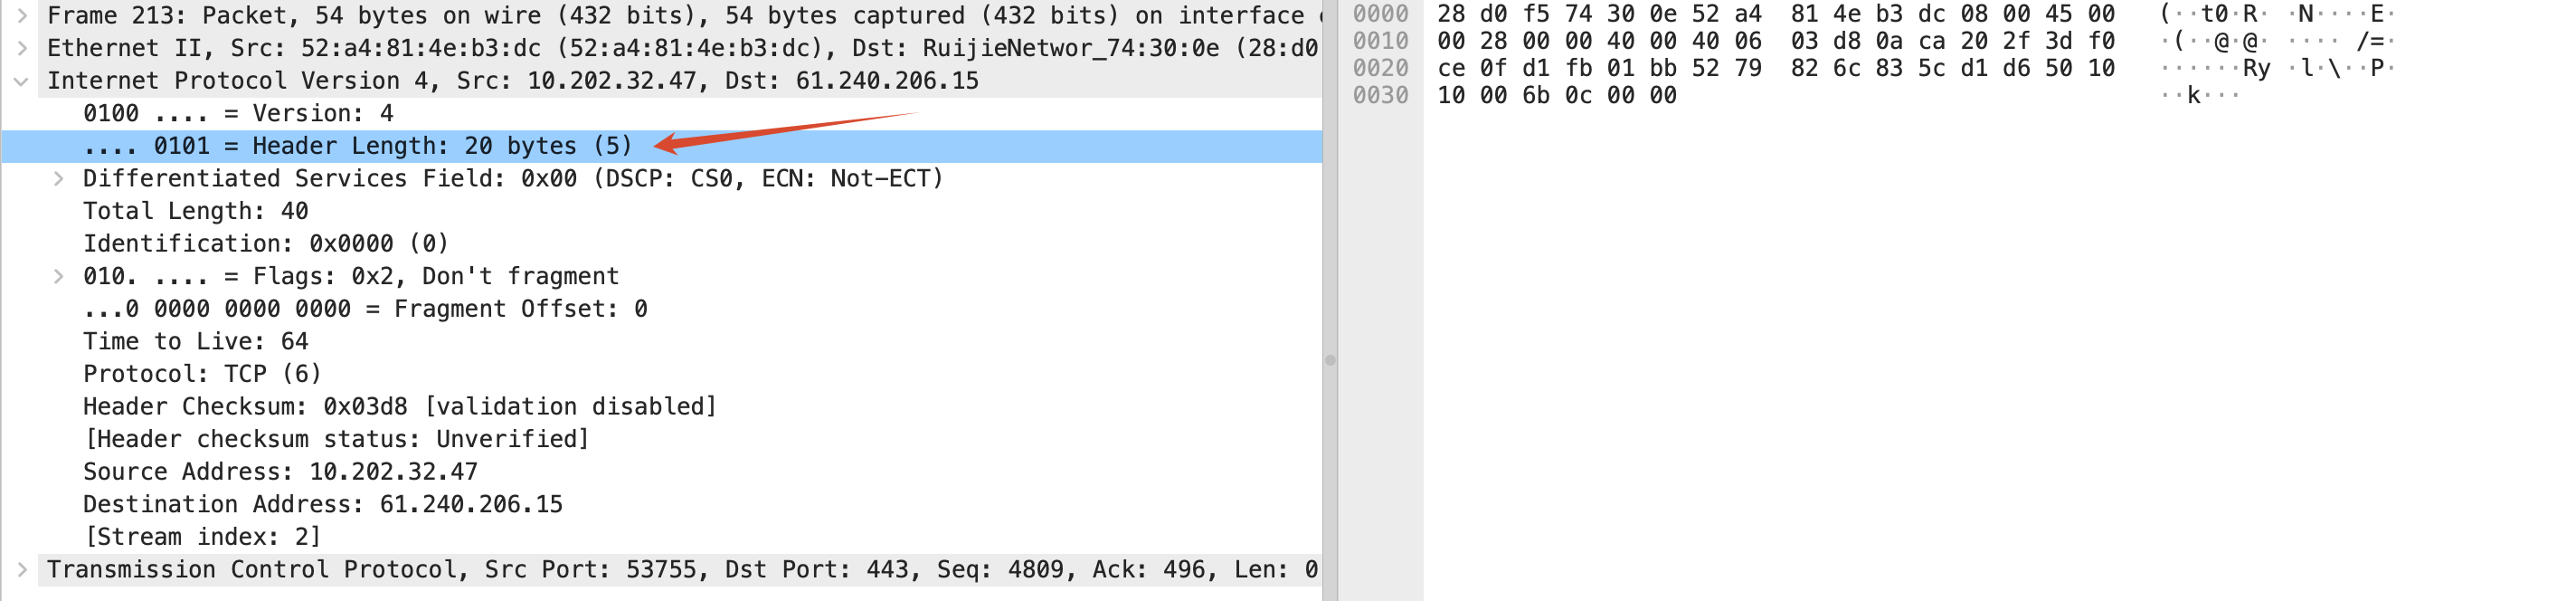
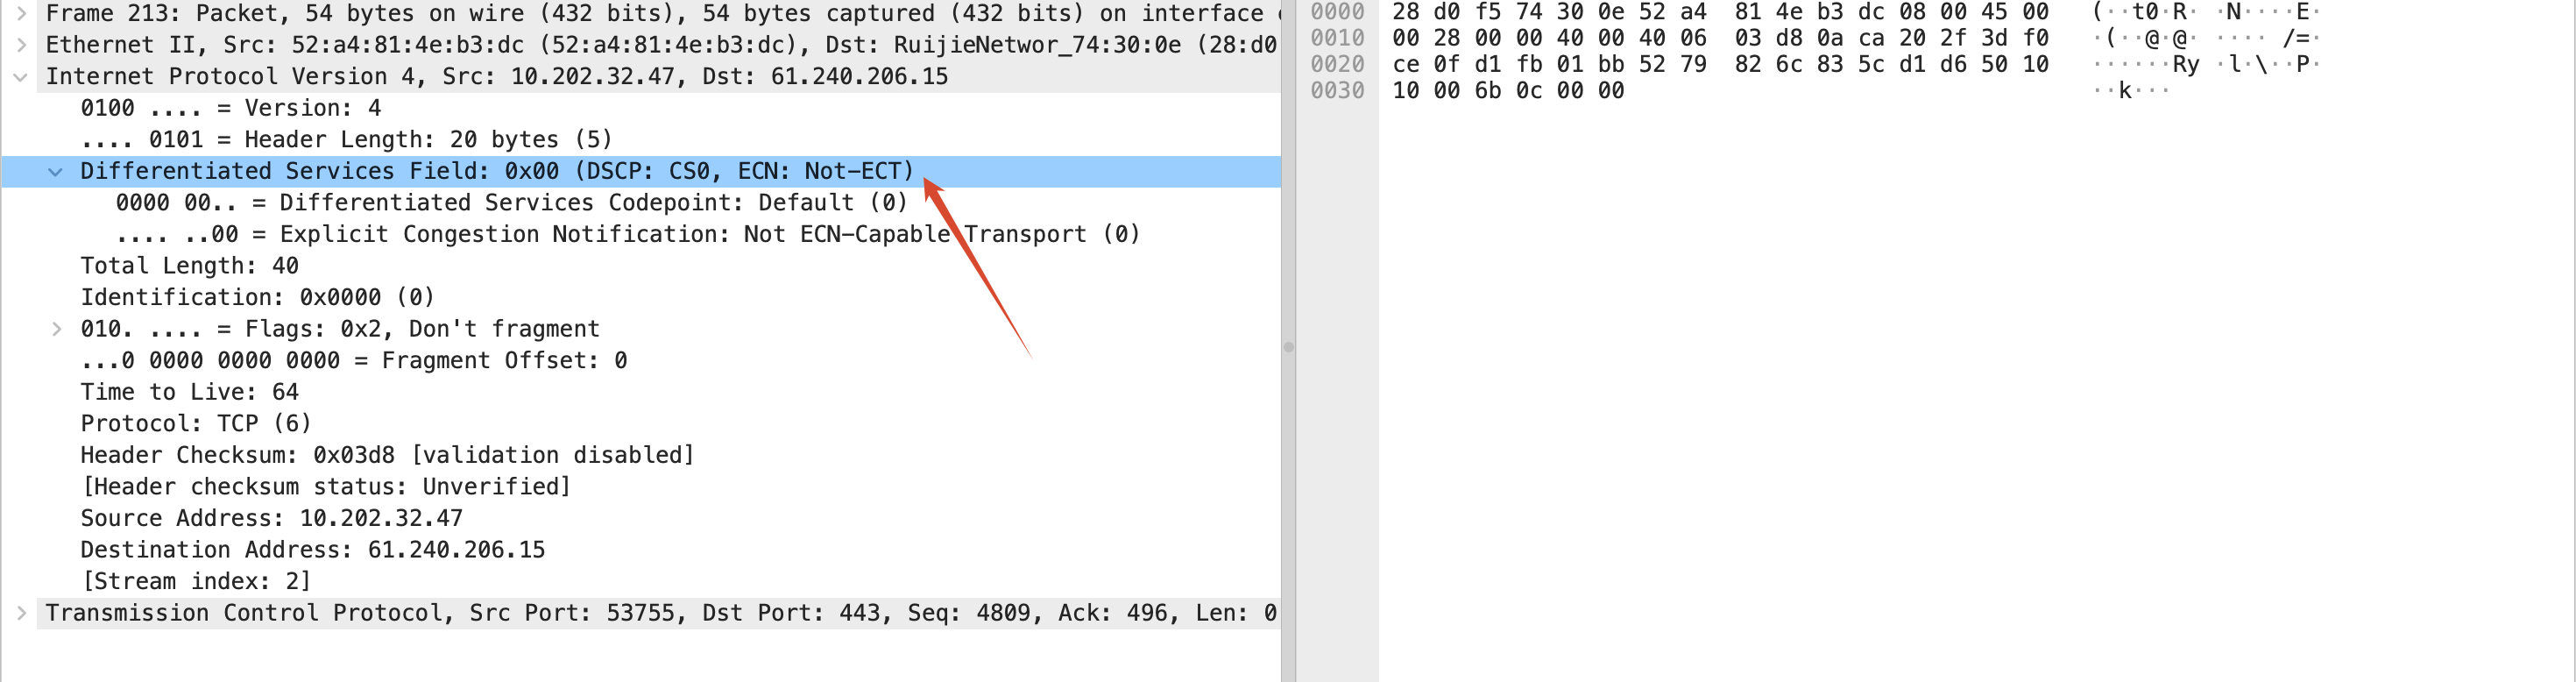
- 区分服务:占 8 位,用于提升网络的服务质量(QoS),当这个字段的值不是 0 的时候,就代表这是一个比较特殊的数据包,可能要优先通过之类的,合理安排,可以提升网络的服务质量,但是一般不太考这个字段。很明显这是一个非特殊的数据包,因为他的区分服务字段值为 0。
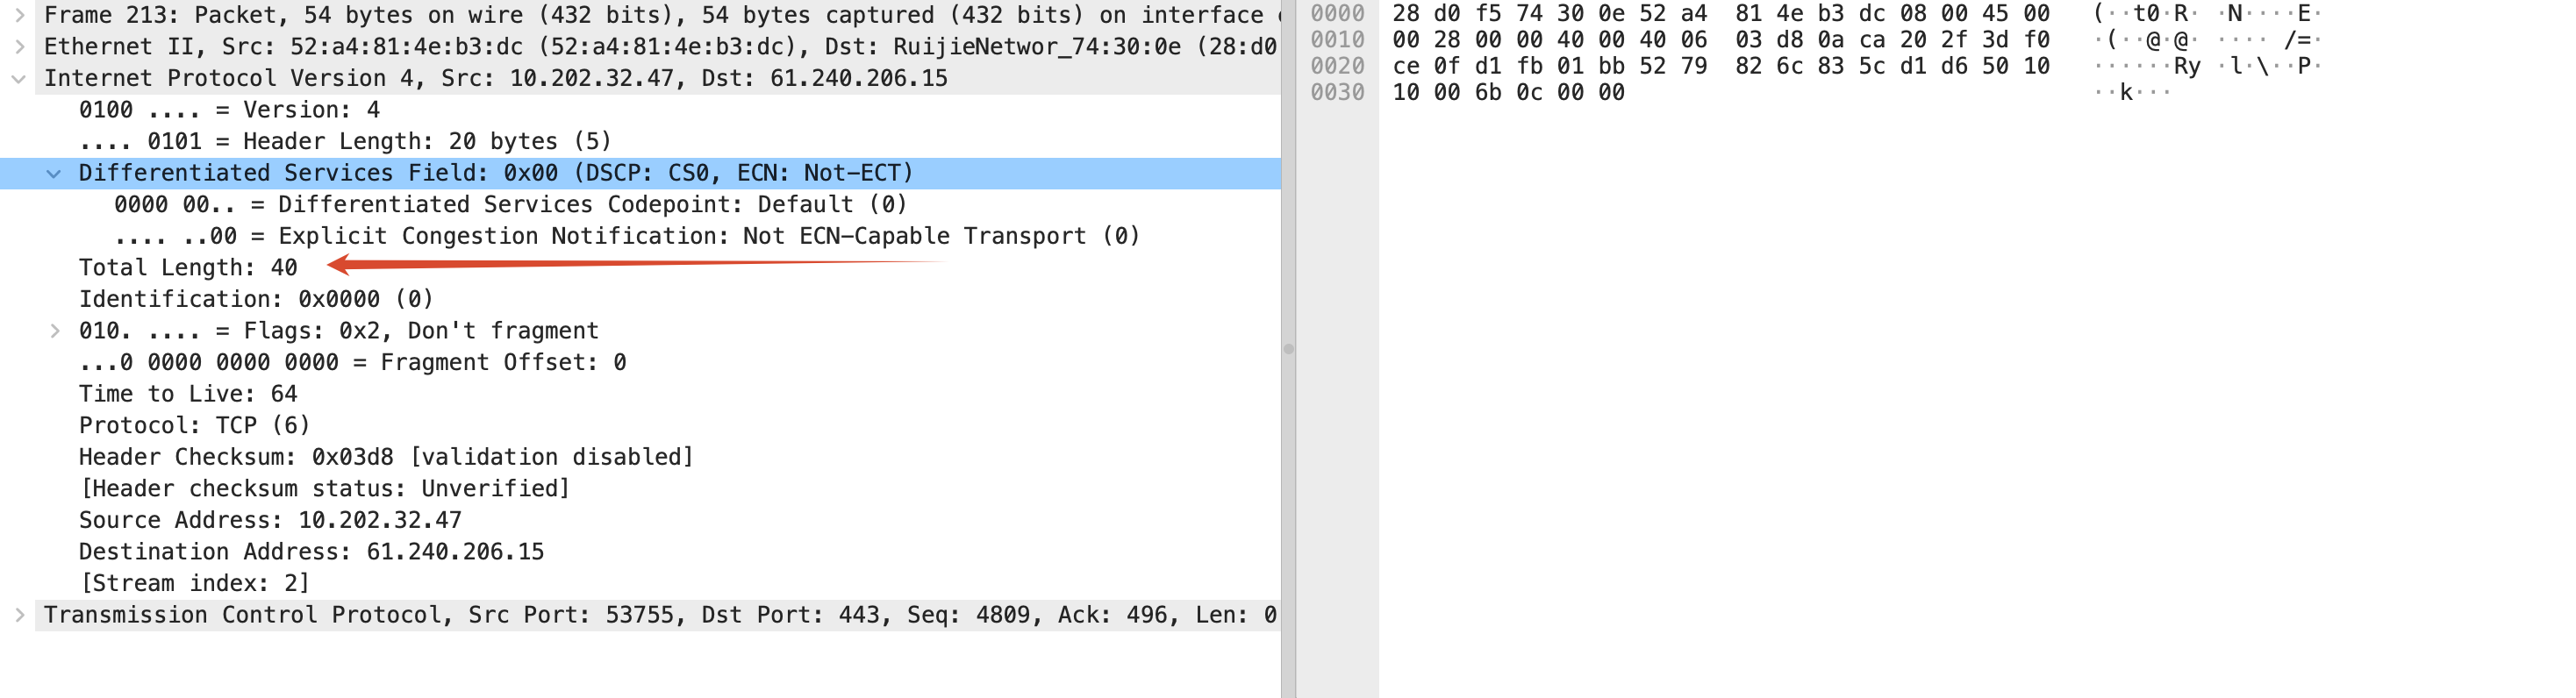
- 总长度:总长度指的是网络数据包首部+网络数据包数据部分的长度之和,这个字段占了 2 字节也就是 16 位,可以表示 0~65535 个字节的长度,总长度最多也就是 65535 个字节。(但是实际上我们知道,数据链路层的帧数据部分也是有长度限制的,例如以太网帧的MTU 是 1500 字节,如果数据包总长度超过了 1500 字节,发送的时候我们就要对数据包进行分片,当然现在更主流的是先协商一下数据帧能塞多少数据进去,主动分好再发送,这样可以保证每一个数据包都能被塞进一个帧里面)例如这个网络数据包的长度为 40,可以直接被封装为一个以太网帧:
- 标识、标志、片偏移:这三个字段就和数据包的分片有关了(请注意,分片以后的数据包依旧是数据包,虽然有的字段在某些情况下看起来有些冗余,但是实际上这让网络层足够通用、自治、兼容异构网络)。
- 标识占 16 位,范围为 0~65535,当数据包过大而被分片的时候,同一个数据包的所有数据片的标识都一样,有一个计数器,专门管理数据包的ID,每发出一个数据包,ID 加一,如果再加一超过了 65535,则重新从 0 开始计数。
- 标志占 3 位:
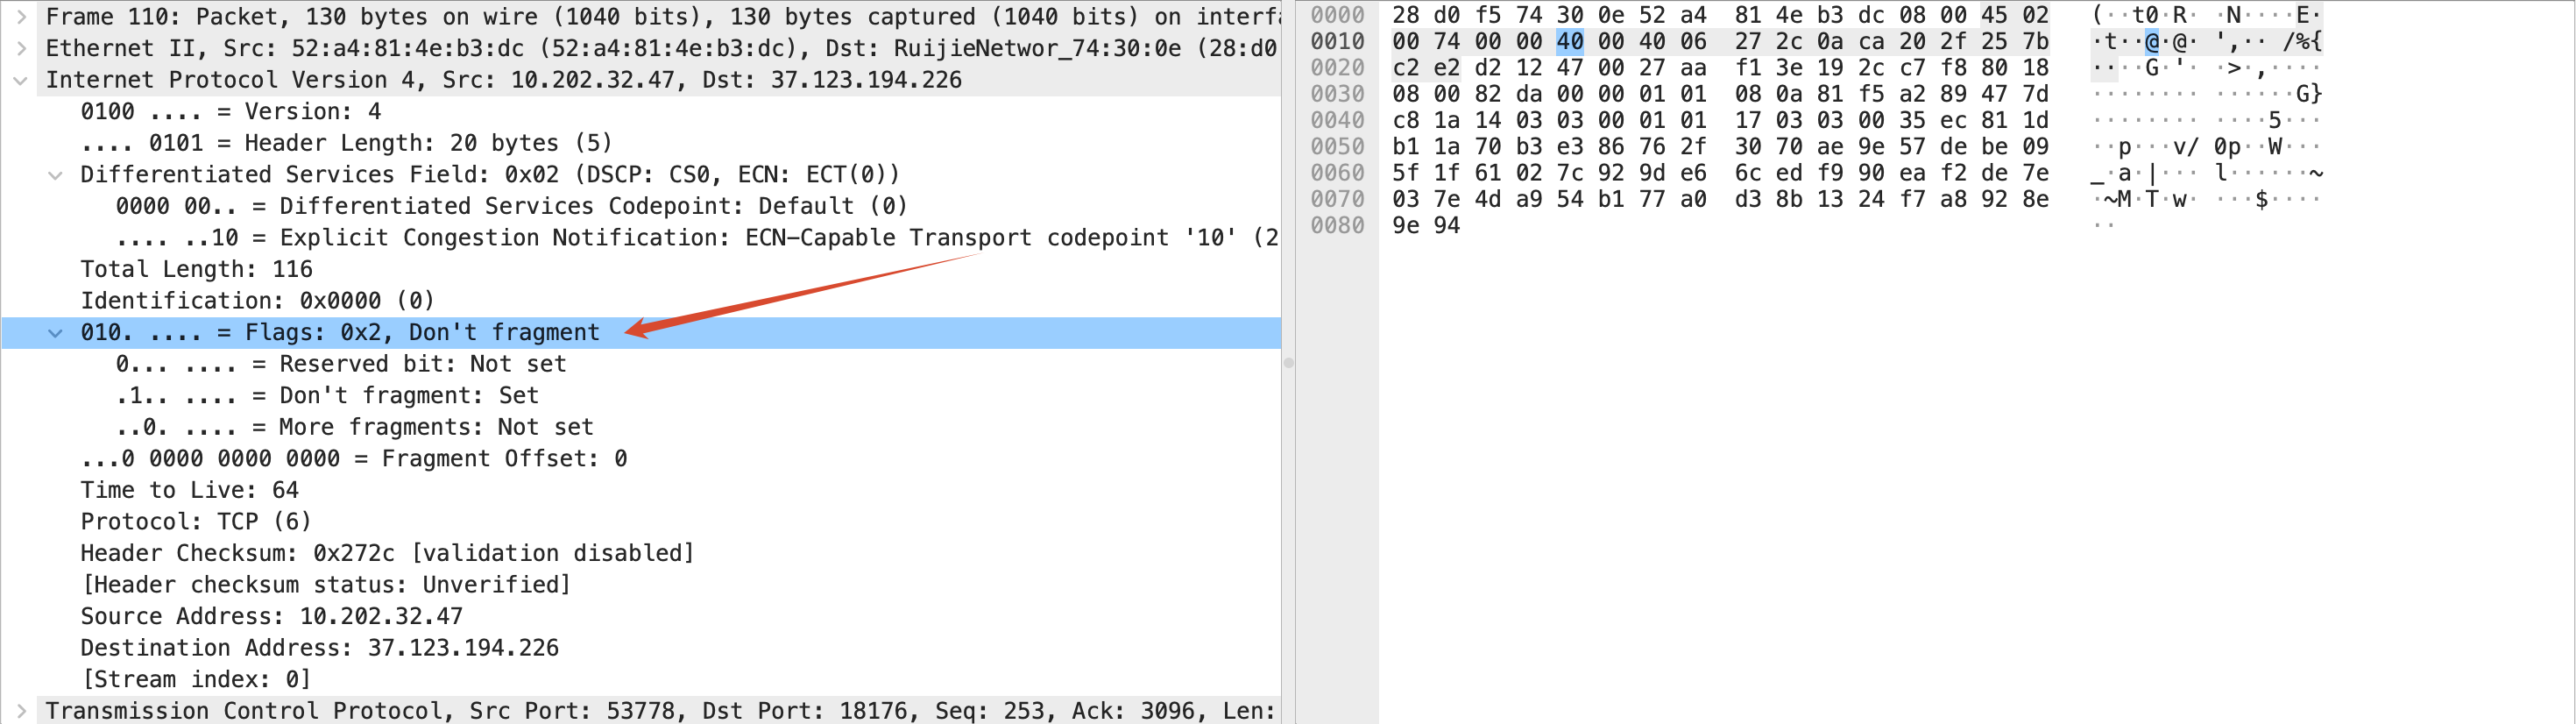
- 第一位是保留位(Reseved),是协议未来扩展预留的位置
- 第二位表达是否分片(DF,don’t fragment),为 1 标识不允许分片,为 0 表示允许分片
- 第三位表达是否是最后一片(MF,more fragment),为 1 表示不是最后一片,为 0 表示是最后一片
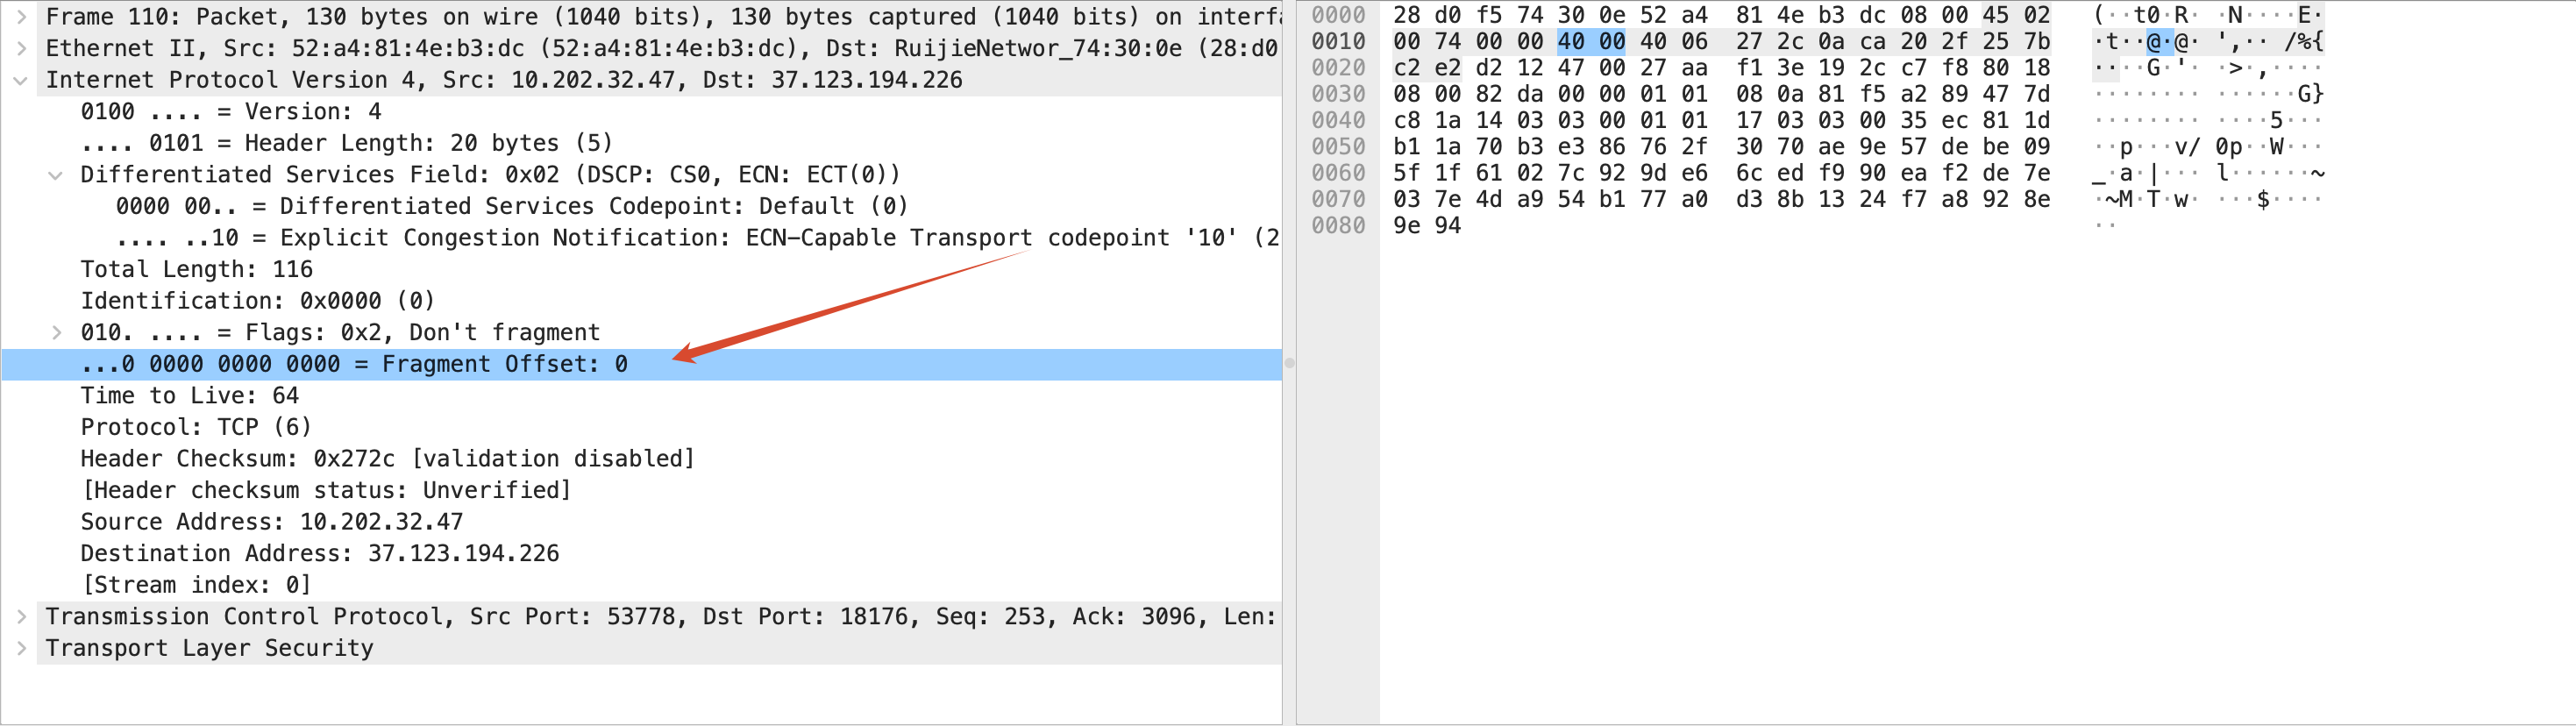
- 片偏移占 13 位,用片偏移乘以 8 得到字节偏移(数据包长度最大正好是片偏移能表示的最大长度的 8 倍,占 16 位),字节偏移表示的是,这个片是从整个数据包的第几个开始字节开始,每一个片的长度一定是 8 的整数倍。可以根据偏移判断那个片在前,那个片在后。
- 生存时间(TTL):占 8 位,每个路由器在转发之前都会将 TTL 减 1,一旦发现 TTL 减为 0,路由器就会返回错误报告,TTL 最核心的作用就是:防止 IP 数据报因路由环路而在网络中无限转发。 假如路由表配置错误,例如 A 默认路由是 B,B 的默认路由是 A,如果通过 A 发送数据,A 不知道数据发哪里就会发给 B,假如此时 B 也不知道要去哪里,他就会走默认路由发回给 A,如果没有 TTL 他就会永远循环下去。不同的操作系统有不同的 TTL:
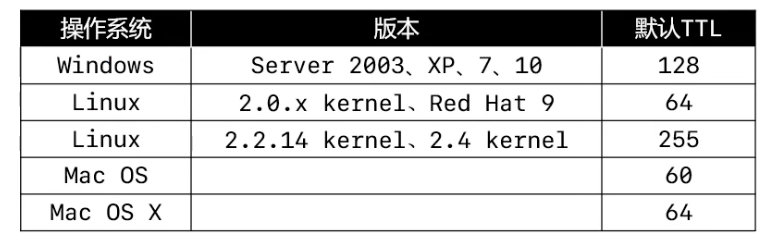 所以我们其实可以通过 TTL 猜测服务器使用的是哪个操作系统,例如:
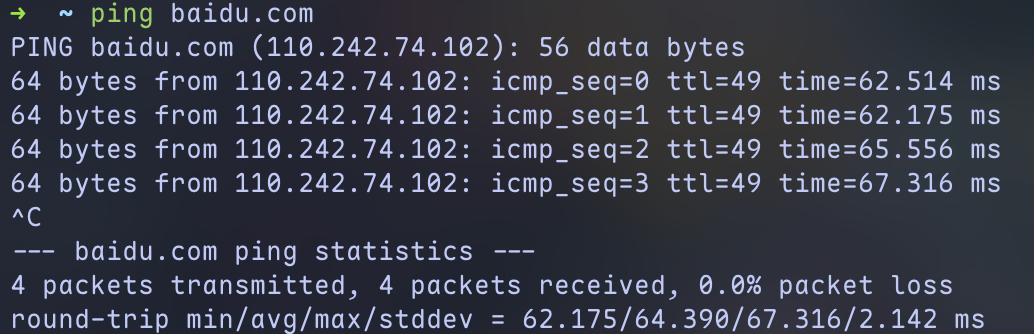 可以猜测百度大概部署在 Linux 上,并且使用的是 2.0.x kernel 或者 Red Hat 9,剩余的 TTL 还有 49,说明经过了 64 - 49 = 15 个路由器(三层设备),如果想详细查看这个过程,我们可以使用命令
traceroute baidu.com来查看,将会得到很有趣的结果。
补充:
有些路由器会故意不回复这种 ICMP或者路由器不响应 traceroute,所以这里就可能显示成 * ,另外我这里显示出来的前几跳也很有意思,
192.168.75.138是私网 IP,而第二跳和第三跳实际上是更大的私网下的私网 IP,这说明,我的请求是先发给我附近的路由器,再发给学校的路由器,然后发给运营商,再上到公网。
- 协议:用于标识使用的是哪个协议,通常来说是运输层协议,但是有的协议可能没有用到运输层,例如 IP 协议、ARP 协议、ICMP 协议,一般也可以被标识出来。常用的协议及其编号:

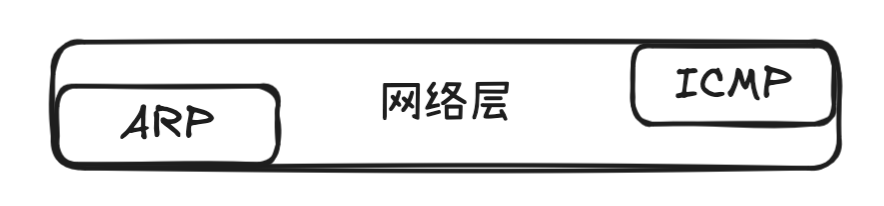
补充:ARP 协议如果在 Packy Tracer 里面看的话会发现他没有网络层,而 ICMP 协议实际上又要被封装在 IP 数据包中,看起来似乎也不是真正的网络层协议,但是我们都认为,ARP 和 ICMP 是网络层协议,因为协议分层主要看它“为谁服务、解决什么问题”,而不只是看它封装在哪一层之上。 可能我们会看到有的人是这样画图的,就是表达这个意思:
- 首部检验和:是用于检测 IP 首部在传输过程中是否发生差错的字段,它只检验 IP 首部,不检验数据部分,长度为 16 位。 IP 首部中的 TTL(生存时间)每经过一个路由器都会减 1,这种 IP 首部的快速变动可能会出问题,但是如果整个 IP 数据包都进行检验,成本就太高了,所以只检验首部是一个很好的办法,减小出错的风险且代价也不是很大。
- 求首部检验和:
- 先把首部按照 16 bit 一组划分
- 将首部检验和字段先置为 0
- 将分好组的首部进行 16 位对位加法,如果产生了第 17 位进位,就将进位加到最低位上去,这种其实就是 回卷
- 把得到的结果按位取反,得到首部校验和,填入 IP 首部对应的字段。
- 校验:
- 接收方接收到报文后,现将整个首部(包括检验和字段)按照 16 位一组划分
- 减分好组的首部进行 16 位对位加法,规则和求首部校验和一致,如果得到的结果是 16 个 1(
1111111111111111)也就是0xFFFF,则代表检验通过
- 求首部检验和:
- 源 IP 地址:发送信息的主机的 IP
- 目标 IP 地址:接受信息的主机的 IP
可选部分
一般来说用不到,因为处理可选字段比较麻烦,现代互联网中很少用到这个部分。
可选字段(Options)用于在 IPv4 首部中携带额外控制和测试信息,如记录路由、时间戳和源路由
填充部分
它只有一个目的:把首部长度补成 4 字节(32 bit)的整数倍。 做对齐,这样可以提高读取效率,处理器习惯于一次读取 4 字节。
数据部分
网络层的数据部分不一定是运输层传下来的,因为有的协议根本就没有用到运输层,例如 ICMP 就绕过了运输层,这样在 IP 数据包首部里面,协议字段就被标记为 ICMP 协议,数据部分就会是 ICMP 头 + ICMP 数据。
运输层
运输层传输的数据格式是 段,但是 UDP 的数据格式是 UDP datagram 而 TCP 的数据格式是 TCP segment,主要是 TCP 和 UDP 的设计理念不同导致的,TCP 面向连接,建立连接后发数据是一段一段发过来的,所以叫做 TCP 报文段,而 UDP 是无连接的,UDP 就直接包装发出去,所以还是叫做 UDP 数据报。
运输层我们需要学习的协议主要只有两个,UDP 协议和 TCP 协议,考研对这两个协议特别是 TCP 协议有比较高的要求,必须要好好掌握。
简单对比 TCP 和 UDP 我们可以得到一张表:
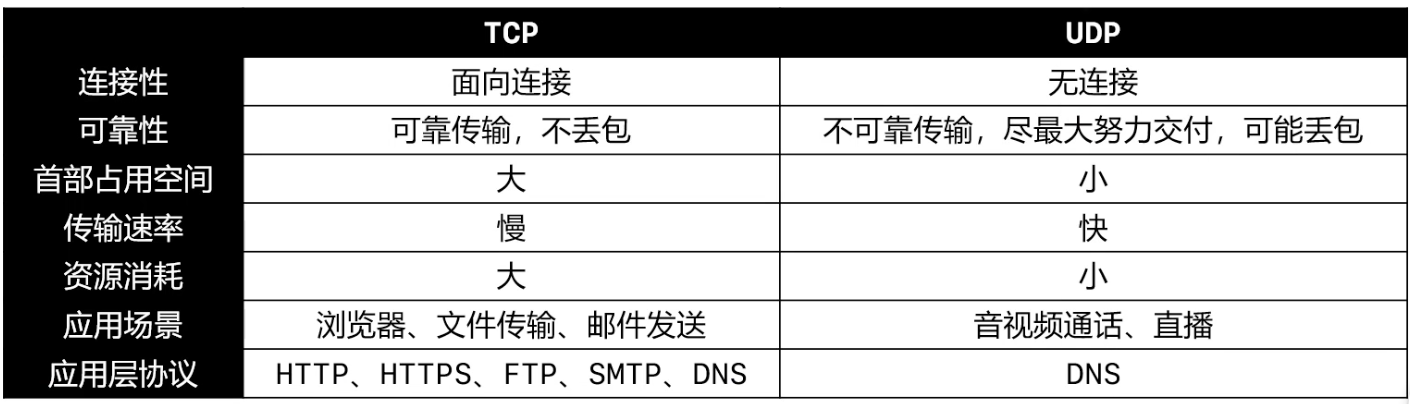
总的来说 UDP 比 TCP 简单很多,考试的要求也没有 TCP 那么高。
我们可以看到 DNS 既可以用 TCP 也可以用 UDP,具体是什么时候用 TCP 什么时候用 UDP 要根据具体情况而定,可以参考这个帖子:Why is UDP is the default protocol?
UDP(User Datagram Protocol)用户数据报协议
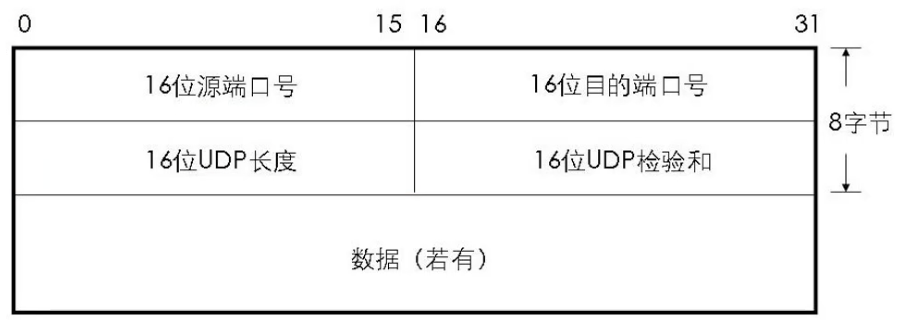
UDP 的数据格式是 UDP datagram(UDP 用户数据报),UDP 是 无连接的,也就是不需要建立连接,直接传输数据,这也就减少了建立和释放连接的开销。UDP也不管可靠传输,UDP 只是尽最大努力交付,不保证可靠交付。因此,UDP 不需要维护复杂的参数字段,他的结构非常简单:
UDP首部
UDP首部只有 8 个字节,仅仅包括四个字段:
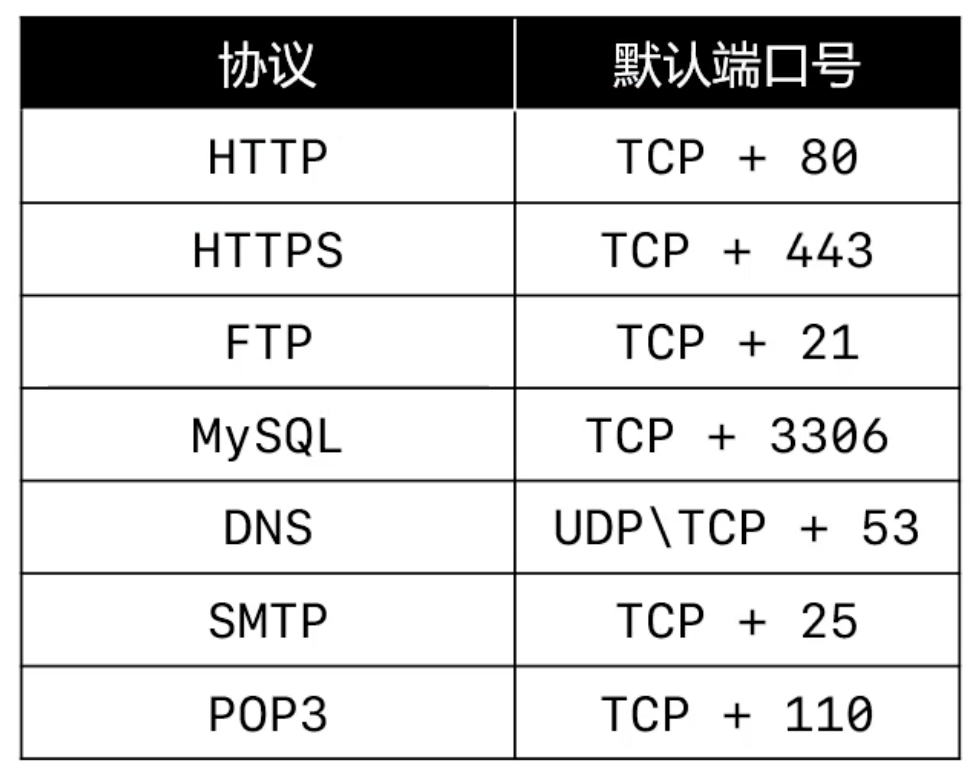
- 源端口号:占 16 位,是发送数据的端口的端口号,端口号取值范围为 0~65535。IP 地址已经在 IP 首部里了,UDP 首部没有必要保存一遍,网络协议是分层设计的。网络层负责主机,IP 协议关心的是数据应该送到哪一台机器。运输层负责的是进程,数据已经抵达目标主机以后,应该交给目标主机的哪个进程。 主机端的端口号一般是固定的,比如我们可以指定端口 5000,客户端的端口则是随机开启的临时端口。这里有一些默认的端口号,一般服务器防火墙会放行这些端口,防火墙可以开关默写端口提高服务器安全性:
- 目的端口号:占 16 位,是接受数据的端口的端口号。具体说明同源端口号。
- UDP 长度:占 16 位,表达的是 UDP 首部的长度 + 数据的长度。
UDP datagram(用户数据报)的长度限制如下:
最短长度:8 字节 UDP 数据报由 8 字节的固定头部和可选的数据载荷(Payload)组成。当数据报不包含任何应用层数据时,其最短长度即为 8 字节(仅包含 UDP 头部)。
最长长度:65535 字节 UDP 头部中包含一个 16 位的Length(总长度)字段,用于指示 UDP 数据报的总字节数(包含 8 字节头部和数据载荷)。16 位无符号整数的最大值为 ,即 65535 字节。
补充说明(实际网络中的限制): 虽然 UDP 协议理论上支持最大 65535 字节,但在实际网络传输中会受到底层网络 MTU(Maximum Transmission Unit,最大传输单元)的限制:- IP 分片风险:标准以太网的 MTU 通常为 1500 字节,所以一般我们会限制 UDP 数据报总长度小于等于 1472 字节。如果 UDP 数据报过大,IP 层会将其分片传输,这会显著增加丢包风险和处理延迟。(IP 分片可靠性差:一个数据报分成多片后,只要其中一片丢失,整个数据报都得重传。路由器负担大:分片需要在沿途路由器上做,会增加路由器的处理开销。重组复杂:IP 分片需要在接收端网络层重组,乱序到达时还要等待和缓存。)
- 实际建议长度:为了避免 IP 分片,实际开发中通常建议 UDP 数据报的总长度不超过 MTU 减去 IP 头部(通常 20 字节)和 UDP 头部(8 字节)的大小,即 1472 字节(1500 - 20 - 8)。
- UDP 检验和:占 16 位,检验和计算的内容为伪首部、首部、数据。伪首部包含了源 IP 地址、目标 IP 地址、保留字段、协议号、UDP 长度。伪首部占 12 字节,伪首部包含 IP 地址是为了检验数据传输是否将数据传输到正确的机器上,如果不检查 IP 的话,数据可能传输到错误的主机上而这个错误没有被校验。另外 UDP 检验和还需要 UDP 长度,UDP 的首部已经有了 UDP 长度,伪首部还需要一个 UDP 长度是为了保证长度字段在 IP 层和 UDP 层之间出现不一致也能被发现,否则,如果 UDP 首部里的 UDP 长度字段损坏了,接收方就有可能按照错误的长度去获取数据。UDP 检验和的计算和 IP 首部检验和很像,拿到 UDP 伪首部、UDP 首部(检验和部分先全部置为 0)和数据以后,也是先按照 16 位分组,然后对位相加,如果最高位产生进位就回卷,加到最低位上去,之后按位取反再写入 UDP 首部。接收方计算也是拿到 UDP 伪首部、UDP 首部(同时这里面是有有效 UDP 检验合格)、数据以后按照 16 位分组,依旧对位相加,最高位进位就加到最低位,检查最终得到的结果是不是 0xFFFF 也就是 16 个 1,若不是则说明出现错误。 不过伪首部是不会传递给网络层的,仅仅是在计算 UDP 检验和的时候起作用。
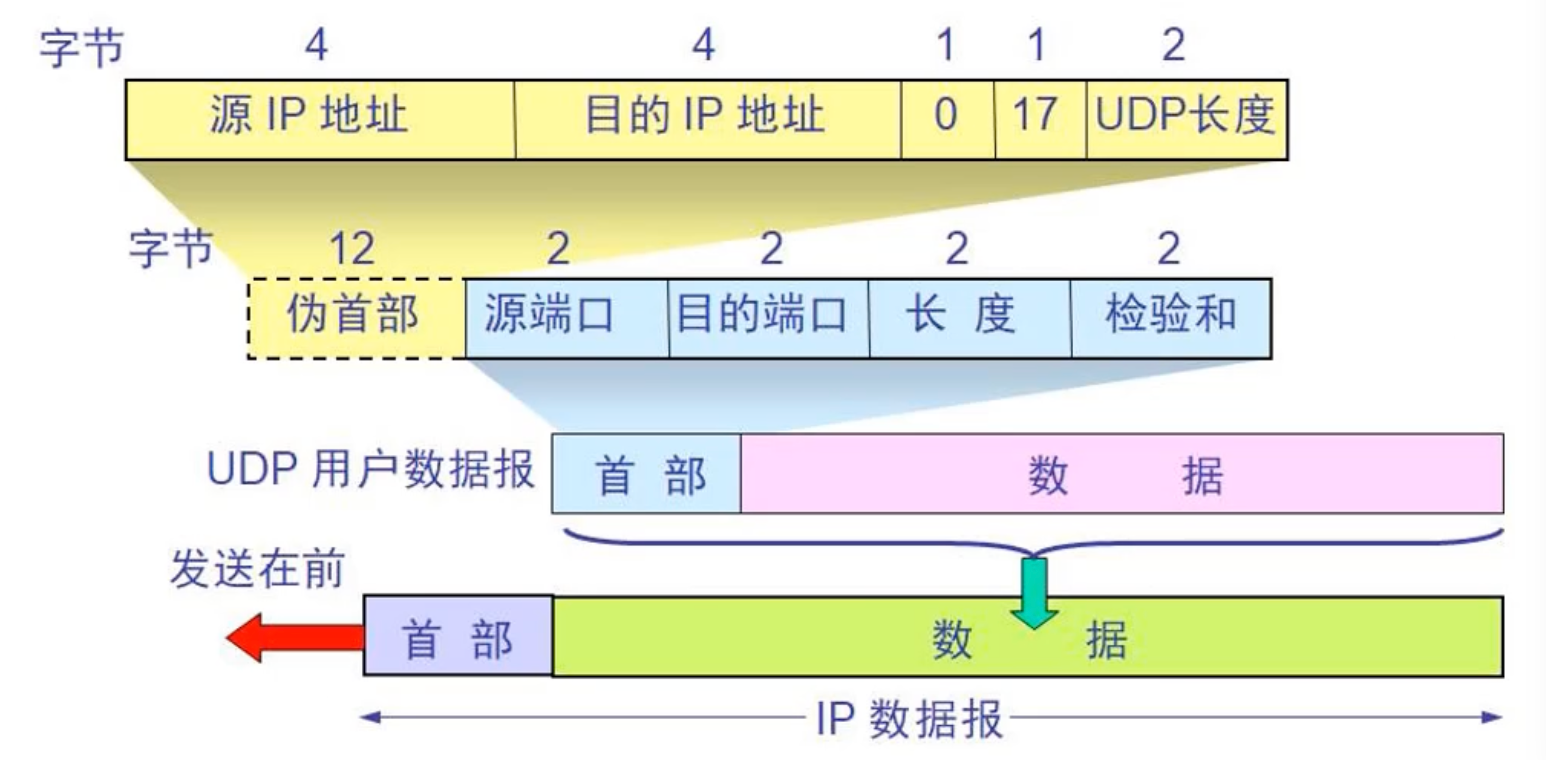
UDP 数据部分
可以参考 UDP首部 里面关于 UDP 长度的部分。UDP 数据部分长度 = UDP 长度 - UDP 首部长度(8 字节)
TCP(Transmission Control Protocol)传输控制协议
TCP 的数据格式是 TCP Segment(TCP 报文段)。TCP 比 UDP 复杂得多,TCP 需要解决的问题有:可靠传输、流量控制、拥塞控制、连接管理。
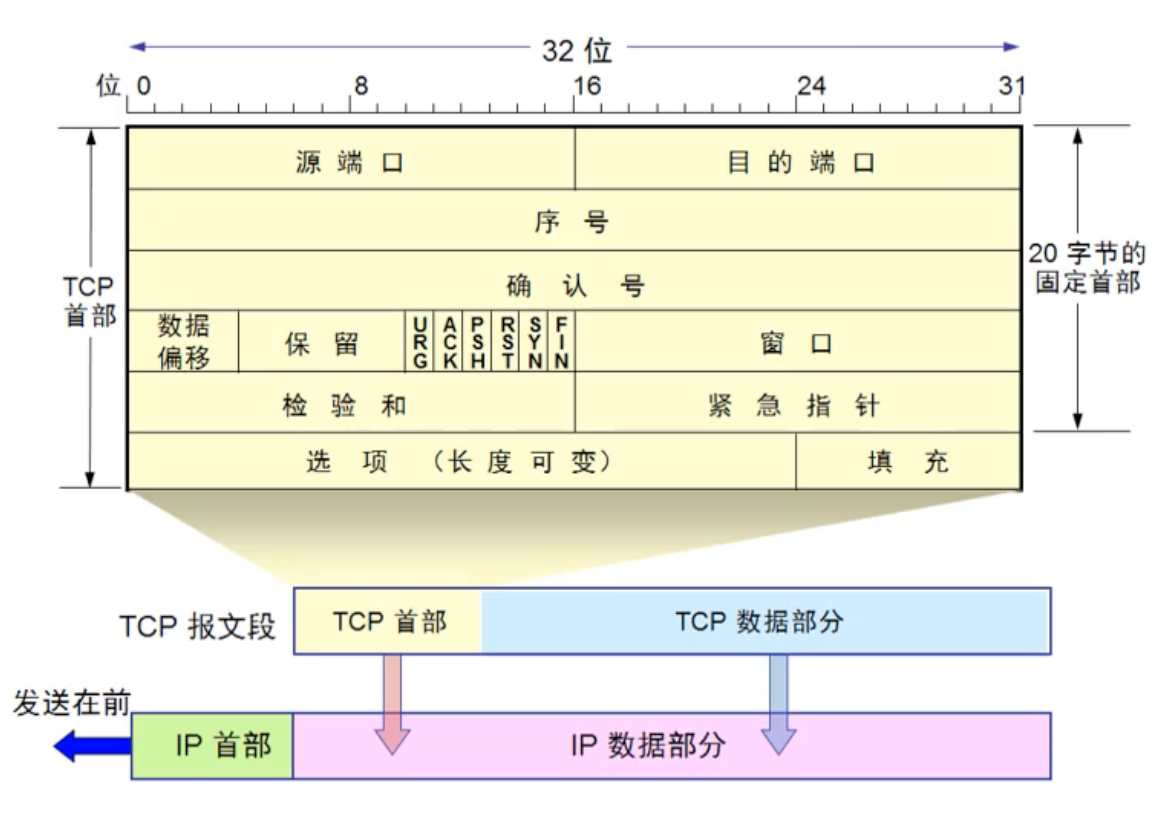
TCP首部
TCP 为了实现可靠传输、流量控制、拥塞控制、连接控制,设计了比较复杂的头部。
TCP 首部也是分为固定部分、可选部分、填充部分这三个部分,和网络数据包首部类似。
TCP 首部一般 20 字节和 32 字节的情况见得多,一般默认都是 20 字节,出现 32 字节往往是在建立连接的时候。
固定部分
-
源端口号:和 UDP 的源端口号意义相同。
-
目标端口号:和 UDP 的目标端口号意义相同。
-
序号:占 4 个字节,在传输过程的每一个字节都有相应的编号,在建立连接以后,序号表示这一次传递给对方的 TCP 数据部分的第一个字节的编号。
-
确认号:占 4 个字节,在建立连接以后,确认号表示期望下一次对方发来的 TCP 数据部分的第一个字节的序号。
-
数据偏移:占 4 位,数据偏移乘以 4 得到首部长度。数据偏移的取值范围为 0x0101~0x1111,表示首部长度的取值范围为 20~60字节。其实知道首部长度,就可以通过网络层数据包里面的首部长度和总长度推算出 TCP 报文段的数据部分长度。不仅仅是 TCP,实际上 UDP 也可以如此,UDP 使用一个 16 位长度的字段表示整个 UDP 用户数据报的长度但这实际上是冗余的,本身 UDP 的首部长度就是固定的,可以直接通过网络数据包的首部长度和总长度计算出 UDP 用户数据报的数据部分长度,这个 16 位长度的字段主要是为了保证首部 32 bit对齐。
-
保留:占 6 位,目前全为 0,保留方便以后扩展协议。
-
标志位,共 6 个标志,每个标志占 1 位,共 6 位:
- URG(Urgent):当 URG = 1 时,紧急指针字段才有效,表明当前报文段中有紧急数据,应该尽快传送。
- ACK(Acknowledgement):当 ACK = 1 时,确认字段才有效,
- (Push):当 PSH = 1 时,通知接收方的 TCP 协议栈:不要将当前数据缓存在缓冲区中等待凑满,而应立即将其”推”(Push)交给上层应用程序处理
TCP 是面向字节流的协议,为了提高传输效率,收发双方通常都会使用缓冲机制:发送端缓冲: 应用层写入的数据可能很小(比如几个字节),TCP 会将其暂存,等积累到一定量或超时后再封装成报文段发出(Nagle 算法就是典型代表)。接收端缓冲: 收到数据后,TCP 可能不会立刻通知应用层,而是等缓冲区积攒了一定量的数据后再一次性上交,以减少系统调用开销。这种缓冲机制虽然提高了吞吐量,但会带来延迟。对于交互式应用(如 Telnet、SSH),用户每敲一个键都希望服务器立即响应,如果数据被缓冲”卡住”了,体验就会极差。PSH 就是为了解决这个问题而设计的。
- RST(Reset):当 RST = 1 的时候,表明连接中出现严重差错,必须释放连接然后重新建立连接
- SYN(Syncronization):
- 当 SYN = 1、ACK = 0 时,表明这是一个建立连接的请求
- 若对方同意建立连接,则回复 SYN = 1、ACK = 1
- FIN(Finish):当 FIN = 1 时,表明数据已经发送完毕,要求释放连接
在有的资料里面说,保留位为 3 位而标志位为 9 位,这种说法也是对的,因为如果说 9 位标志位里面有 3 位一般没什么用,一般只用其中的 6 位,所以也可以认为这三位是保留位。WireShark 当中也是保留位为 3 位,标志位为 9 位。
- 窗口:这个字段有流量控制功能,用以告知对方下一次允许发送的数据大小(字节为单位)
- 检验和:TCP 的检验和和 UDP 的检验和的计算方法差不多,计算内容都是:伪首部、首部、数据部分,TCP 的伪首部也是 12 字节,也是仅仅在计算检验和时有作用,并不会传递给网络层。并且结构上也几乎和 UDP 的伪首部一样,只是把 UDP Length 字段换成了 TCP Length 字段而已。
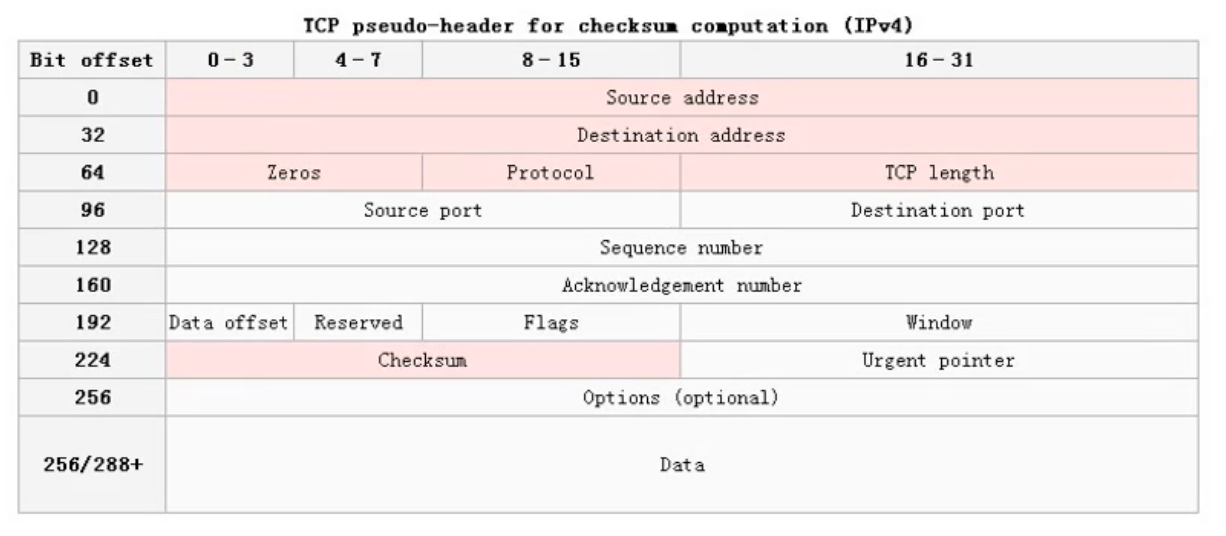
- 紧急指针:紧急指针存放的是一个偏移量(Offset),而不是一个绝对的内存地址或序列号。
- 具体含义: 它表示从当前 TCP 段的序号(Sequence Number)开始,到紧急数据最后一个字节之间的字节偏移量。
- 计算公式:
紧急数据末尾位置 = 当前段序号 + 紧急指针值 - 单位: 字节(Bytes)。
注意: 紧急指针指向的是紧急数据的最后一个字节,而不是第一个字节。这是 RFC 793 定义的标准行为(尽管历史上 BSD 的实现曾有过指向“下一个字节”的歧义,但现代标准遵循 RFC 793/RFC 6093)。
可选部分
填充部分
TCP数据部分
可靠传输
停止等待 ARQ 协议
ARQ(Automatic Repeat-Reqeust)自动重传请求。ARQ 有以下几种情况:
- 无差错:传输没有出现错误,发送方发送数据给接收方,接收方接收到数据以后返回确认给发送方,发送方收到确认后,按顺序继续发送下一个数据。
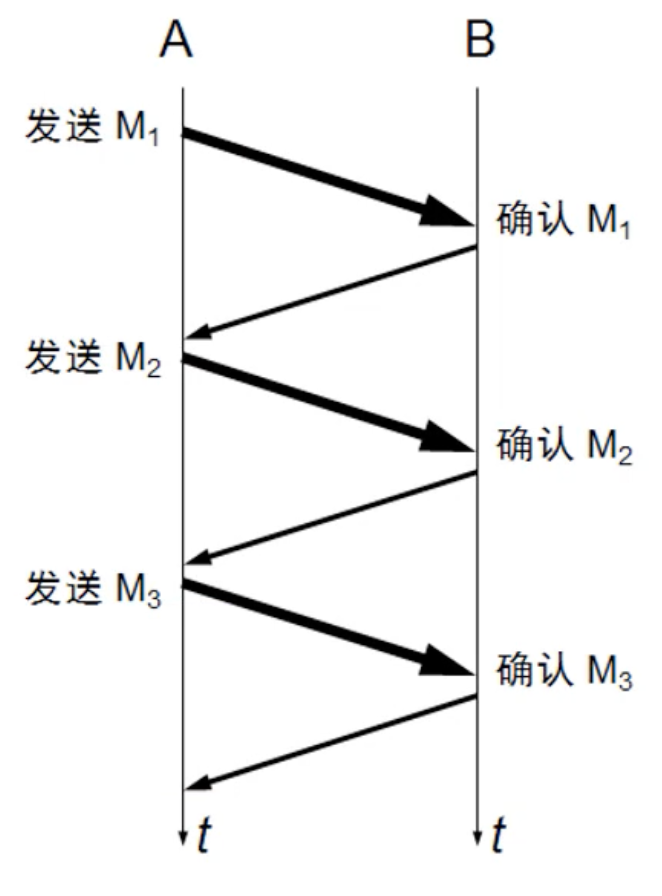
- 超时重传:发送发送数据给接收方,接收方发现传输的数据有问题,或者因为网络问题,接收方根本就没有收到数据,接收方就不会发送确认给接收方,接收方在一段时间没有接收到确认后,会再次发送一遍原来的数据。如果,假如因为网络问题,接收方确实刚开始没有收到数据,发送方在过了一段时间以后重新发送了数据,而就在第二次发送的数据还没有抵达接收方的时候,因为网络恢复,接收方突然成功收到了第一次发送的数据,接收方确认数据无误后发送确认给接收方,而之后抵达的第二个数据会被接收方直接丢弃。
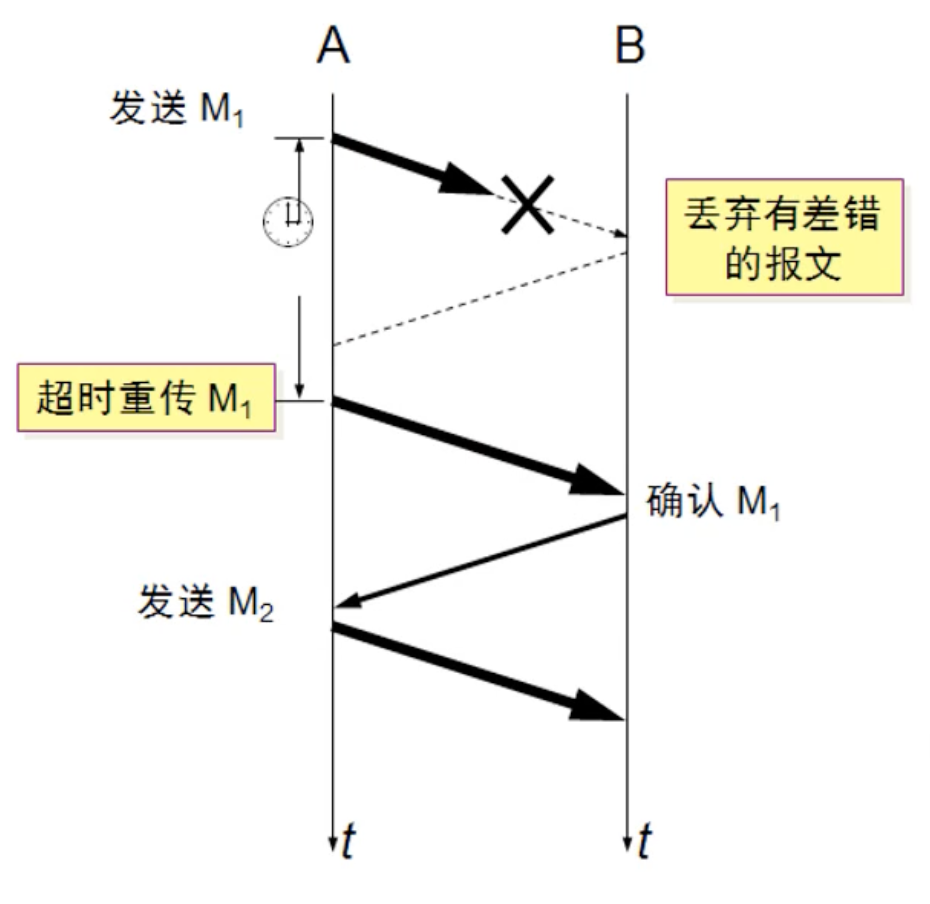
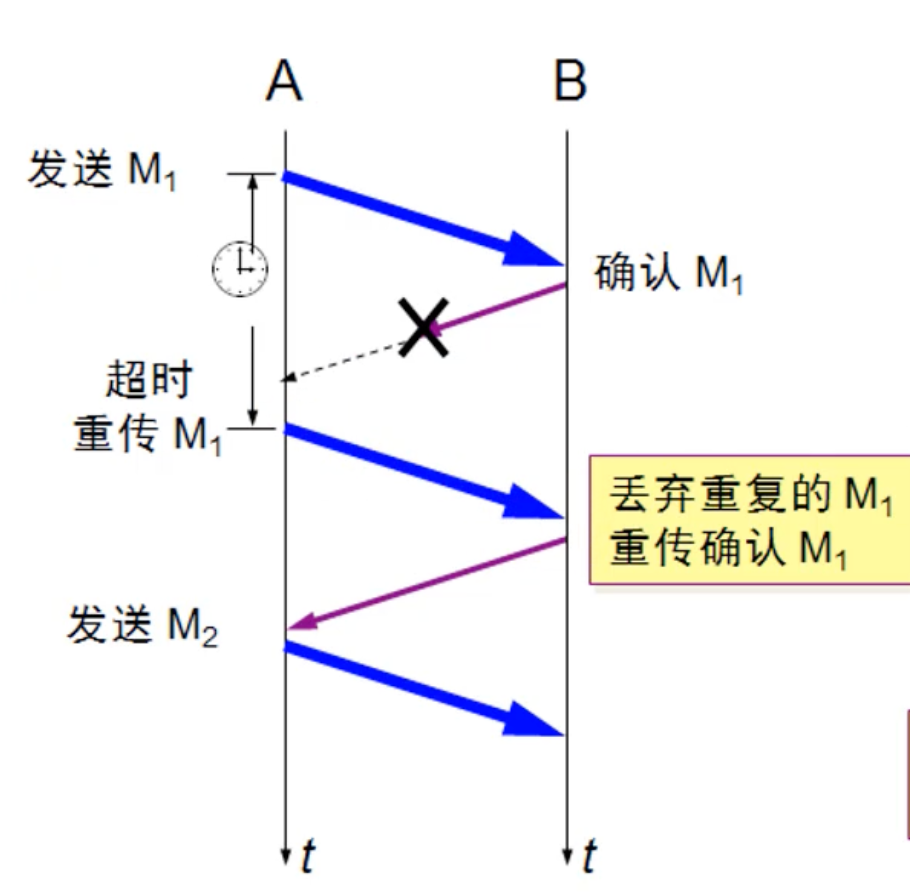
- 确认丢失:如果发送方发送的数据成功被接收方接受,但是接收方发送给发送方的确认因为一些问题丢失了,过一段时间以后,发送方还是会再次发送原来的数据,接收方在收到数据后,会丢弃掉这个重复的数据,并且重新发送一次确认。
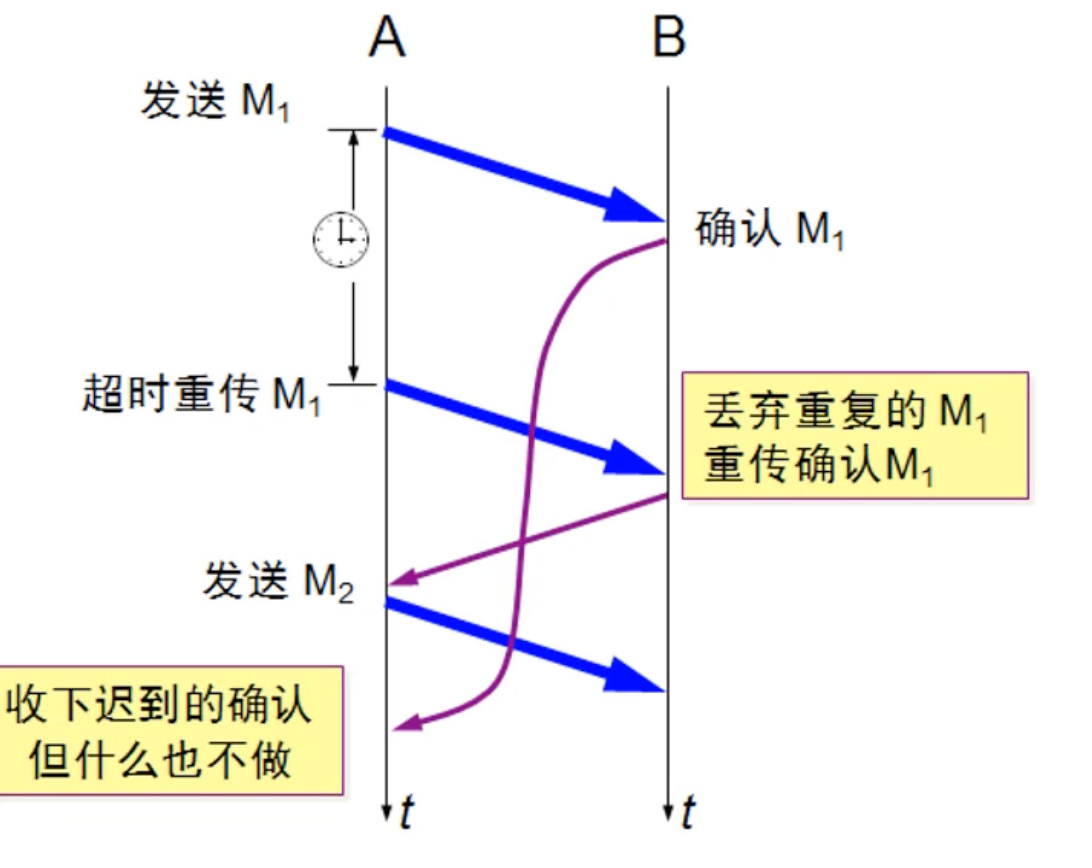
- 确认迟到:如果发送方发送的数据成功被接收方接受,但是接收方发送给发送方的确认因为一些网络问题过了很久才发送到发送方,而发送方因为一段时间没有接收到确认重发了数据,接收方丢弃掉重复的数据发送确认,而这一次接收方的确认被发送方接收了,那发送方就会继续发送下一个数据段,即使后面收到了迟到的确认,也不会对此做出反应。
连续 ARQ 协议 + 滑动窗口协议
如果仅仅是发送一个数据段返回一个确认,收到确认以后再发送一个数据段,这其实效率不是很高,为了提高效率,我们使用连续 ARQ 协议和滑动窗口协议。
互相告诉对方的窗口大小,然后按照窗口大小来传输数据,这样一次就可以传输多个报文段。这个窗口大小不是一直不变的,实际上是会根据双方的具体情况,例如接收方会根据自己还剩多少缓存来决定窗口大小。具体可以看流量控制。
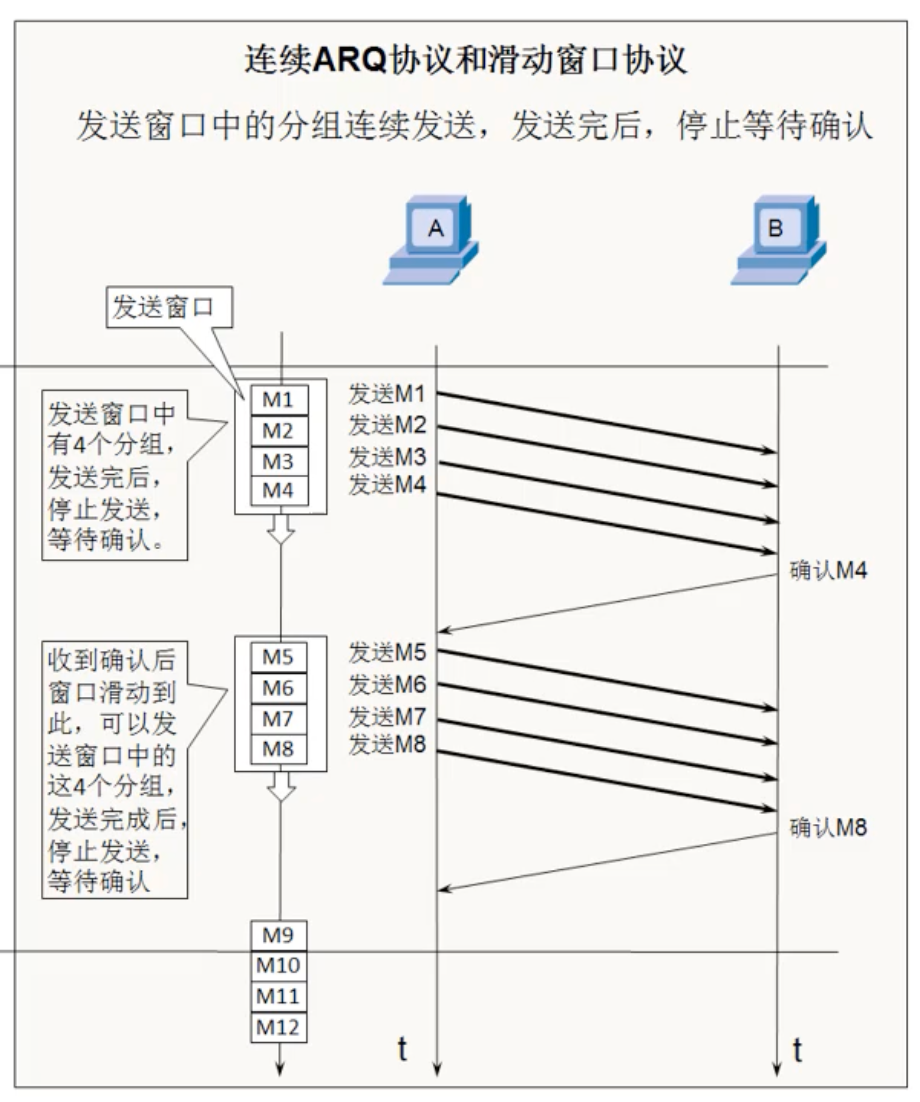
我将整个连续 ARQ 协议和滑动窗口协议的具体过程画成这样的图,方便理解和记忆,具体参考 连续 ARQ 协议和滑动窗口协议。
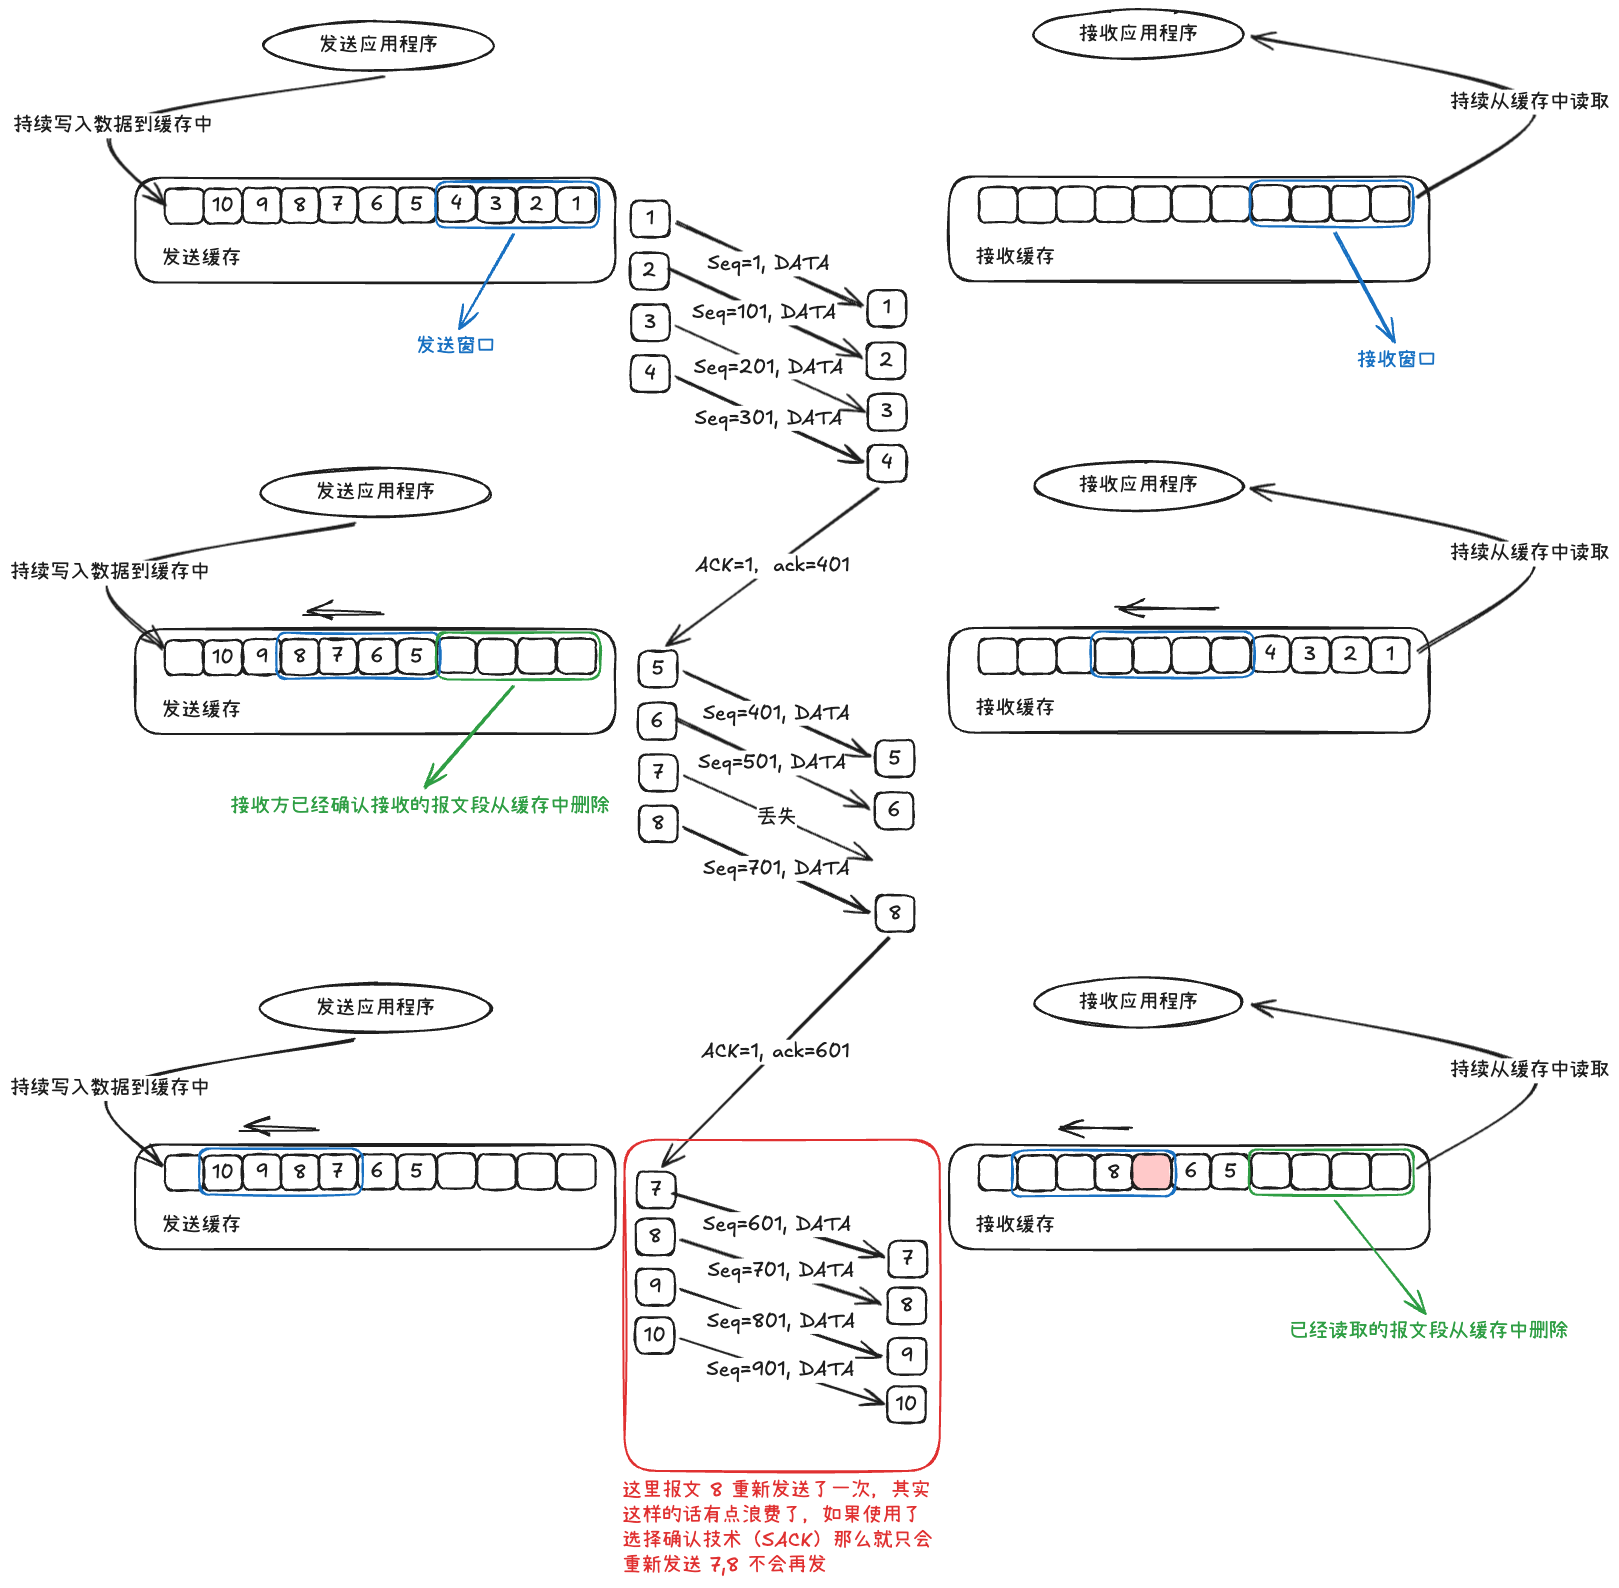
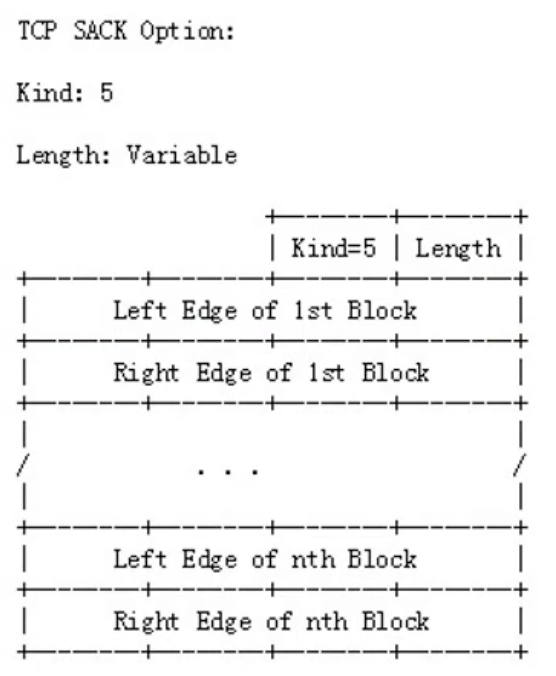
SACK(选择性确认)能够提高选择重传的效率:在 TCP 通信的过程中,如果发送的序列中间某个数据包丢失了,接收方会告诉发送方哪些数据丢失了,哪些数据已经提前收到了,这样就可以只发送丢失的包,而不用像上图一样 7 丢失了 8 也要跟着重传。SACK信息会放在 TCP 首部的可选部分。
这里刚好引出 TCP 首部选项部分:
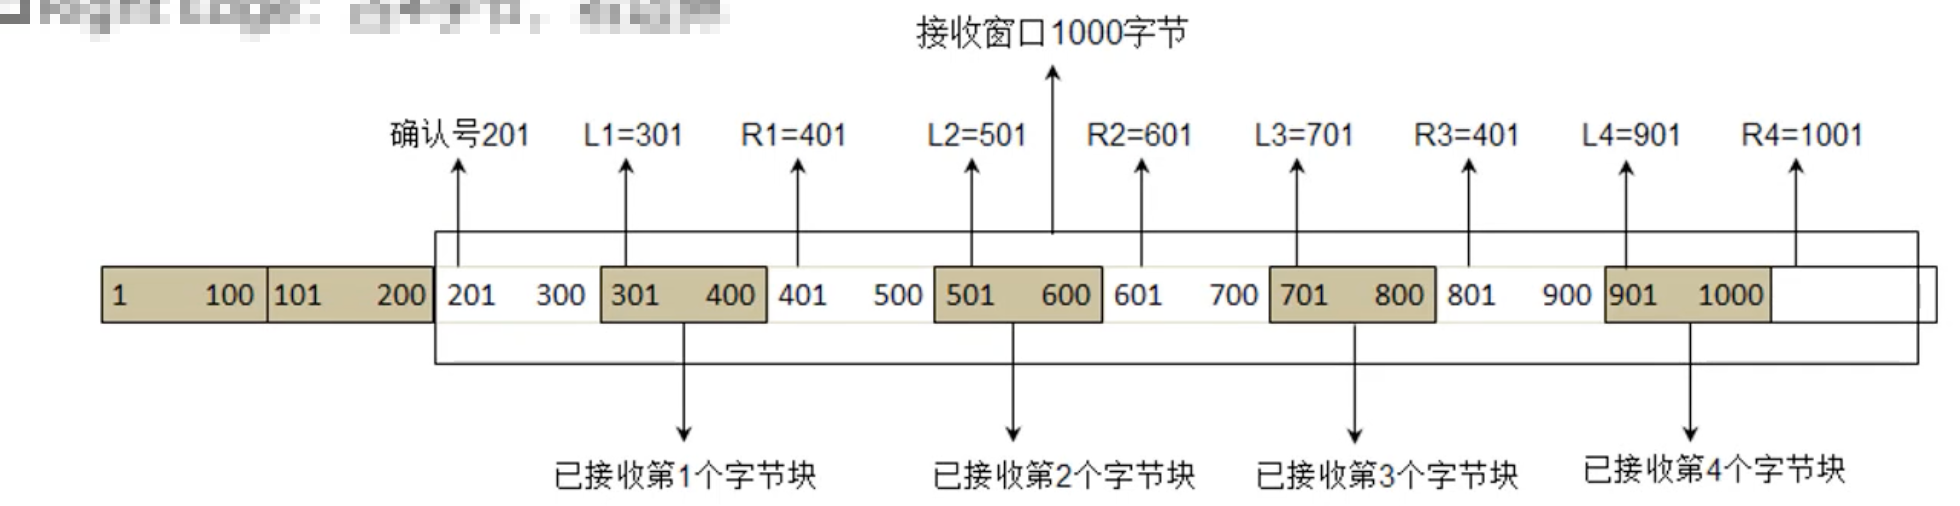
Kind 占一个字节Kind=5表示这是一个 SACK 选项。Length 占一个字节,表明 SACK 选项占多少字节。Left Edge 占 4 个字节,表示左边界,Right Edge 占四个字节表示有边界。通过一对一对的左右边界,我们可以告知发送方哪些数据是被收到了,接收方就可以推算出哪些是没有收到的,就会把没有收到的重发给接收方。不过,我们知道 TCP 的可选部分长度为 0~40 字节,所以 Kind 和 Length 已经占用了 2 字节,也就是说,我们还剩下 38 字节用于携带左右边界,而一对左右边界共 8 个字节,所以 SACK 最多只能携带 4 组边界信息。
补充:
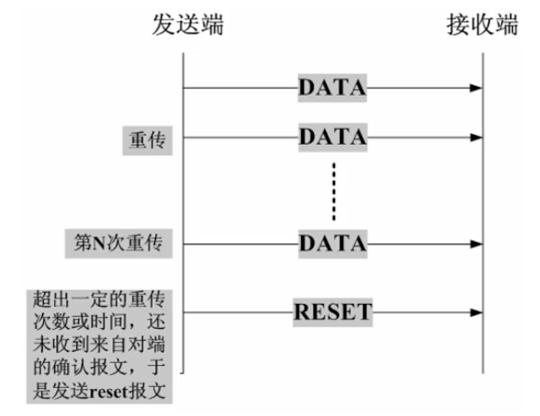
- 如果包一直没有发送成功,是否会一直重发?如果一个包一直没有发送成功,并不会一直尝试发送,其实主要是看系统设置。例如系统设置重传 5 次,如果 5 次都没有发送成功,就会发送 reset 报文(RST)断开TCP 连接;或者系统设置 20s,如果过了 20s 都没有发送成功,就发送 reset 报文断开 TCP 连接。
- 如果发送方发送的数据不满窗口,接收方会怎么样?如果如果接收方告诉发送方,他自己可以接收 400 字节的数据,但是发送方实际只发送了两个 100 字节大小的数据包,那接收方收到这两个包以后,等待一段时间,如果没有第三个包发过来就会发给发送方一个确认,确认收到两个包。
- 为什么在传输层就将数据分成多个段而不是等到网络层再进行分片传递给数据链路层呢? 首先是在传输层就将拆分数据可以提升重传的性能,如果在传输层是一个非常大的数据段,那么正常来说接下来是在网络层分片,然后每一个片在数据链路层封装成帧然后交给物理层做传输,那么如果在传输过程中,一个帧或者说一个网络层的包丢掉了,在对方的运输层看来,就是整个大的数据段传输失败了,重传就又要传输一个这么大的数据段,对于重传来说,这太不划算了,而如果在传输成就直接分段了,那么数据丢失了只需要传输一个小段就可以了。这样看来最根本的原因是:可靠传输是在传输层进行控制的。
流量控制
流量控制本身是为了让发送方发送数据的速率不要太快,让接收方来得及处理,如果接收方的接收缓存已经写满了,发送方还在不断发送数据,那接收方就只能把这些处理不来的数据丢弃掉,大量丢包会造成网络资源的极大浪费。
流量控制的原理很简单:通过确认报文中窗口字段来控制发送方发送数据的速率,发送方的发送窗口大小不能超过接收方给出的接收窗口大小,当发送方收到接受窗口大小为 0 时,发送发会停止发送数据。
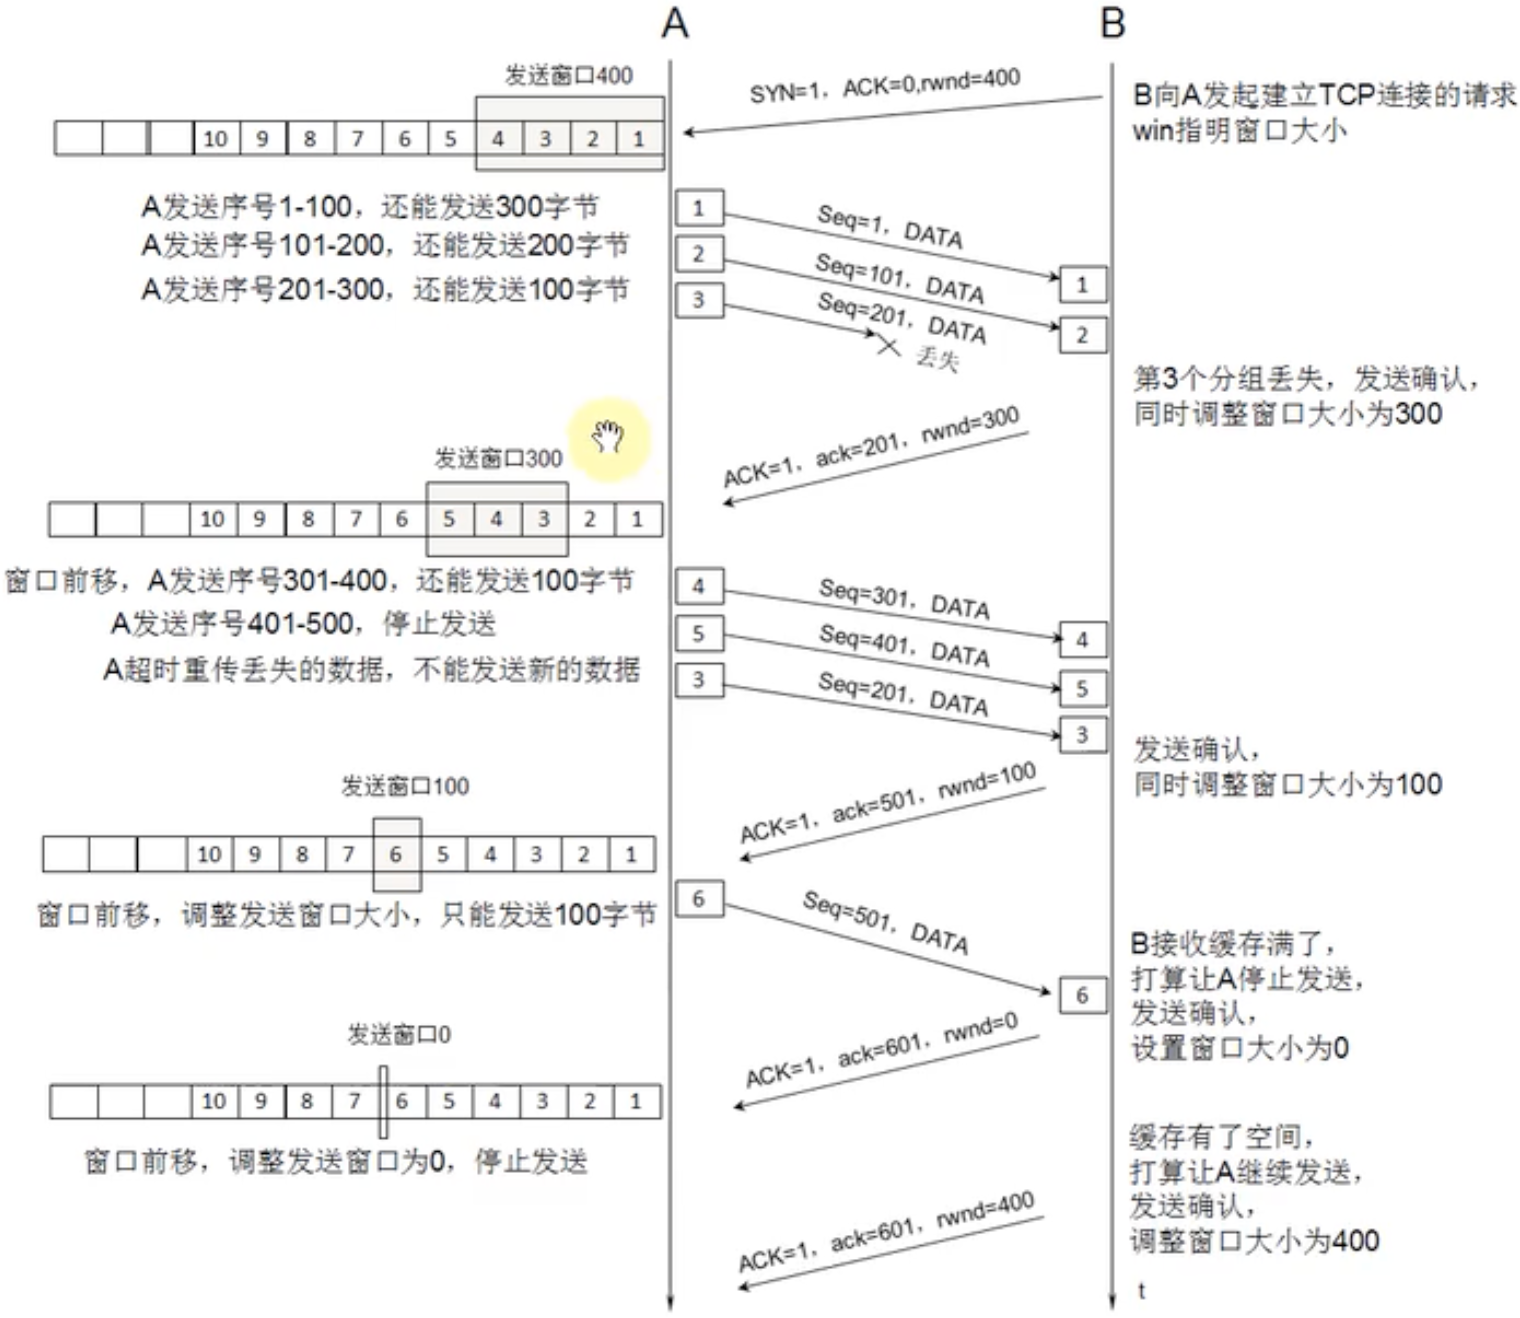
这里也有一个问题,如果接收方设置窗口大小为 0,此时发送方收到 0 窗口报文以后不再发送数据,如果后面接收方又有了缓存,可以接续接受数据了,但是这个非 0 窗口报文在发送过程中丢失了,这样的话,接收方和发送方就一直僵持着,发送方的发送窗口还是 0,不会发送数据。为了解决这个问题,发送方采用了这样的方案:当发送方收到 0 窗口通知以后,会停止发送数据,同时会开启一个定时器,每隔一段时间就发送一个测试报文给接收方,询问对方最新的窗口大小。如果接收到的接收到的窗口大小还是 0,依旧不发送数据同时刷新计时器。
拥塞控制
拥塞控制就是防止过多的数据注入到网络中,避免网络中的路由器或者链路过载,我们可以通过下面这个图大概了解到什么是拥塞,并且可以了解到理论和实际情况的差异:
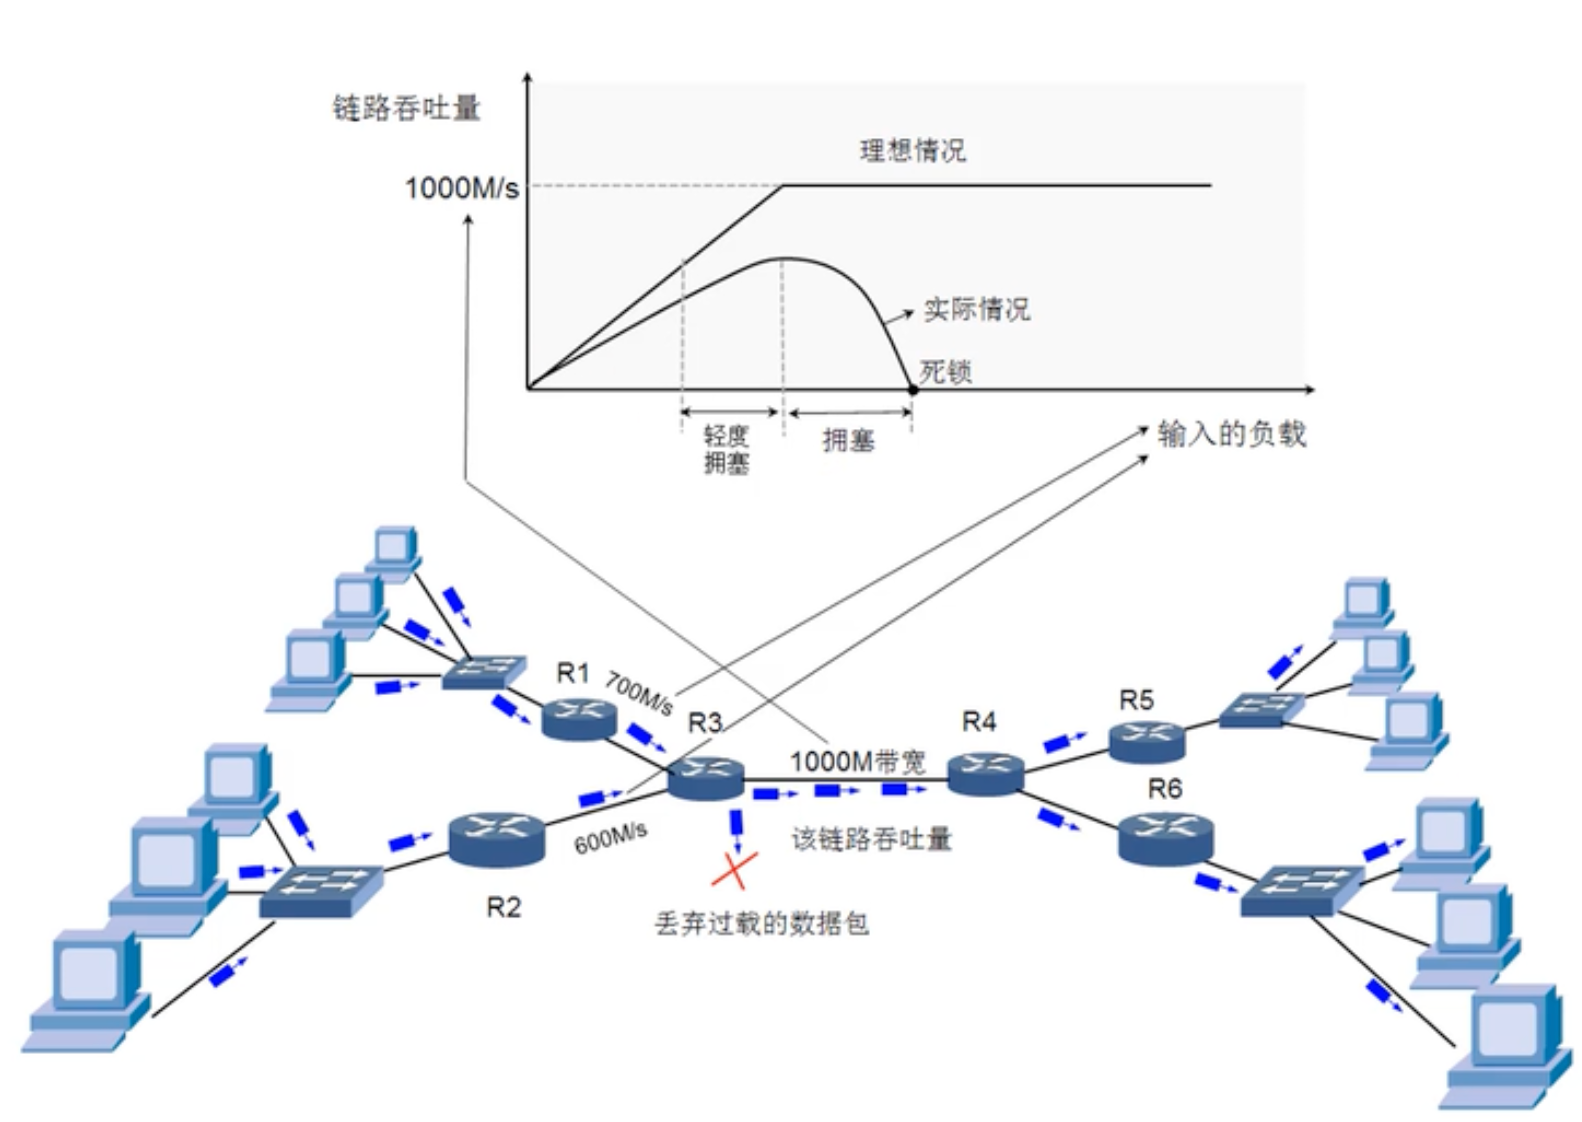
拥塞控制是一个全局性的过程,需要对比流量控制,流量控制是端对端点对点的过程,因为拥塞不是一两个机器的问题,它涉及到所有的主机和路由器,需要考虑所有的与降低网络传输性能有关的因素。
拥塞控制的原理
拥塞控制主要依赖一下几个机制:
- 慢开始(slow start)
- 拥塞避免(congestion avoidance)
- 快速重传(fast retransmit)
- 快速恢复(fast recovery)
在刚开始,建立连接的时候,TCP 的首部长度是 32 字节,此时用到了一些可选字段,这里面 MSS(Maximum segment size) 是我们常常分析的一个字段,代表每个段最大的数据部分的大小,发送方和接收方都有 MSS,我们一般最后的实际 MSS 是而这种最小的那个,从这里我们可以看出建立连接时有一个很重要的作用就是发送方和接收方进行协商。
此外接收方还有 rwnd(Receive window 接收窗口),发送方有一个 cwnd(congestion window 拥塞窗口,主要取决于网络是否拥挤),然后最后发送方的实际 swnd(sending window)是 rwnd 和 cwnd 中最小的那个(,当 时,说明接收方的接收能力限制了发送窗口的最大值,当 时说明网络的拥塞限制了发送窗口的最大值),虽然这也是在进行协商,但是它并不是在三次握手的时候一次性协商好的,而是接收方通过 TCP 请求响应中动态协商的,rwnd 会变,cwnd 也会变,所以每次都会进行协商,他们都是使用 TCP 首部中固定的窗口字段。
慢开始
发送方的 cwnd 是如何确定的呢?这里我们需要理解慢开始这个机制。
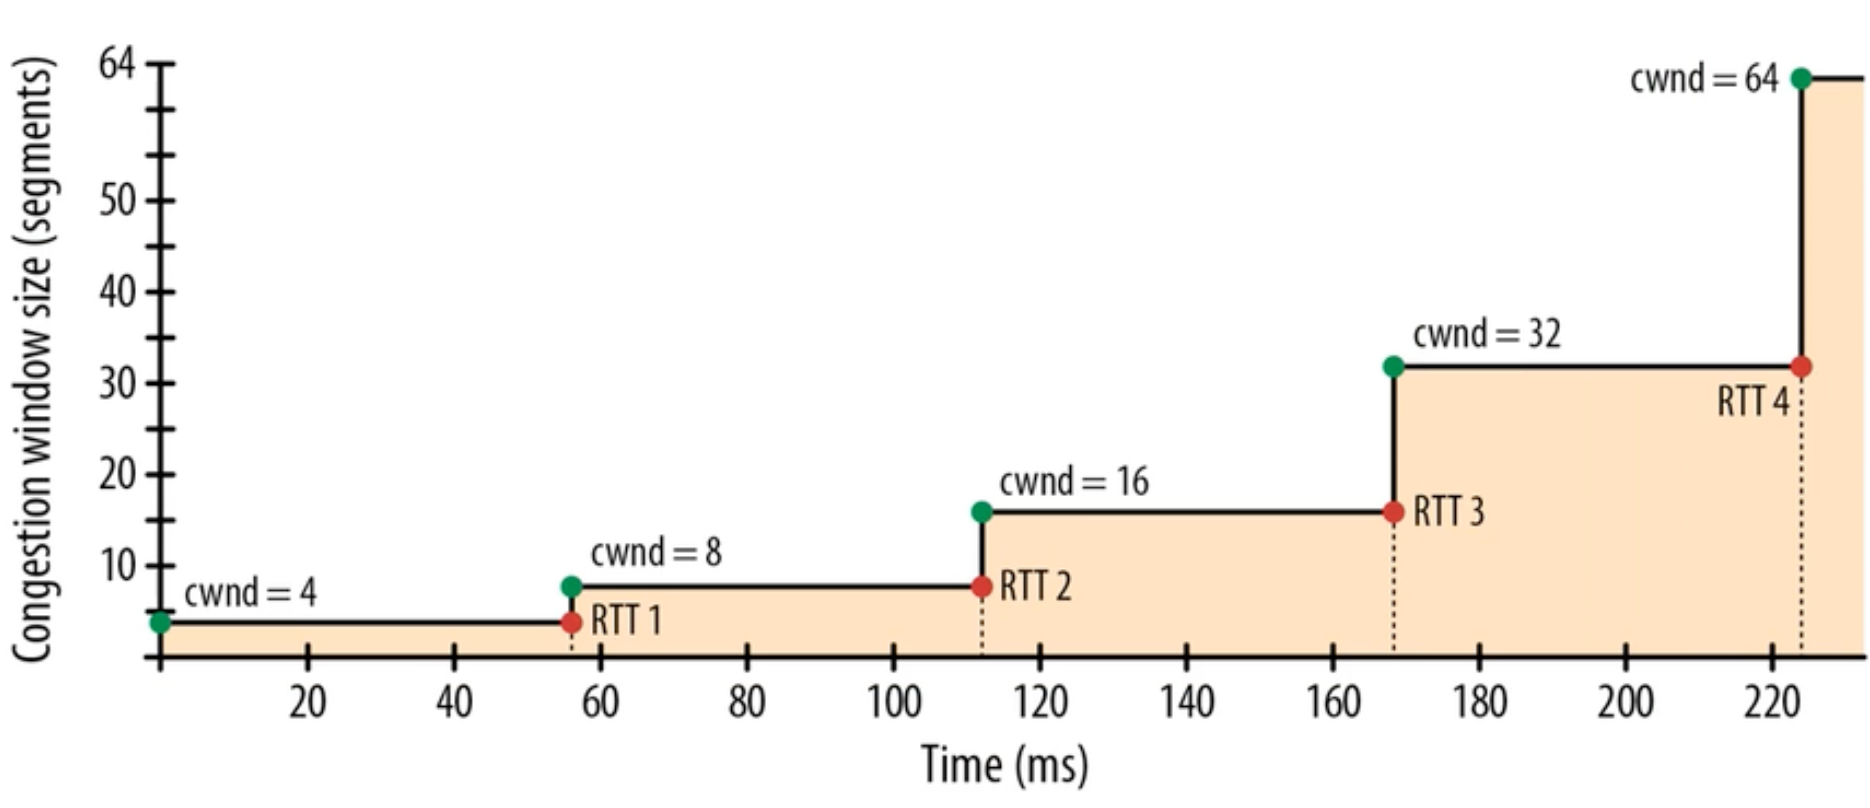
慢开始的核心理念就是试探,首先我们已经知道 rwnd 了,我们的 cwnd 就可以先从比较小增加到比较大来试探。
如图,我们可以先发 4 个 segment 试探一下,如果对方成功接收到,我就可以翻倍,第二次我就发 8 个 segment,如果对方还是都收到了,就发 16 个,对方又是都收到了说明网络状况还可以,继续翻倍,接下来就发 32 个,没问题就发 64 个,这样不断呈指数级增长。
拥塞避免
如果 cwnd 不断指数级增长,那很快就会出现拥塞,所以我们需要使用拥塞避免机制来避免拥塞。
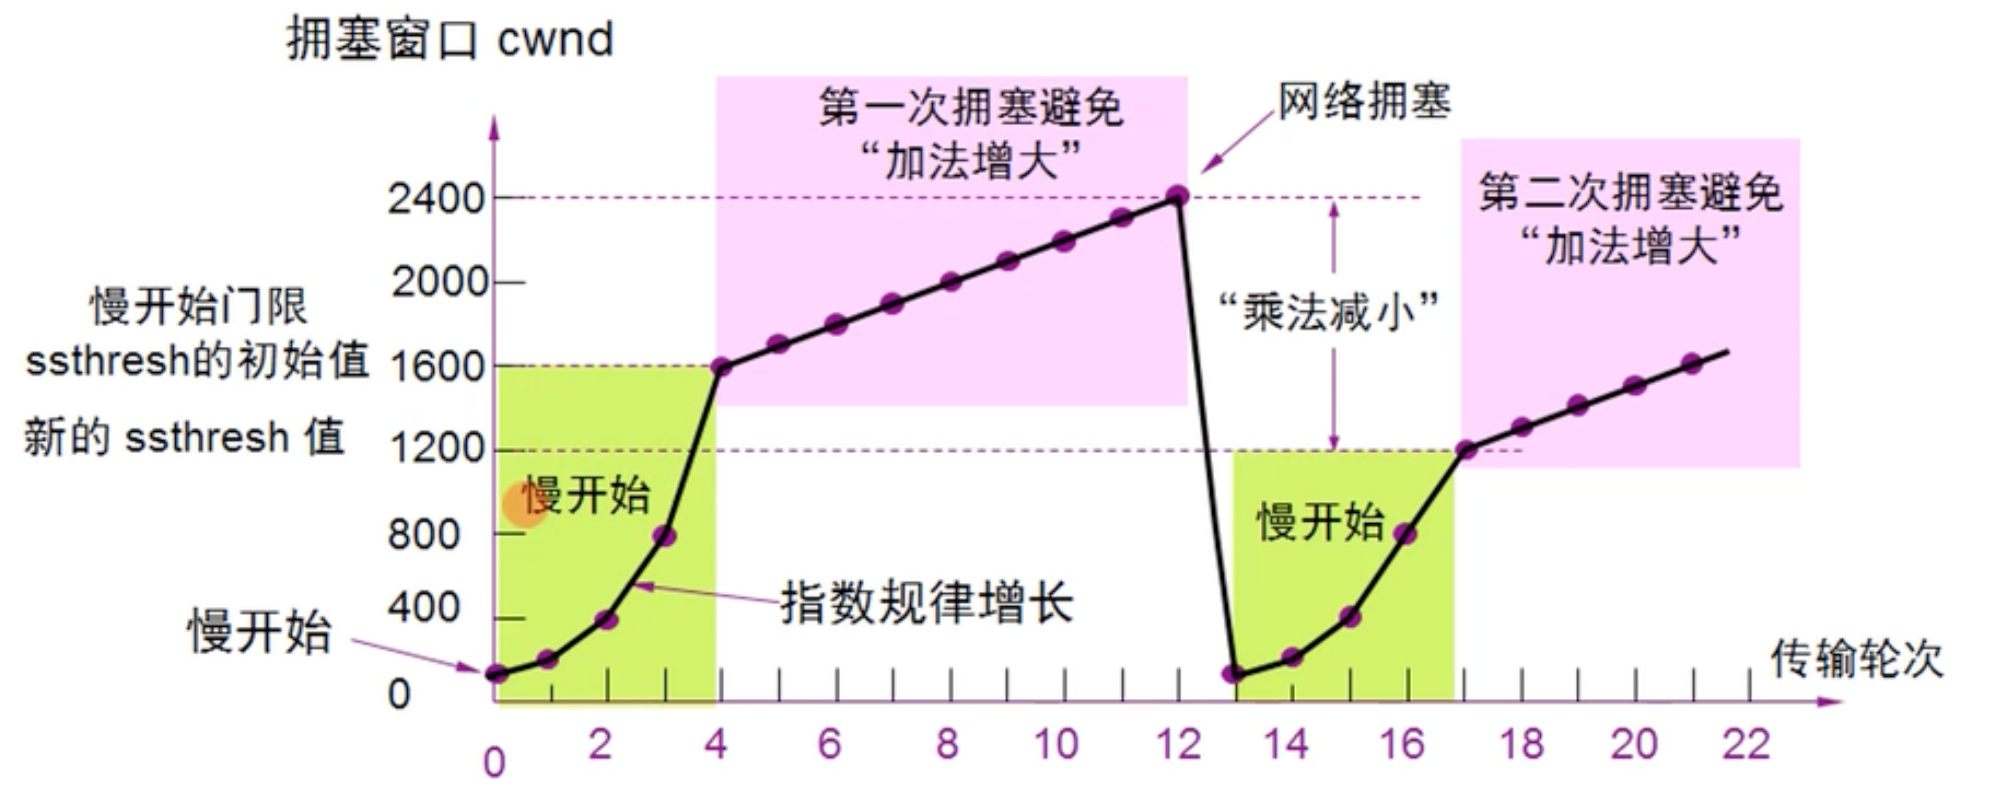
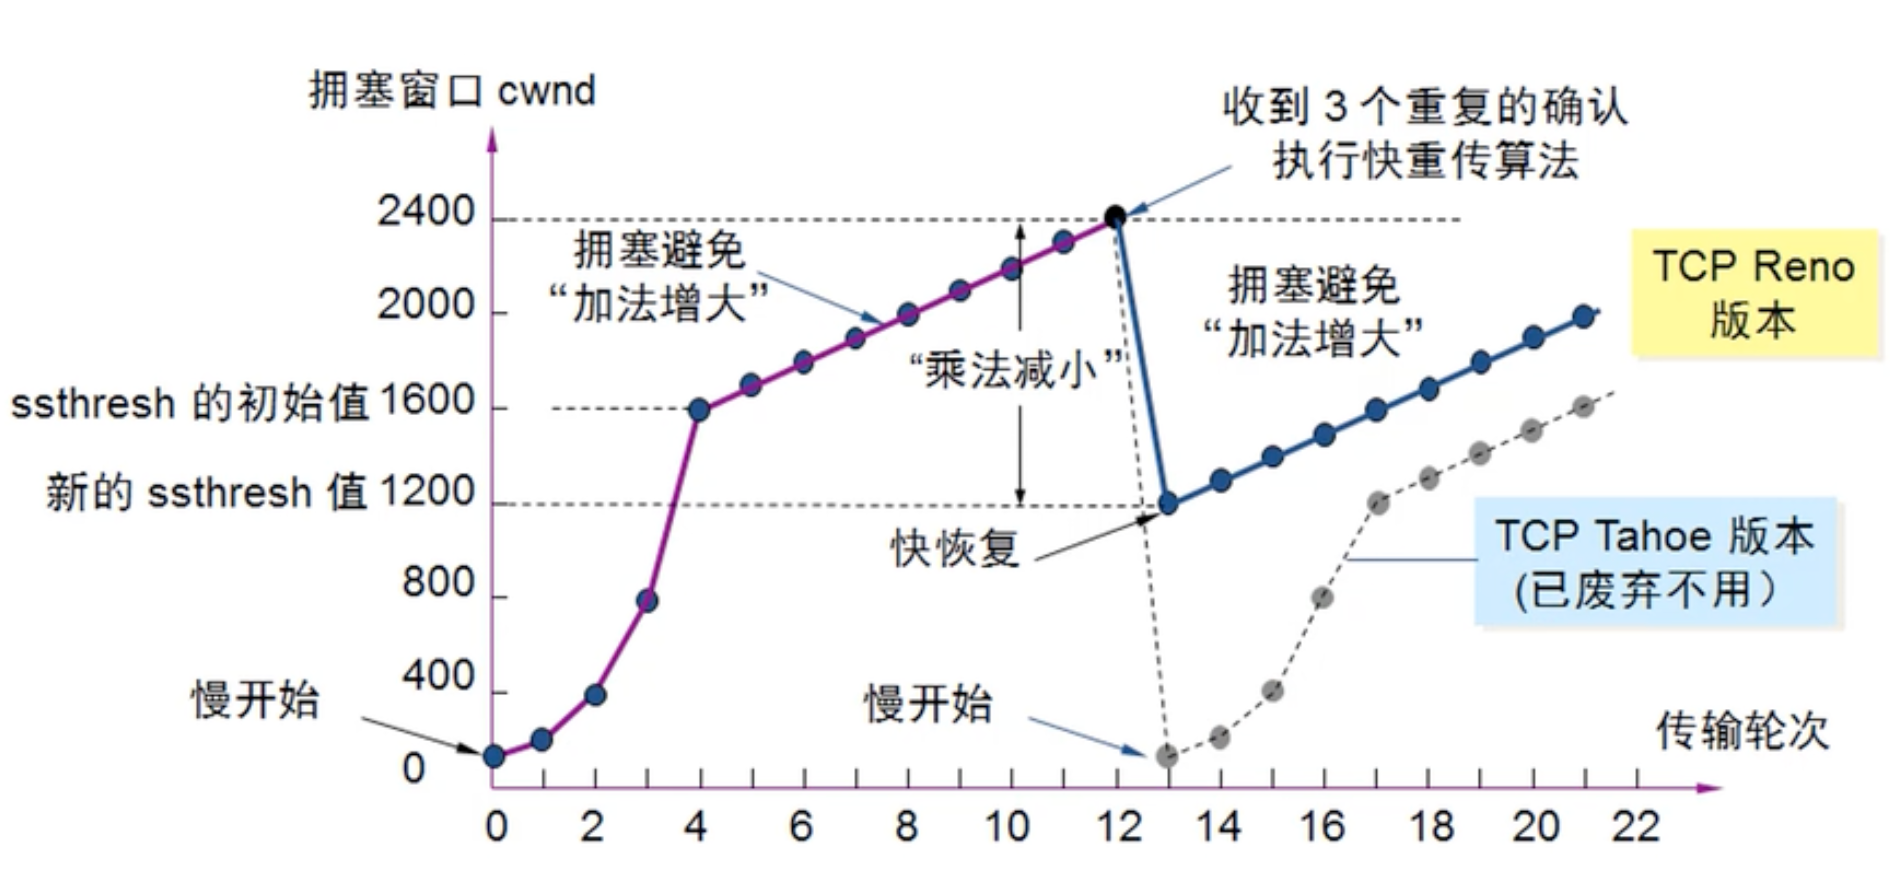
拥塞避免使用了一个 ssthresh(慢开始门限/阈值),当 cwnd 小于等于 ssthresh 的时候就是呈指数级增长,到达了 ssthresh 以后就呈现性增长(也就是加法增大,一次增长加一个固定的值),这样就可以防止网络过早出现拥塞(如果不这样做的话可能翻倍一下网络负载就变得很高了)。只要网络出现拥塞,我们就将 ssthresh 的值设置为当前 cwnd 的一半(也就是乘法减小),并且开始执行慢开始算法,当网络出现频繁拥塞的时候,ssthresh 就会下降得很快。
快速重传
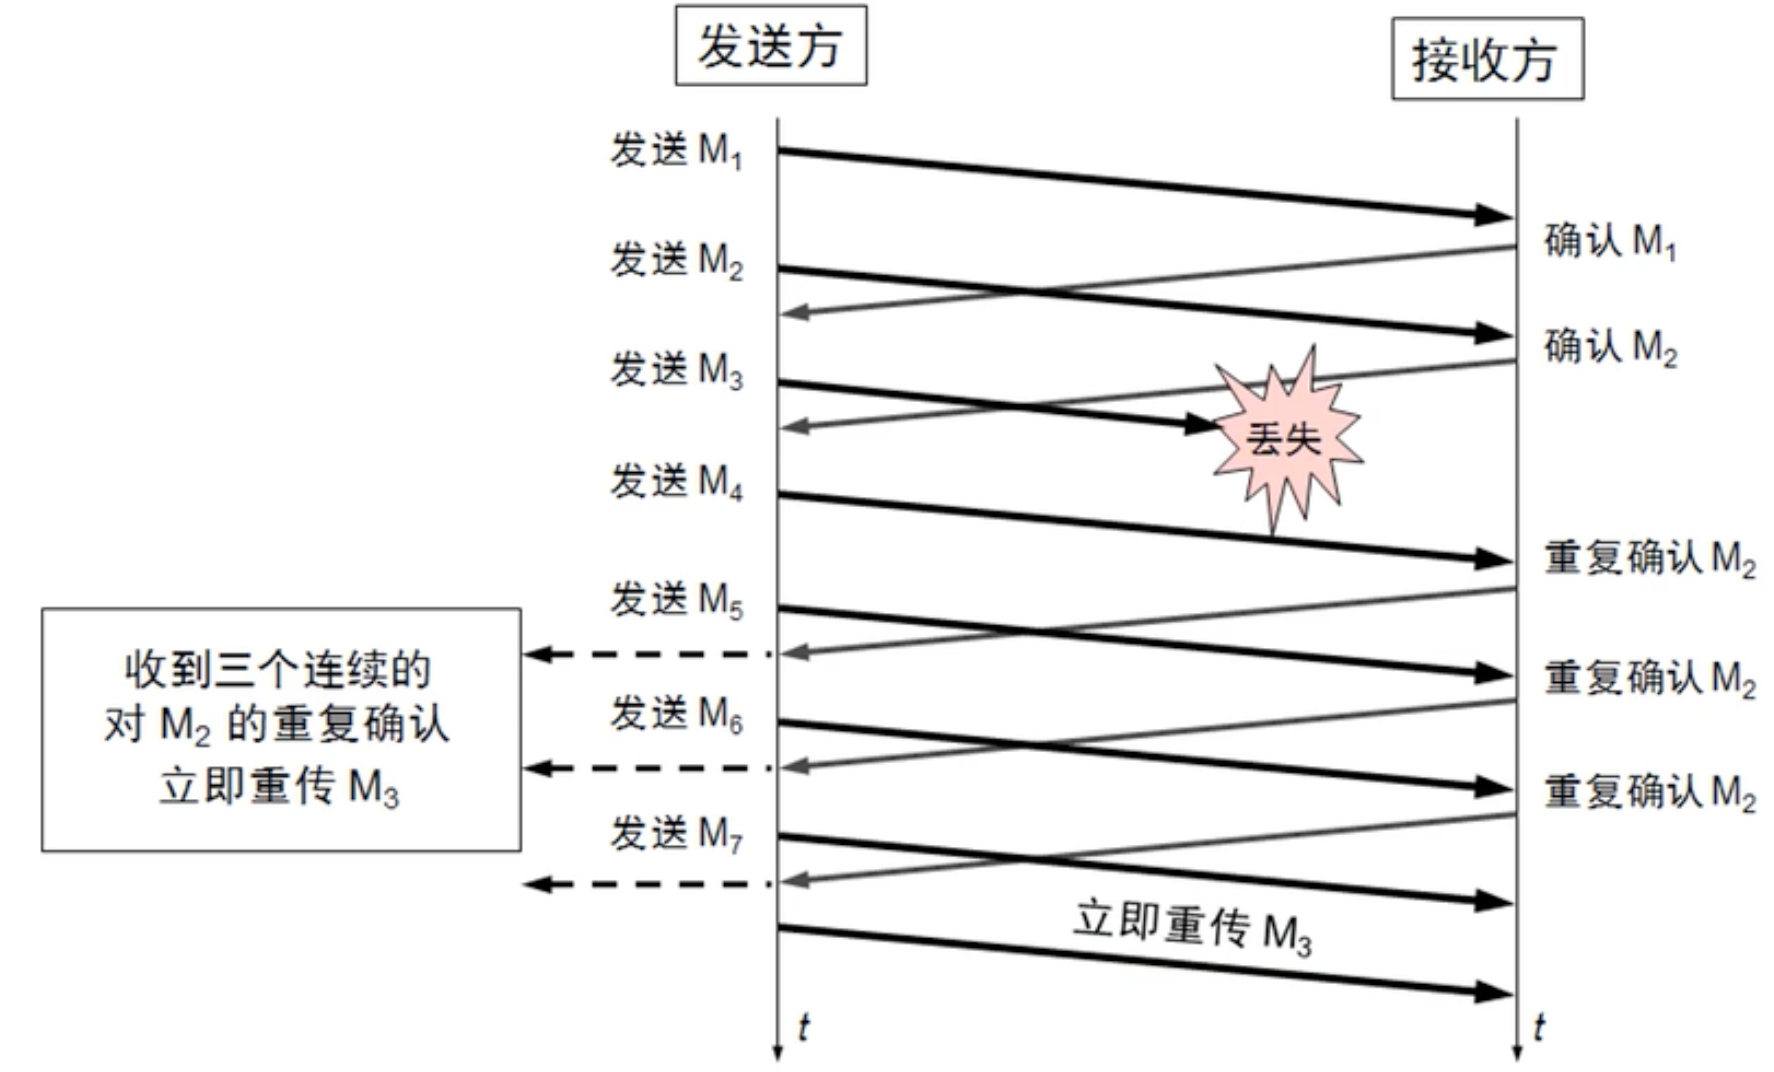
接收方每当收到一个失序的分组就立即发送重复确认,使发送方及时知道有分组没有到达,不需要等到自己发数据的时候才进行确认,只要发送方收到重复的三个 ACK 就可以及时重新发送,而不必等重传计时器到期以后再重传。
注意区别于超时重传,而且快速重传和超时重传并不矛盾:
-
正常情况下:TCP 发送数据,等待 ACK。
-
轻度丢包(收到 3 个重复 ACK):
- 触发快速重传,立即重传丢失的报文段。
- 同时进入快速恢复(Fast Recovery),
ssthresh减半,cwnd不会直接降到 1。 - 尽量保持较高的发送速率。
-
严重丢包或快速重传失败:
- 如果重传的报文段也丢了,或者 ACK 一直没回来。
- RTO 定时器到期,触发超时重传。
- 此时认为网络状况较差,
cwnd直接降到 1,ssthresh减半,重新慢启动。
快速恢复
因为之前拥塞避免是:只要网络出现拥塞,我们就将 ssthresh 的值设置为当前 cwnd 的一半,并且开始执行慢开始算法,但是这样其实有点慢了,这种方式在 TCP Tahoe 中被采用但是后面我们使用了快速恢复算法,现在大家普遍采用 TCP Reno,就是使用这种办法:当出现拥塞的时候(也就是收到三个重复的确认),ssthresh 更新,然后直接把 cwnd 设置为新的 ssthresh,并开始加法增大 cwnd。
连接管理
连接管理其实算是整个 TCP 里面最重要的一个部分,他的细节很多,而且过程比较复杂,面试爱问考试爱考,建立连接和释放连接还可以单独抽一部分考察,可以考察三次握手建立连接也可以考察三次挥手释放连接,所以需要好好理解和掌握。
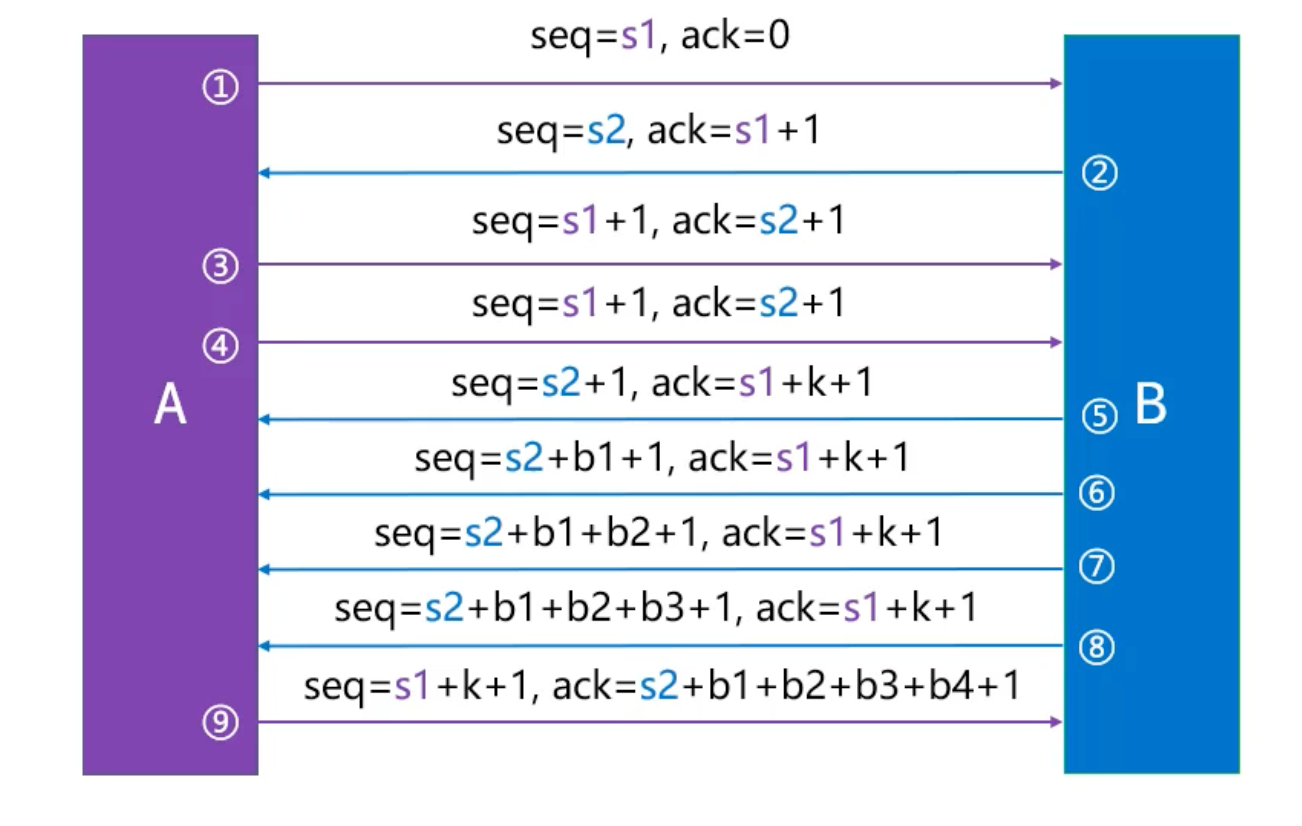
序号和确认号
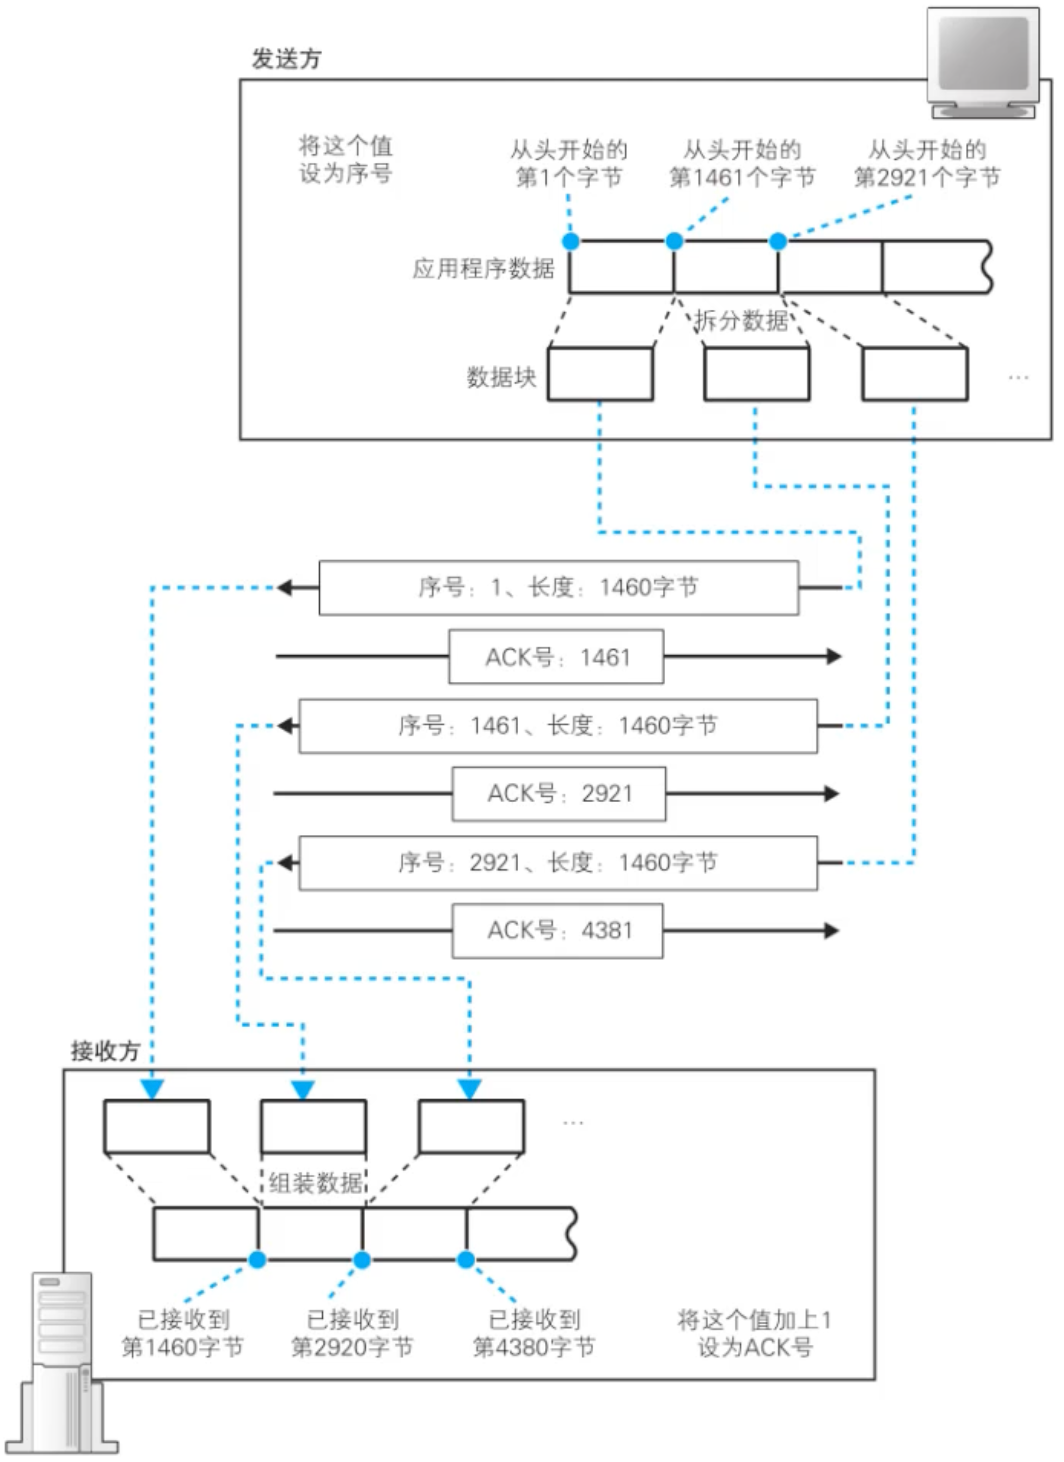
序号就是发的段的第一个字节的序号,我们加上长度就可以计算出我们现在数据发到哪个位置了,而确认号就是对方预期的下一个字节的序号,通过下面这个图,我们可以更好地理解这个过程以及序号、确认号的作用:
我们在 Wireshark 里面看到的序号值并不是真实的序号值,一般来说真实序号值是一个比较大的数,但是为了方便理解,Wireshark 会对序号取相对值来显示,比如第一个序号其实是 1122,但是为了方便显示,就会令他取 1,后面的序号值也是这样,依旧可以反应长度和先后关系,这个序号实际上是在建立连接的时候确定的。
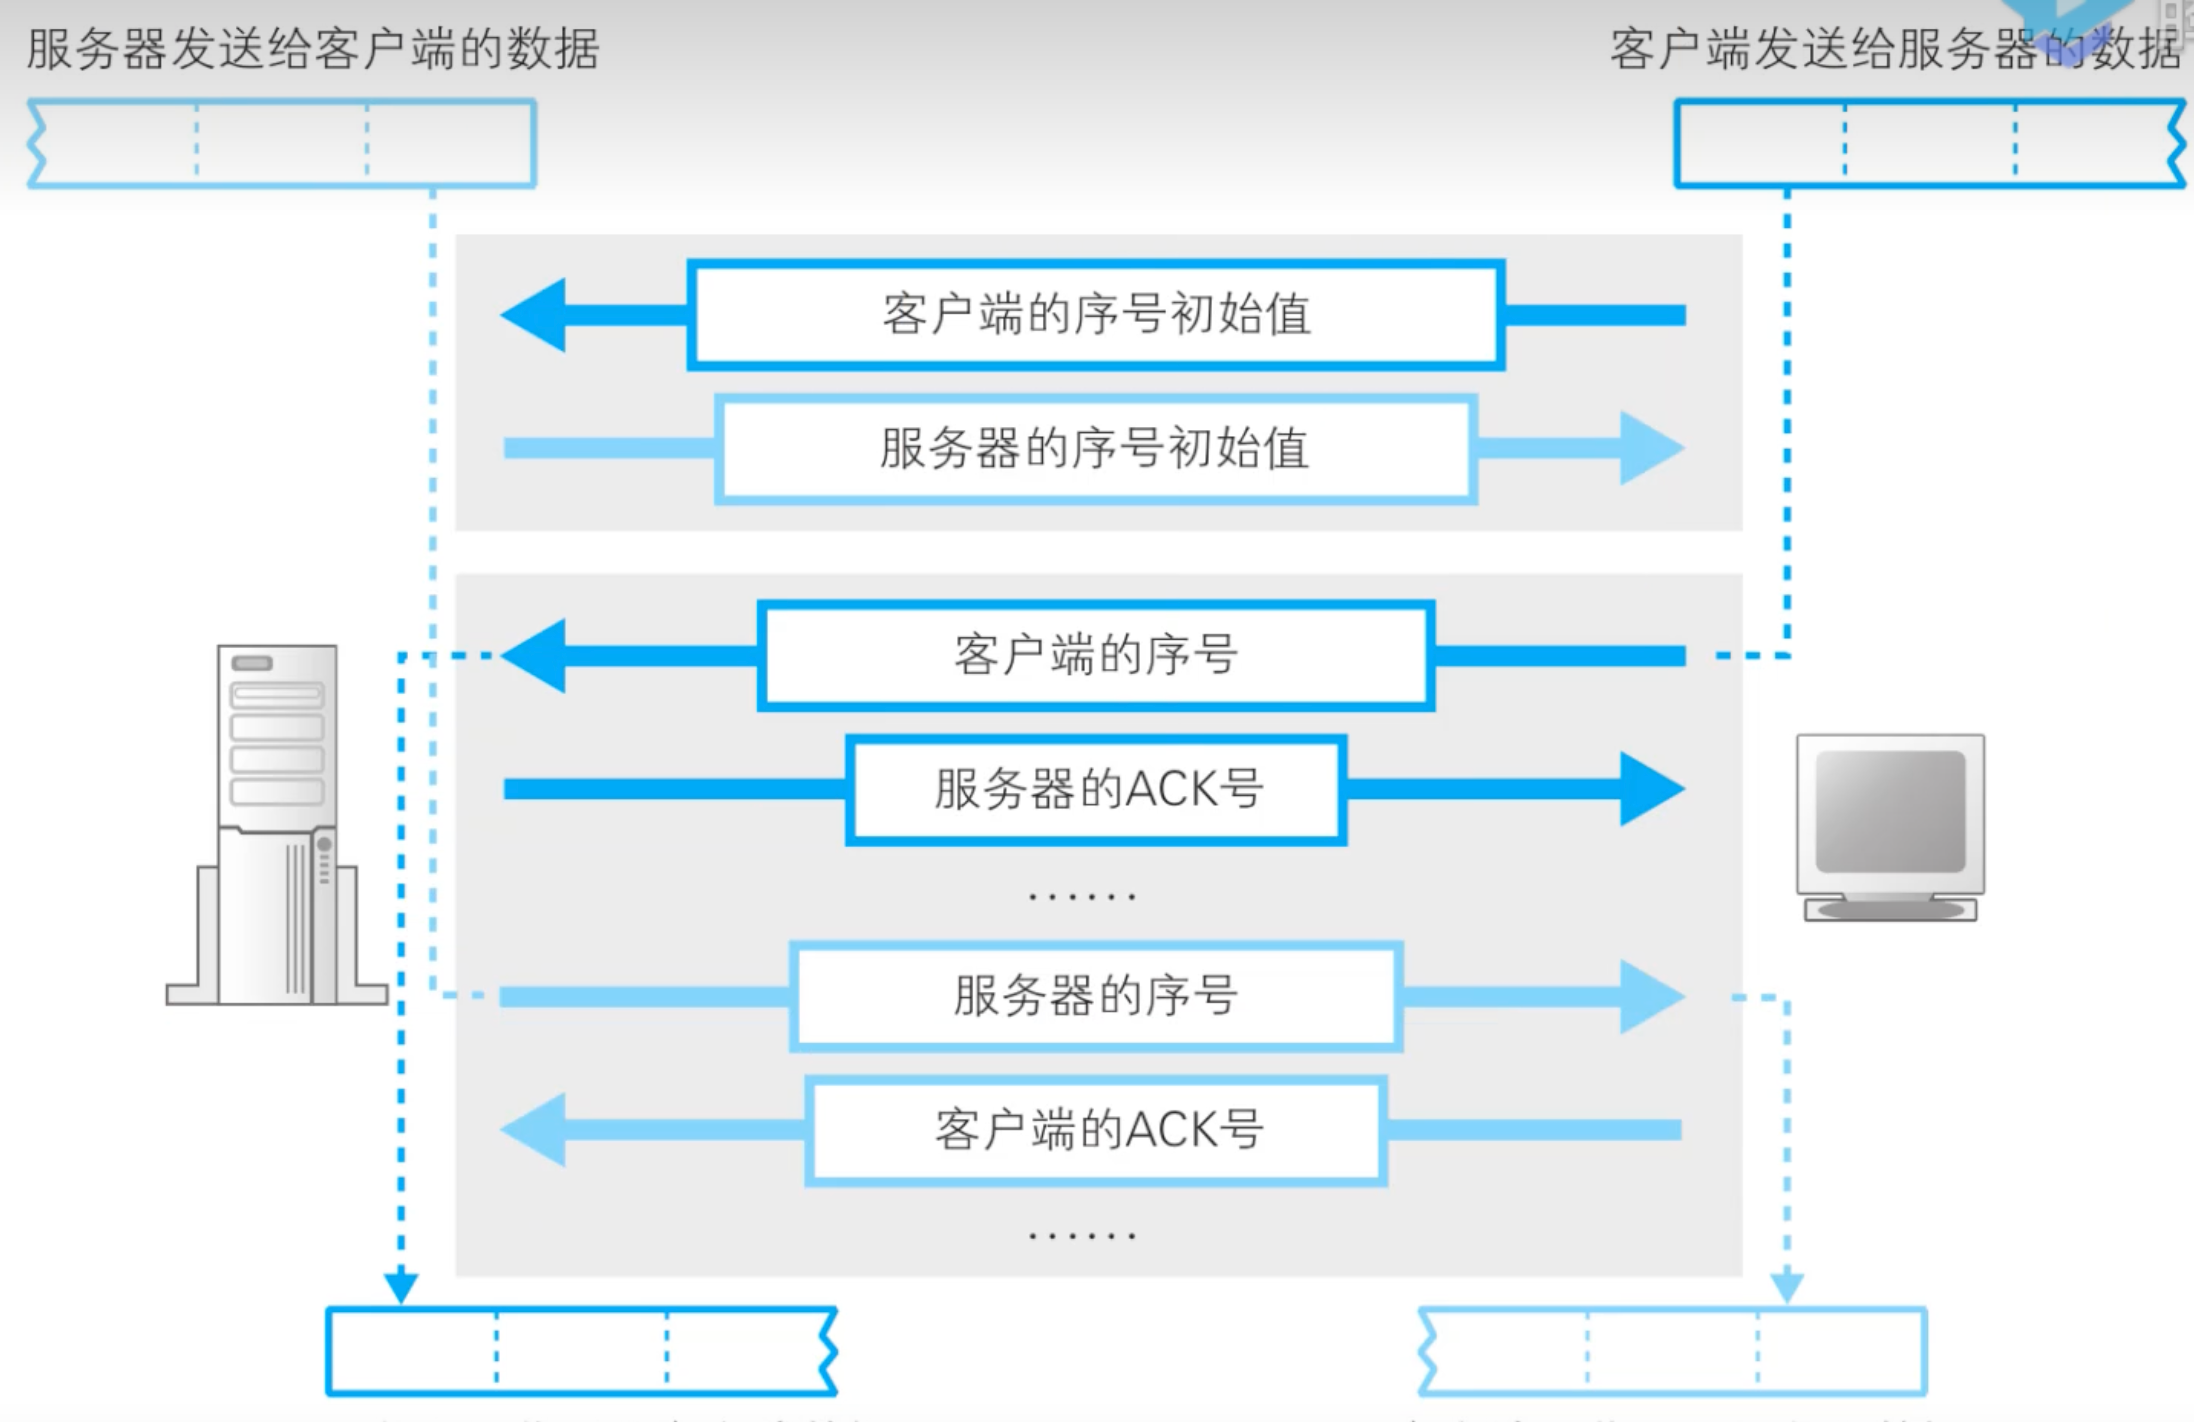
除了序号值是这样,ACK 也是这样的,我们看到的是一个相对值。
建立连接
建立连接的过程我们常说就是“三次握手”
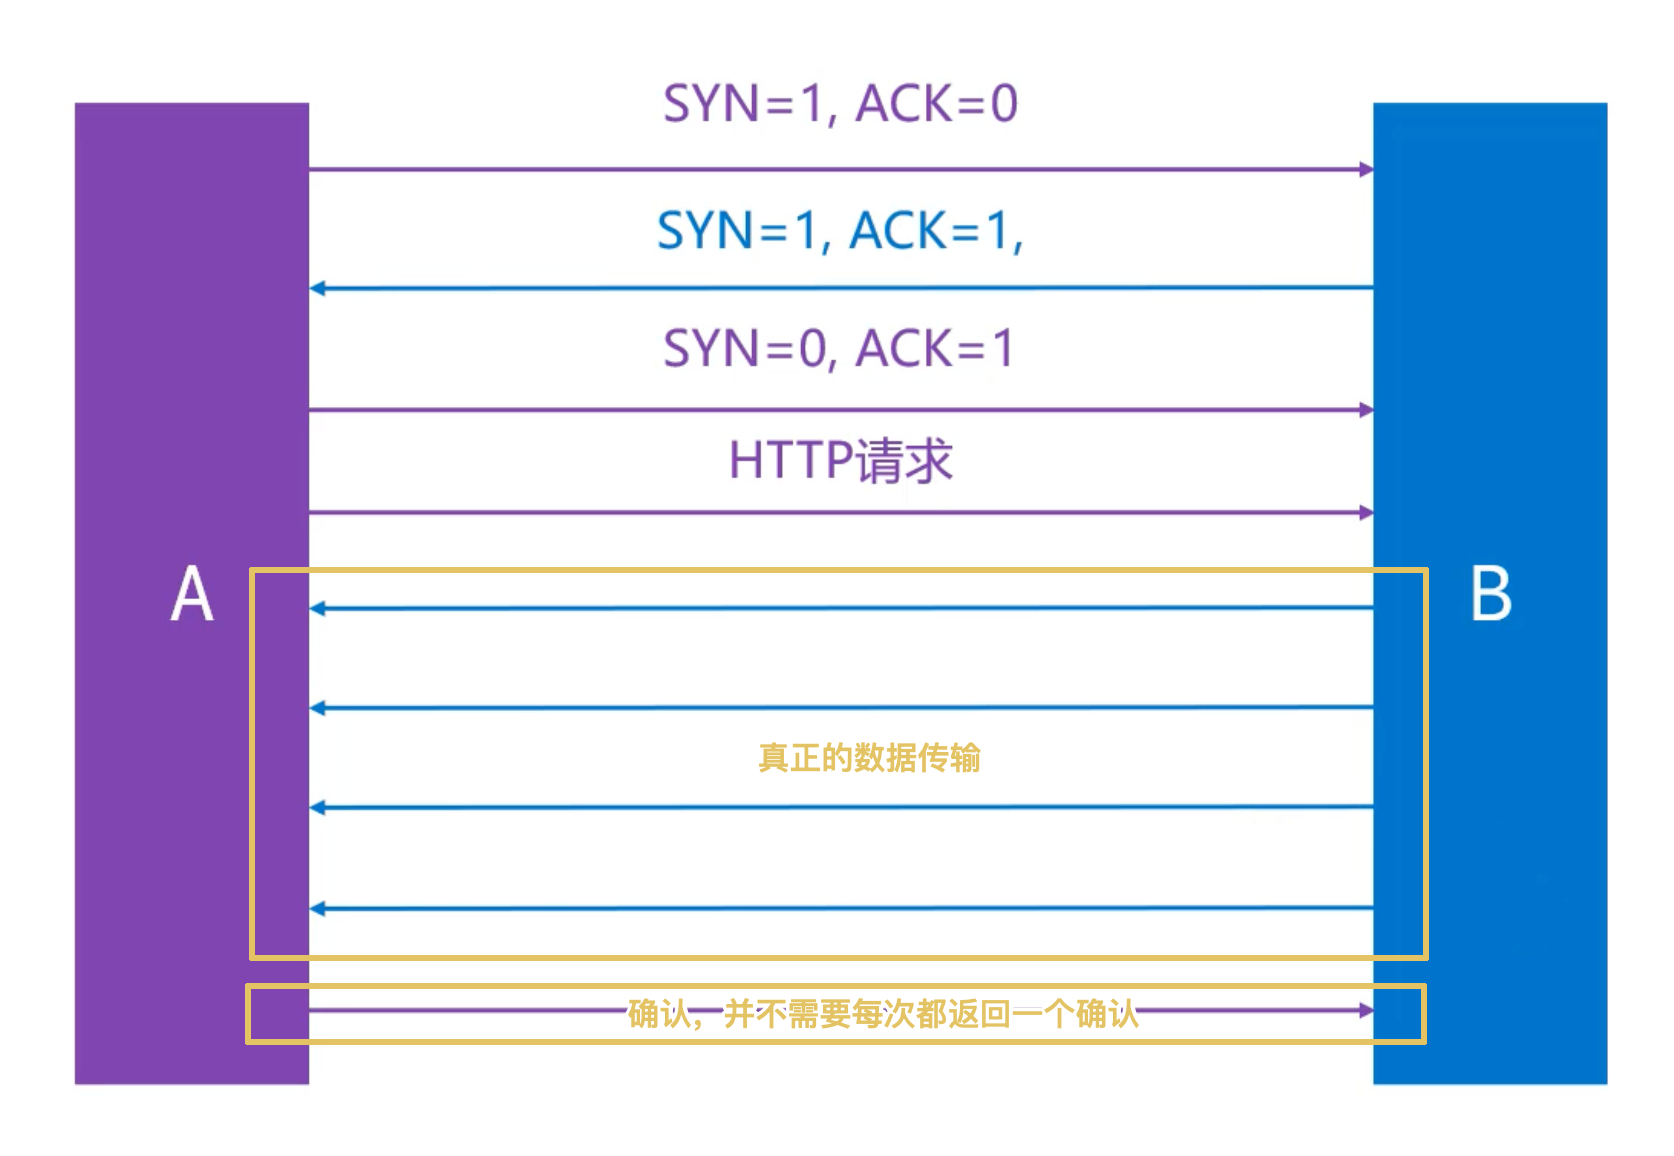
再更好地了解了序号和确认号以后,我们可以给出更加精细的过程描述: