梯度设置的过大或者梯度设置的过小对训练有什么影响
梯度设置过大会导致更新步幅过大,错过极小值点,导致导致损失函数最终震荡甚至发散,无法收敛到最优解。
梯度设置过小会导致更新步幅过小,损失函数更新非常慢,造成训练资源的浪费,甚至在资源限制的场景下无法得到收敛结果。
激活函数有哪些,作用是什么?
常见的激活函数有:sigmoid、tanh、ReLU
- sigmoid:
- tanh:
- ReLU:
激活函数将输入转换成输出的可微运算,赋予模型非线性拟合的能力。
什么是过拟合,给出两种缓解过拟合的方法以及这些方法的工作原理
过拟合是指,模型在学习过程中学习到了过多非主要特征(噪声),导致模型在训练数据上表现很好但是在未见过的测试数据上表现下降一现象。缓解过拟合的方法有:权重衰退和dropout(权重抛弃)
权重衰退(L2正则化)是通过引入一个惩罚项,来限制L2范数大小来限制模型的参数大小。
dropout(权重抛弃)是根据抛弃概率将某一些神经元的输出置为0,来提高训练过程中的随机性以此来提高模型的健壮性。
什么是欠拟合,给出缓解欠拟合的方法
欠拟合是指,模型还没能较好地学习训练样本的特征,因此在未见过的数据上表现也是不好的这一现象。通常我们会选择设计学习效率更强的模型,或者加深模型的深度,或者让模型训练更长时间。
请对梯度爆炸和梯度消失问题进行简要的说明
梯度爆炸是指,由于连乘和方向传播,模型在靠近输入层的那几层梯度计算中得到的梯度非常大,导致最后几层训练困难,频繁震荡难以收敛。
梯度消失是指,由于连乘和方向传播,模型的最开始几层计算得到的梯度非常小,导致几乎调不动参数,最后训练非常缓慢,浪费资源,难以收敛。
在图像处理领域,卷积层相较于原来的全连接层有哪两个显著的优势,请分别解释这些优势来源于卷积计算的哪两个特质
卷积层相比全连接层的两个显著优势是:
- 通过权值共享显著减少参数数量,提高训练效率;(权值共享,同一个卷积核在整个输入上滑动计算)
- 通过局部感受野有效利用输入的空间结构特征。(局部性,每个输出只依赖输入的一个局部邻域也就是“局部感受野”。)
请简述池化层在卷积神经网络中的作用,并列举一下常见池化层的类型
池化层的作用包括:压缩输入数据的大小(规模或者空间尺寸),提高模型的泛化能力,对于平均池化还能使得特征更加光滑,从而抑制噪声,对于最大池化可以使特征更加突出,强调显著特征。最大池化和平均池化是我们最常见的两种池化。
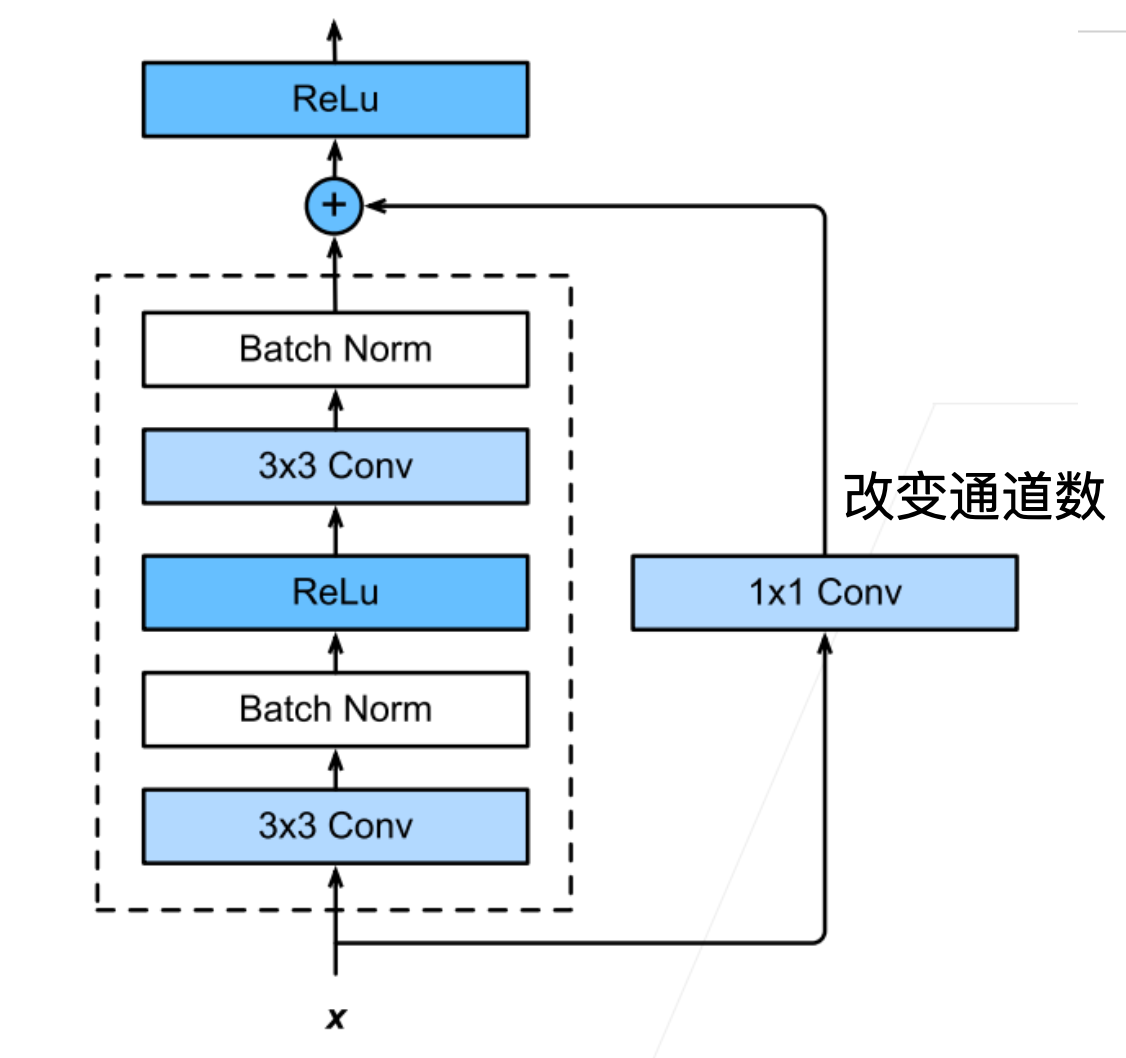
残差网络的提出是为了解决什么问题,并且画出一个残差块
是为了解决深层网络退化问题,当模型深度增加,训练误差反而更大了(不是过拟合),具体来说体现为:
- 梯度在多层中衰减
- 信息难以从前层传到后层
- 训练变得极不稳定
- 身份映射(Identity Mapping)都学不会
- 梯度爆炸/消失
seq2seq的两个核心模块是什么,列举出seq2seq的应用
核心模块是Encoder和Decoder,早期它们都是一个RNN,现在更多的是引入注意力机制,分别用于学习和处理输入序列和输出序列,最终实现需列转序列,具体用在文本翻译,语音识别等领域。
请简要概括注意力机制的核心思想
注意力机制的核心思想是:在处理序列数据时,模型不应平等地对待所有输入信息,而应根据当前任务的需要,动态地为不同部分的输入分配不同的权重(即“注意力”),从而聚焦于最相关的信息。这使得模型能够更好地捕捉长距离依赖关系,提升对关键内容的感知能力,并增强解释性。