一、时间复杂度与空间复杂度
时间复杂度的计算
时间复杂度的计算,很大程度上就是计算循环或者计算递归调用次数。
时间复杂度比较的时候按照如下规则排序:
循环
循环主要就是两种:
- 一种是循环累加,一次加一个常数,时间复杂度是 ,例如:
for (int i = 0; i < n; i ++) {
	...
}- 一种是循环累乘,一次乘以一个常数,时间复杂度是 ,m 是累乘的常数,例如:
for (int i = 1; i < n; i * 2) {
	...
}
最后还要考虑多层循环的嵌套,可能容易也可能很难,容易的是外层直接乘以内层,但是复杂的可能要使用一些等差数列或者等比数列求和的数学方法,一些常见的公式:
注意 公式 5 是调和级数,渐进复杂度就是 O(logn) ,考的还比较多,例如:
for (i = 1; i <= n; i++) {
	for (j = 1; j <= n; j += i) {
		... // 内层执行约 n/i 次 → 总次数 ≈ n·Hₙ ...
	}
}
递归(主定理)
非递归算法通常通过数循环次数即可估算时间复杂度,但递归是自我调用的结构,其执行过程形成一棵“调用树”,总操作次数等于所有递归层的操作之和。
建立递推关系是最基础的方法:设 表示规模为 的问题所需时间。
步骤:
- 写出递推式
- 求解该式(可通过展开、主定理、递归树等)
之后可以使用主定理,主定理适用于形如 的递归式,主定理主要处理分治类递归,其中:
- :子问题个数
- :每个子问题规模缩小为
- :分解与合并的代价
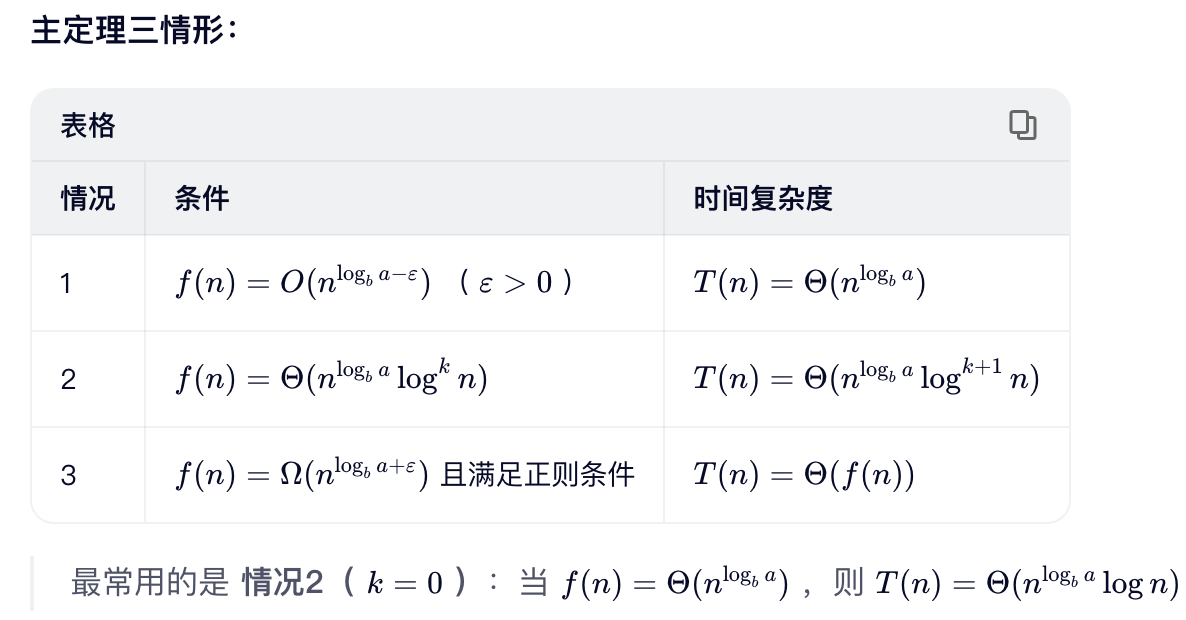
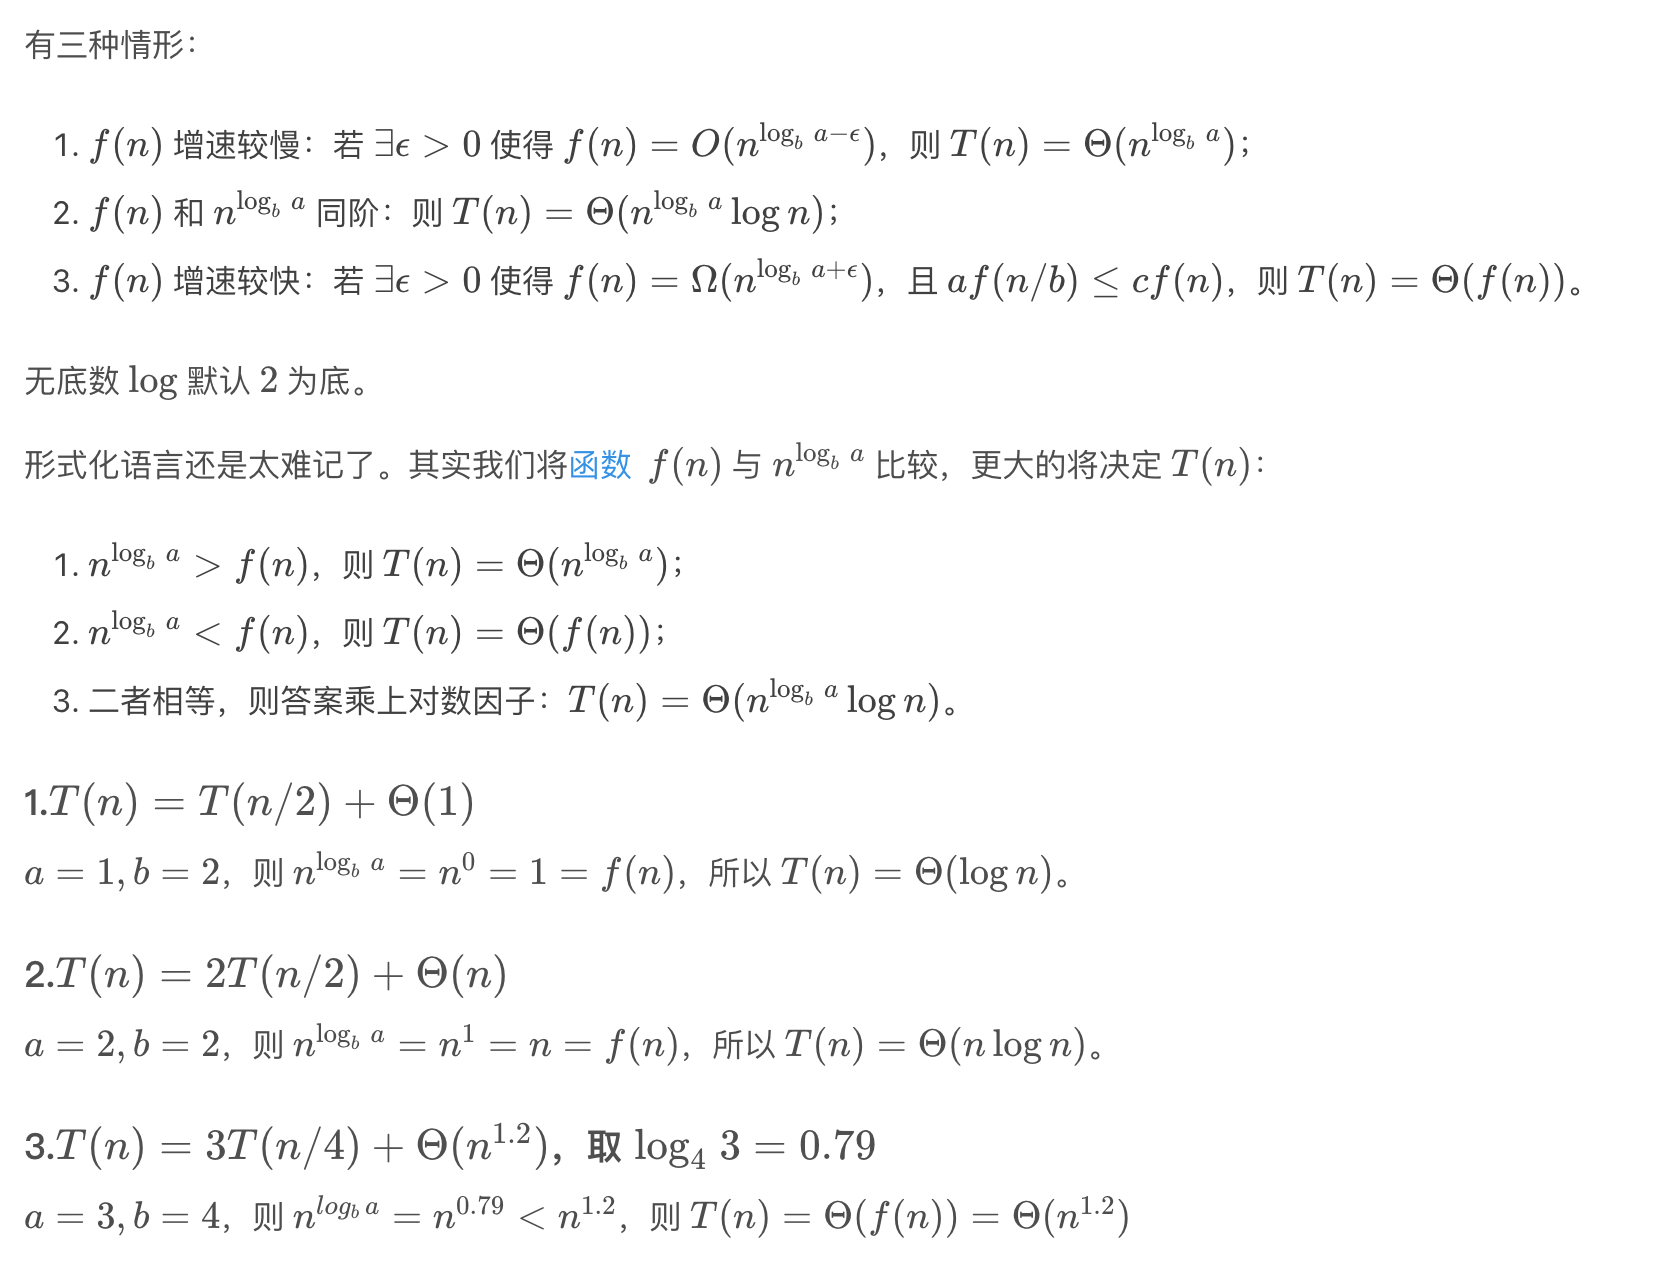
这样我们可以轻易求解一些递归算法的时间复杂度:
- 归并排序: →
- 快速排序(平均):同上 →
- 二分查找: →
⚠️ 注意:主定理不适用于所有递归(如 需展开:)。
考试的时候还可以使用 递归树(Recursion Tree),将递归调用画成树,每层代表一次递归,节点值为该层的操作代价,总代价 = 所有层代价之和。
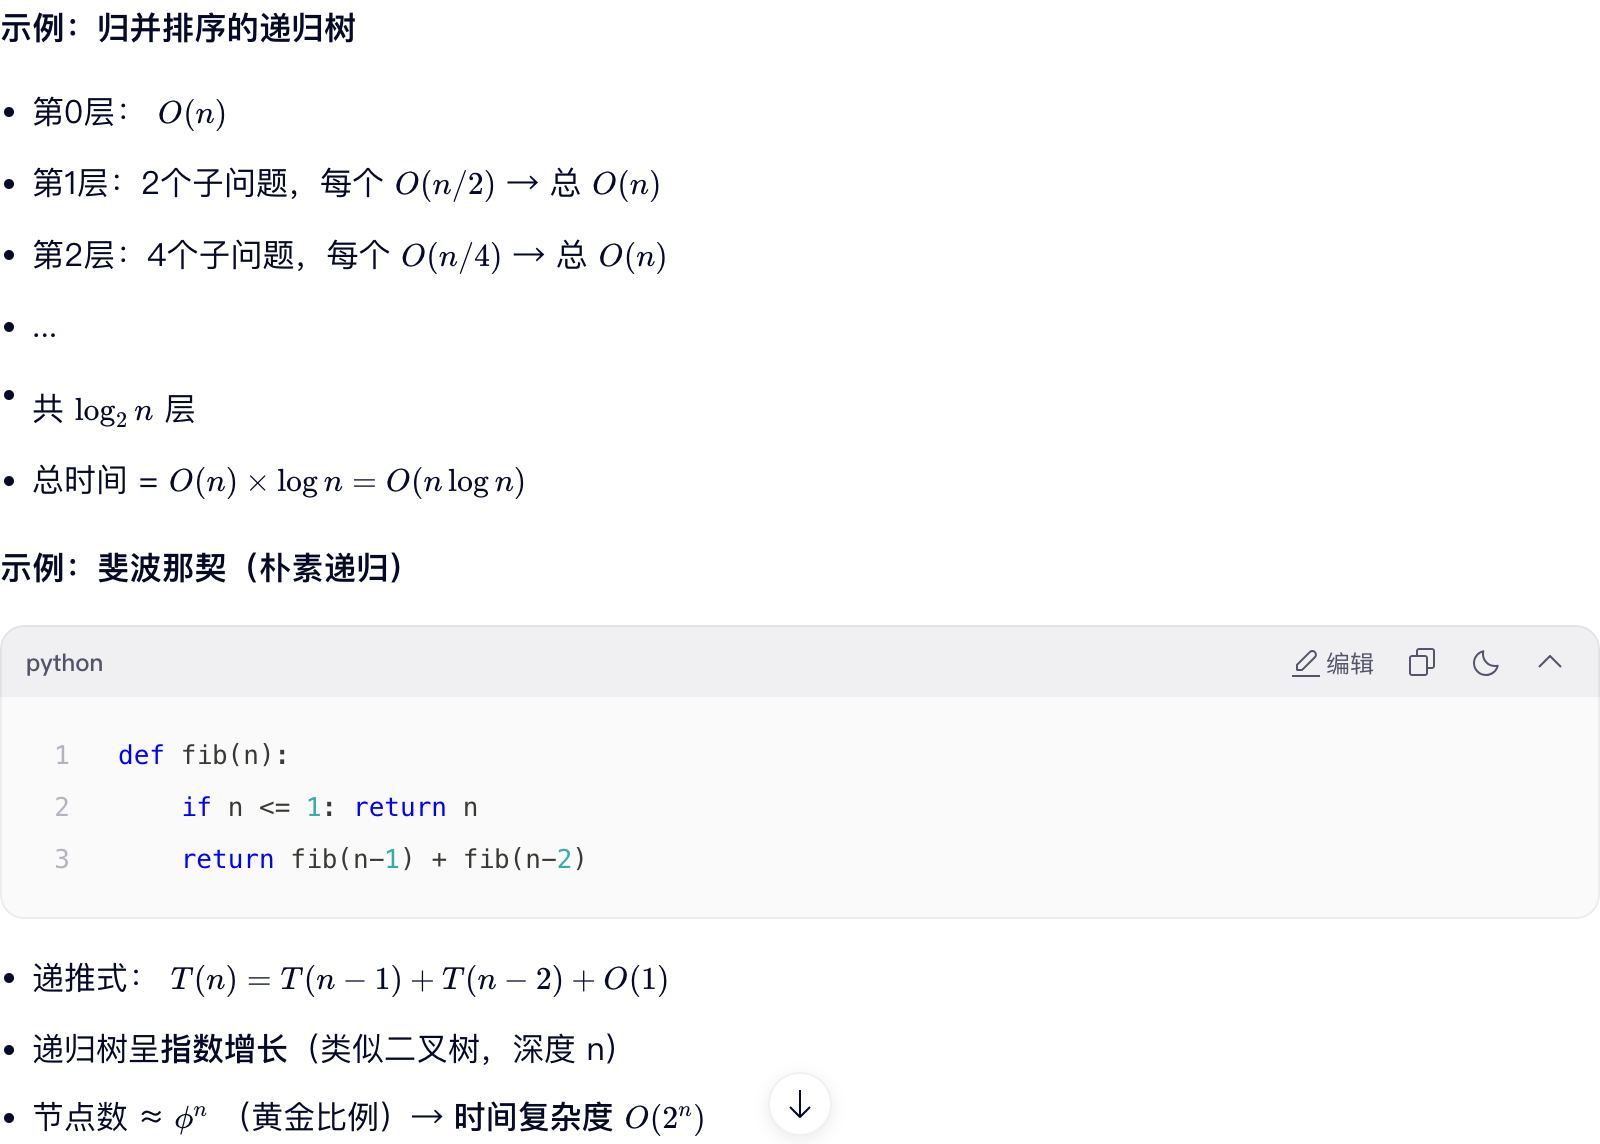
💡 递归树特别适合分析不规则递归或主定理不适用的情况。
线性表
线性表是一种逻辑结构,实现线性表可以使用两种不同的顺序结构:顺序存储、链式存储。
这样产生的两种不同实现的线性表分别叫做:顺序表 和 链表。
顺序表
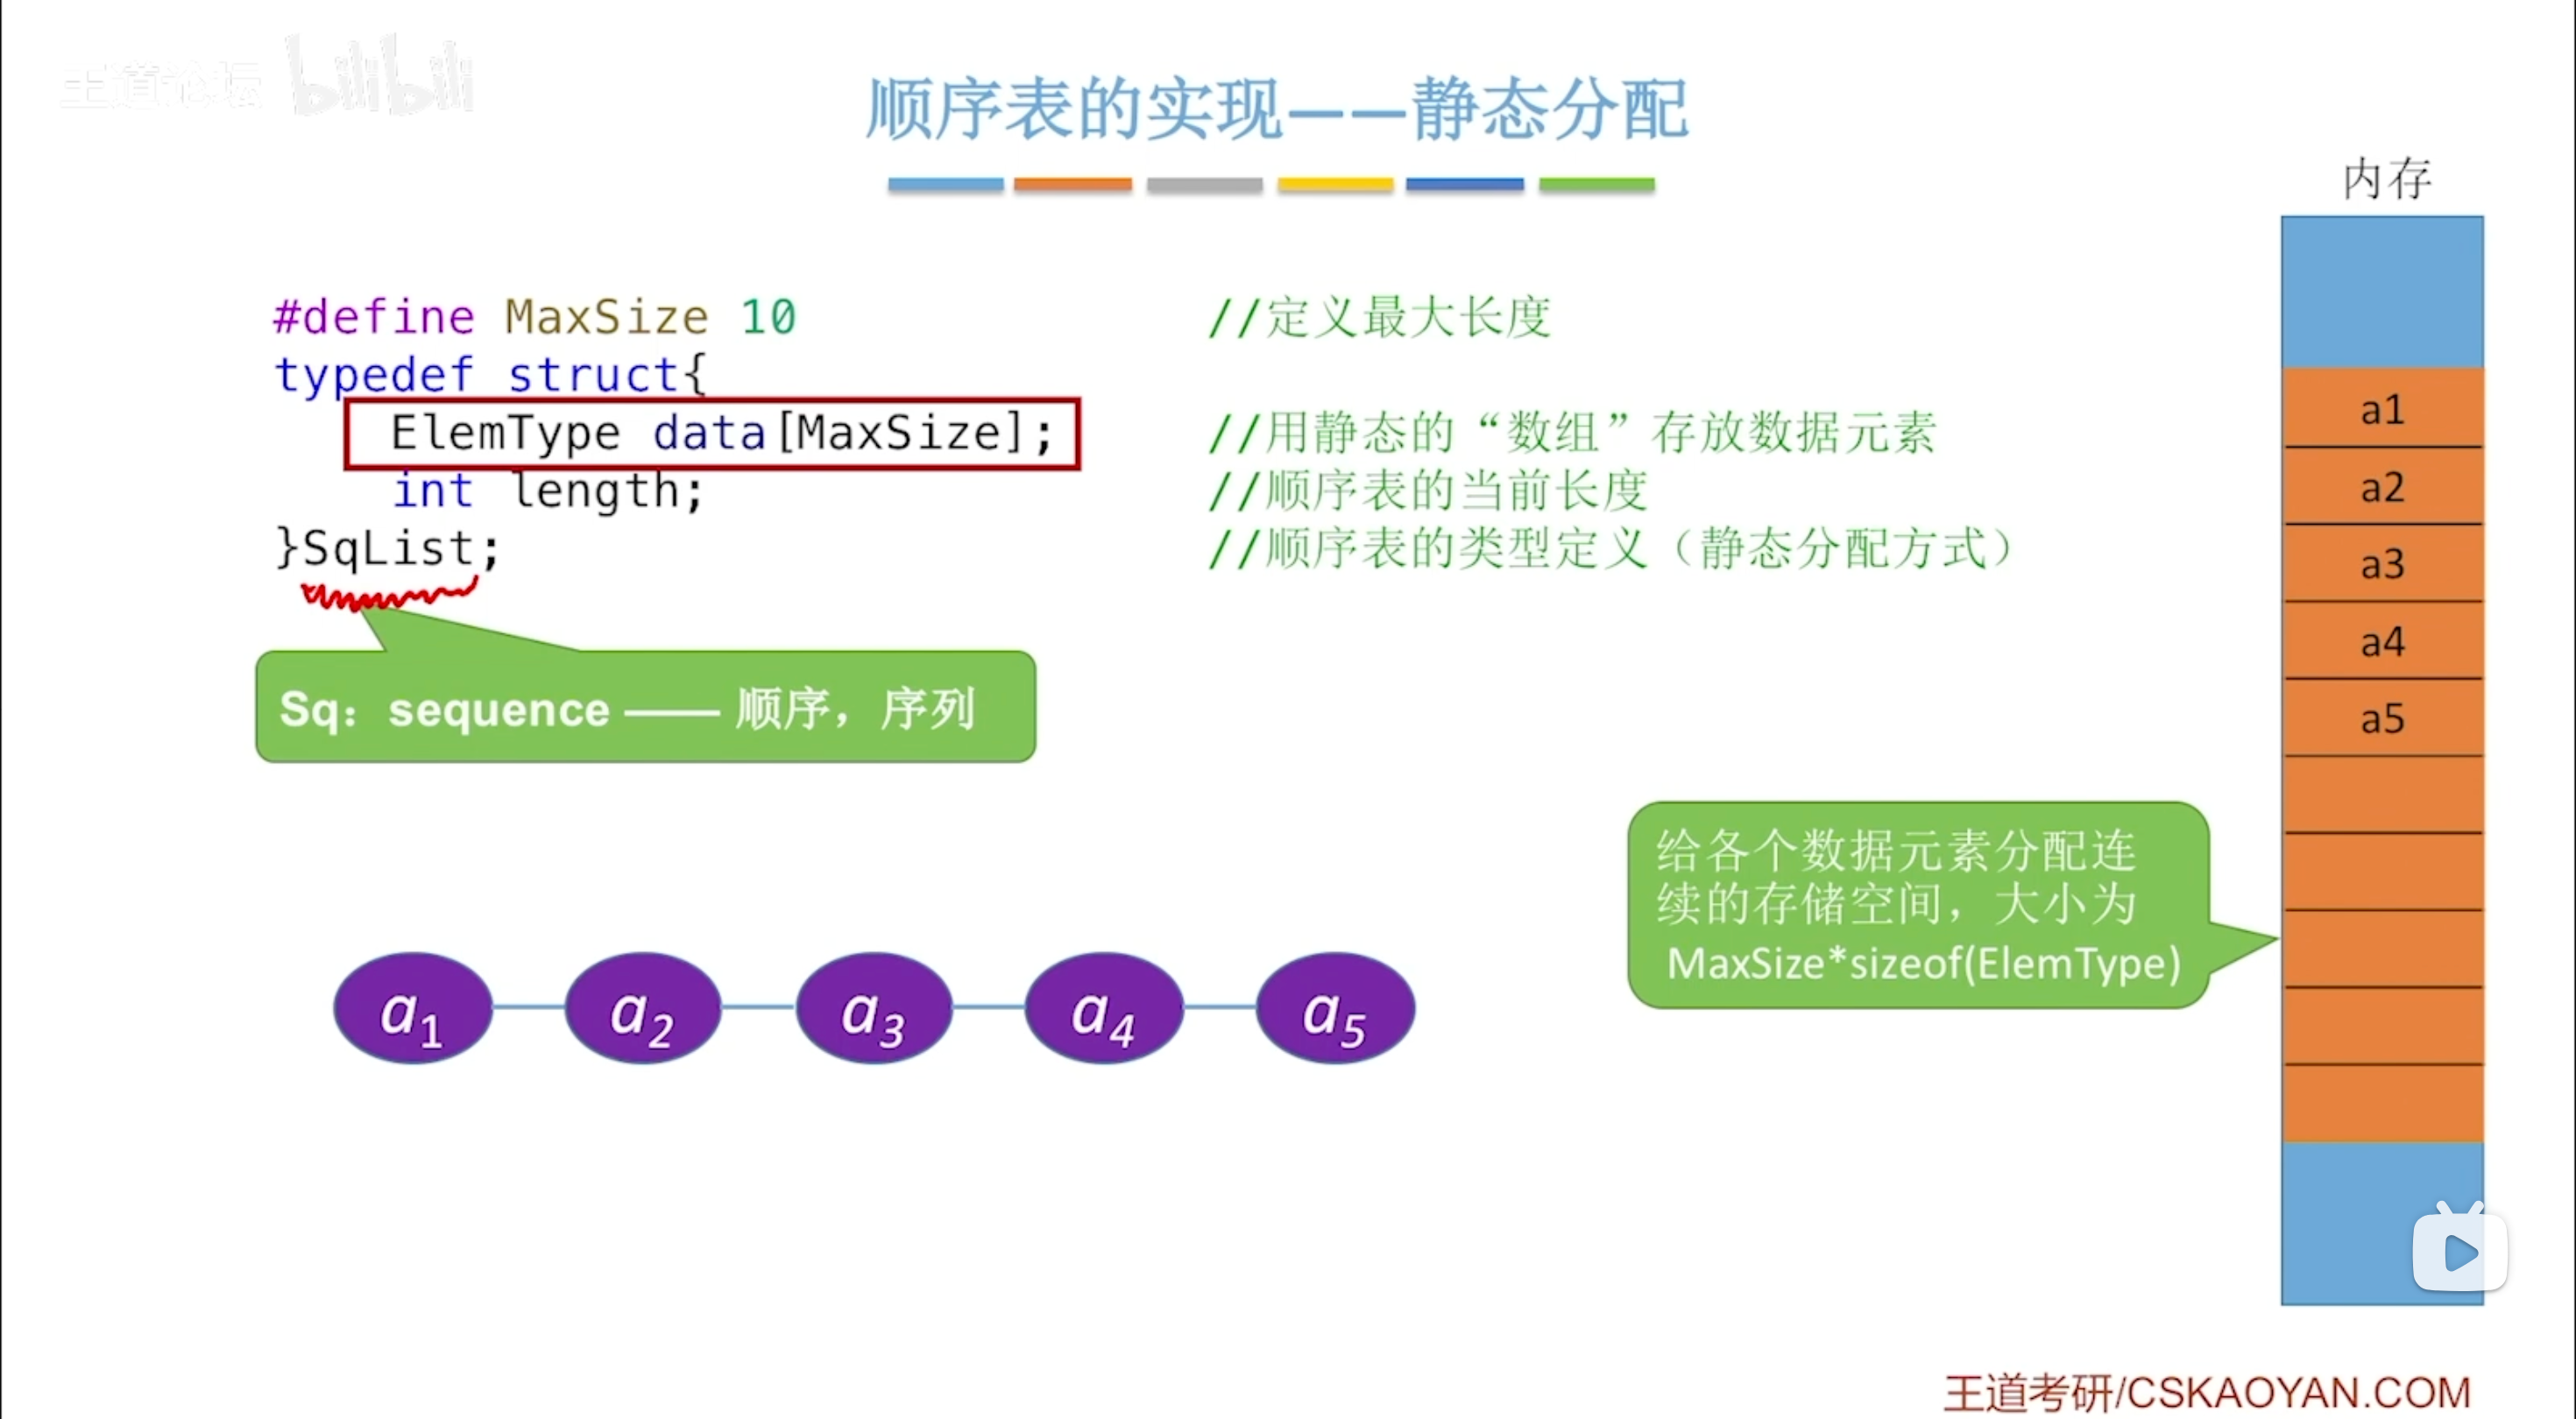
顺序表就是存续存储的线性表,代码实现非常简单,可能会考顺序表的查找,如果顺序表是有序的,顺序表在查找元素的时候可以进行折半查找,时间复杂度为 ,如果是按位置查找时间复杂度就是 ,如果是顺序查找,时间复杂度就是 。
顺序表增添或者删除元素的平均时间复杂度都是 ,因为顺序表可能要将第 个位置以后的元素都进行移动,最好是不用移动,最坏是移动 个元素,所以平均时间复杂度是 ,效率要比链表慢。
在初始化顺序表的时候我们只需要设置一下链表长度即可:
#include <stdbool.h>
bool SqList(SqList *L) {
	if (L == NULL) {
		return false;
	}
	L->length = 0;
	return true;
}
- 顺序表是一种采用顺序存储的线性结构,其元素在内存中必须连续存放。数组通常是顺序表的一种实现方式,因此在严格意义上也要求连续内存空间。不过,某些编程语言中的“数组”(如 Python 的 list)本质上是动态容器,并不完全等同于数据结构中的数组。
- 需要注意的是,数组虽然可以用于表示树等非线性结构,但这只是存储形式的差异,其逻辑结构仍由具体的数据结构决定。
- 与链表相比,顺序表无需额外的指针域,因此具有更高的存储密度。
- 注意一下,折半查找只能用于顺序表,链表无法使用顺序查找。
链表
链表有很多种,有不同的划分方法,可以分为带头节点的链表和不带头节点的链表,也可以分为单链表、双链表,循环单链表、循环双链表、静态链表等。
注意一下头节点和头指针,他们两个本身没有什么必然的关系,头结点不一定存在,但是头指针是一定存在的,只是带头节点的链表头指针一般都是指向头结点,但也不一定,主要看设计者的喜好,不带头节点的链表的头指针一般指向链表的第一个有元素节点
408 一般是考察带头节点的链表,不带头节点的链表可能在实际生产中用的多,但是实现起来稍微难一些,所以一般还是建议好好练习带头节点的链表的代码即可。
特殊的是静态链表,虽然考研似乎没有要求必须掌握静态链表的代码,要求掌握静态链表的操作逻辑和手动推理过程,但是静态链表的实现可以帮助我们理解如何在内存中实现链表,因为静态表本身就类似内存,我们会用到两个结构体,静态链表的代码相对复杂一些但是整体思想很简单。
接下来涉及到的都是带头节点的链表。
单链表
单链表是最简单的一种链表,他只有一个数据域和一个指针域:
typedef struct LNode {
	ElemType data;
	struct LNode *next;
} LNode, *LinkedList;
当我们要对单链表中的数据进行查找的时候,我们应该从他的头指针所指的那个节点开始遍历单链表,这个头指针所指的节点一般是头结点。
单链表本身没有什么特定的快速查找算法,一般不管是查找指定位置的元素还是查找元素的位置,都是需要顺序查找,也就是说时间复杂度为 。
但是如果是插入和删除操作,单链表的时间复杂度非常优秀,都是 ,这是因为单链表不用移动任何元素,而是改变节点的指针域,就可以完成链表的插入和删除。
初始化单链表也很简单,只需要将第一个节点的指针域设置为 NULL 就好了:
#include <stdbool.h>
#include <stdlib.h>
bool InitList(LinkedList *L) {
	L = (LNode *)malloc(sizeof(LNode));

	if (L == NULL) {
		return false;
	}

	L->next = NULL;
	return true;
}
之后就是构建单链表,构建单链表一般用两种方式:头插法和尾插法。
头插法时间复杂度为 ,但是头插法构建的单链表是逆序的,尾插法构建顺序的单链表,但是如果没有尾指针时间复杂度为 ,具体用哪一种方法构建单链表取决于具体的任务需求。
双链表
双链表的就是在单链表的基础上给每个节点都多加了一个指向上一个节点的指针,我们往往用 prev 表示,有了这个指针,链表就不仅仅可以一直往后,还可以访问前面的节点了,我见过很多贴近双链表的逻辑的东西,比如 MacOS 的窗口切换,当我们按下 cmd + tab 就会切换到下一个窗口,而我们之后再按下 cmd + 单个反引号 窗口就会切换到上一个窗口,并且 MacOS 的窗口似乎还是一个循环双链表,非常方便,切换窗口的速度也很快,你不必担心自己因为手速过快而切过了,因为你可以轻松访问上一个窗口。与之形成对比的是 Windows 的窗口切换,他的只能使用 alt + tab 切换到下一个窗口,一旦你切过了,你就只能继续往下切,知道循环回来到你想要的窗口上去,显然切换窗口的速度就没那么快,也不知道 Windows 什么时候改进一下。
同样的双链表还带来一个问题,MacOS 我们通常在切换窗口的时候,选中了窗口以后,在还未进入的时候可以使用快捷键 cmd + q 直接关闭窗口,这在逻辑上和链表删除操作一致,双链表的好处是,当我的指针指向了一个节点,我依旧可以轻松快速地完成对指向的这个节点的删除,时间复杂度仅为 ,但是单链表不是那么方便,当你指向了一个节点,你就没法直接完成对这个链表的删除,你得从头来,直到指针指向这个节点的上一个节点,最坏的情况下就是你的指针指向链表末尾的那个节点,而你刚好要删除他,总的来说平均下来时间复杂度就为 ,这可能就是为什么我没法用快捷键关闭 Windows 上的窗口吧,我得用鼠标点击,我严重怀疑我的鼠标和窗口的指针不完全是同一个指针,他们拥有不同的逻辑,鼠标更好用。
同样的插入节点也是双链表更加灵活,不仅仅一定要在某个节点后插入,也可以在某个节点前插入。
系统中双链表比单链表更为常见,但是具体用什么还是取决于实际场景,双链表比单链表操作更为方便,但是实现复杂度更高,需要占用更多空间,如果你只是想顺序查找,各种操作做的比较少,并且也想节省空间,那单链表依旧是很好的选择,遵守奥卡姆剃刀原则即可。
定义一个双链表:
typedef int ElemType;
typedef struct DLNode {
	ElemType data;
	DLNode *prev;
	DLNode *next;
} DLNode, *DLinkedList;
初始化双链表几乎和初始化单链表一样,单链表虽然简单但是是基本功,多加练习。
双链表的插入和删除的逻辑类似,一体两面,不多赘述,最后会在附录里附上完整的代码。
好吧我承认我有点刻板印象了,Windows 也可以双向,但是我竟然用了 10 多年都不知道这个操作,快捷键是
alt + shift + tab,那不能怪我,因为 Windows 也从来没给我一个快捷键说明书,我认为这是相当重要的
循环单链表
循环链表就是让链表首尾相连,形成一个环,这么做,你可以在链表的任意一个位置朝一个方向遍历,到达链表中的所有节点。这是很好的性质,你不必写逻辑判断,来判断是否这个节点之后没有节点了,要跳到头指针指向的那个节点去,他直接在逻辑上避免了这种判断,所以循环链表是理论上非常好的一种链表结构。
但是实际上我们在系统编程中不一定会大量实现循环链表,因为虽然循环很美好但是你也很容易写错,很容易写出死循环来。不过还是那句话,具体还是要看你的实际场景,循环问题(约瑟夫)、轮询调度(操作系统)、游戏回合系统、音乐播放列表(循环)之类的情况下,写循环链表是最好的选择。
不过要注意,我个人不是很喜欢循环单链表,当你拿到一个带有头指针的循环单链表的时候,你想给表尾插入一个节点虽然维护起来好一些了,但是时间复杂度并没有减少,依旧是 ,而带有头指针的循环双链表,给它尾部插入节点的时间复杂度则是 ,这种问题是挺爱考的,主要是理解循环单链表和循环双链表的逻辑区别。
循环单链表的结构体和单链表的结构体一模一样,但是初始化的时候有点不一样,你得让头指针指向的那个节点的 next 指针指向他自己:
#include <stdbool>
#include <stdlib>
bool InitList(CLinkedList *L) {
	*L = (CLNode *)malloc(sizeof(CLNode));

	if (*L == NULL) {
		return false;
	}

	(*L)->next = L;

	return true;
}
循环双链表
和循环单练表类似,结构体定义也和双链表一致,初始化除了 next 指针要设置为指向自己,prev 也得指向自己:
#include <stdbool>
#include <stdlib>
bool InitList(CDLinkedList *L) {
	*L = (CDLNode *)malloc(sizeof(CDLNode));

	if (*L == NULL) {
		return false;
	}

	(*L)->prev = L;
	(*L)->next = L;

	return true;
}
静态链表
静态链表并不依赖于实际的指针,而是利用数组下标作为“虚拟指针”,实际写起来就像是给内存实现指针一样,线性表里面,静态链表的代码应该是最复杂的了,但是一个严谨的静态链表大概也就是 200 行代码。考试一般不会特意考察静态链表的代码,更多的是考一考逻辑,不过我觉得学习静态链表很有意义,因为他能帮助我们更好地理解指针的本质与作用,有助于我们后续的学习。